元数据即本体 从一句自然语言到可运行表单的确定性编译之
原创
元数据即本体 从一句自然语言到可运行表单的确定性编译之
原创
OneCode
发布于 2026-11-02 12:19:44
发布于 2026-11-02 12:19:44
前言
大模型直接“画”表单很容易,难的是画出来的表单敢提交、敢入库、敢跑流程。本文以我们自研的 OUC 引擎与 formAgent 为解剖标本,讲清楚一件事:NLP 从不直接生成表单,它只生成“符合本体的意图”;字段类型、组件形态、主子结构、勾稽校验,全部由元数据本体裁决,最终被确定性编译成页面与三层 Java 代码。这是一条把“概率性生成”关进“确定性笼子”的完整工程路径。
2026 年 11 月 · 架构深读
〇、两种编译:概率性与确定性之间隔着一层本体
让大模型“生成一个报销表单”,是今天几乎所有低代码 + AI 产品的标配演示。难点不在演示,而在第二次点击保存按钮之后发生的事:字段有没有明确的 Java 类型和 SQL 类型?金额精度会不会被当成字符串存进数据库?主子表结构是真实的 1:N 外键,还是一坨 JSON 文本?“报销金额不能超过预算”这类业务勾稽,是写在提示词里的祈祷,还是引擎里可执行的约束?
业界通行的两条路线各有软肋:
路线 | 做法 | 软肋 |
|---|---|---|
LLM 直出 UI | 提示词里塞组件库文档,让模型直接输出页面代码/JSON | 概率性:同一句话两次生成结果不同;类型、校验、关系全靠模型“记性好”,无 SSOT,无法对账 |
纯模板低代码 | 用户在画布上拖拽,元数据由人工逐字段录入 | 确定性有余而智能不足:自然语言到表单结构之间隔着巨大的手工录入成本 |
我们的解法是在两条路线之间插入一层元数据本体(Metadata Ontology),把整个问题改写成一次两段式编译:
核心命题
自然语言 →(NLP 压缩,概率性)→ 本体意图 →(元数据裁决,确定性)→ 表单与代码。LLM 的输出被严格限制在“意图”这个薄层——模块名、字段名、业务角色;而它不能说什么类型、选什么组件、建什么关系,这些裁决权完全收归元数据本体。本体即律法,NLP 只是当事人陈述。
下文按这个命题展开:第一章给出三层本体栈的全景;第二章看词汇表(财务字典)长什么样;第三章回答“NLP 如何转换为专用的表单设计、元数据在其中起什么作用”;第四、五章分别解剖字段类型与勾稽关系这两类语义在 OUC 引擎上的智能转换;第六章给出 formAgent 的工程边界;第七章是真实链路上踩出来的教训。
一、三层本体栈:词汇表、模型与映射
把系统里散落的能力按本体论的视角重新归位,会得到一个清晰的三层结构。这不是事后包装的概念,而是三批真实存在的代码与数据——它们本来就在那里,只是过去各自为政。
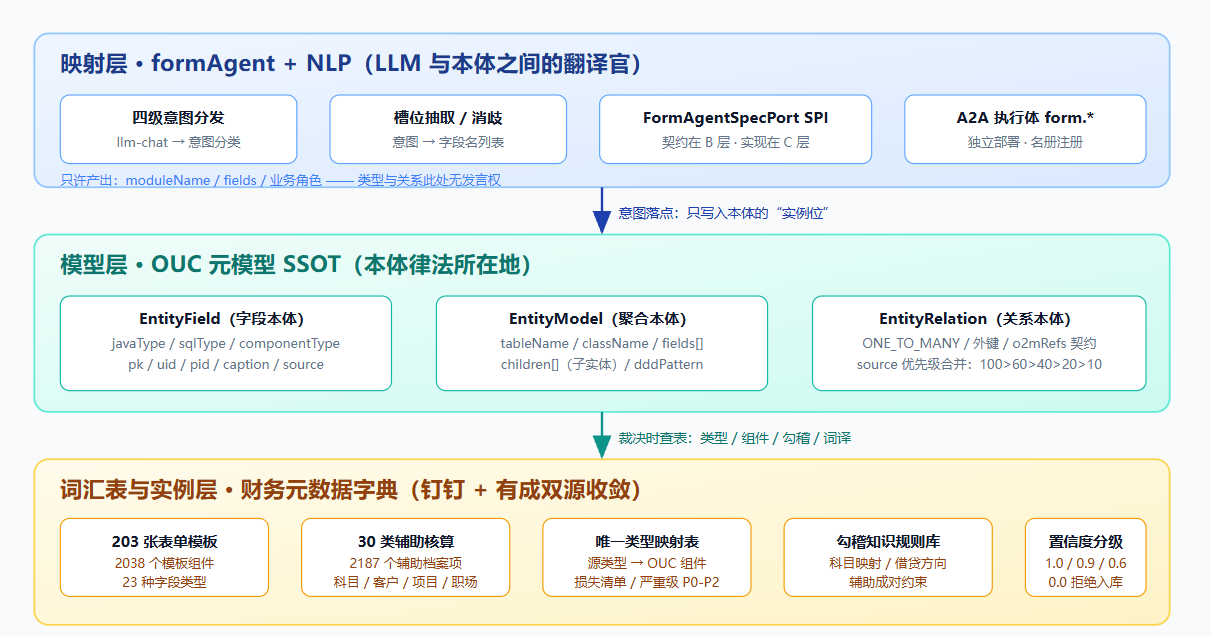
图 1 | 三层本体栈:上层只许“说话”,中层负责“裁决”,下层提供“词汇与事实”
三层的分工可以用一句话概括:词汇表层回答“世界上有哪些词”(科目、辅助核算、字段类型),模型层回答“词与词之间有什么律法”(类型映射、关系约束、合并优先级),映射层负责“把人话翻译成律法允许的陈述”。任何一层越权,系统就会退化成“LLM 直出 UI”的老问题。
二、词汇表与实例:财务字典是一个“诚实的本体”
本体工程最容易被忽略的部分不是模型,而是实例从哪来、可信度如何标注。我们的财务字典从两个外部系统收敛:钉钉(组织架构、角色组)与用友·有成(科目、辅助核算档案、表单模板、项目、银行卡、付款账户)。收敛不是简单的数据搬运,而是一套带置信度分级的知识工程:
置信度 | 含义 | 典型样本 |
|---|---|---|
1.0 | 接口原值直取,未做任何推断 | 部门树、银行账户、辅助档案项 |
0.9 | 接口原值 + 规范化推导 | 由 parentId 递归生成的部门全路径 |
0.6 | 语义映射 / 派生结论 | “字段类型 → OUC 控件”这类映射判断 |
0.0 | 被权限拒绝 / 不可用 | 钉钉审批表单 schema(缺 Workflow.Form.Read,403)——记录在案,不编造 |
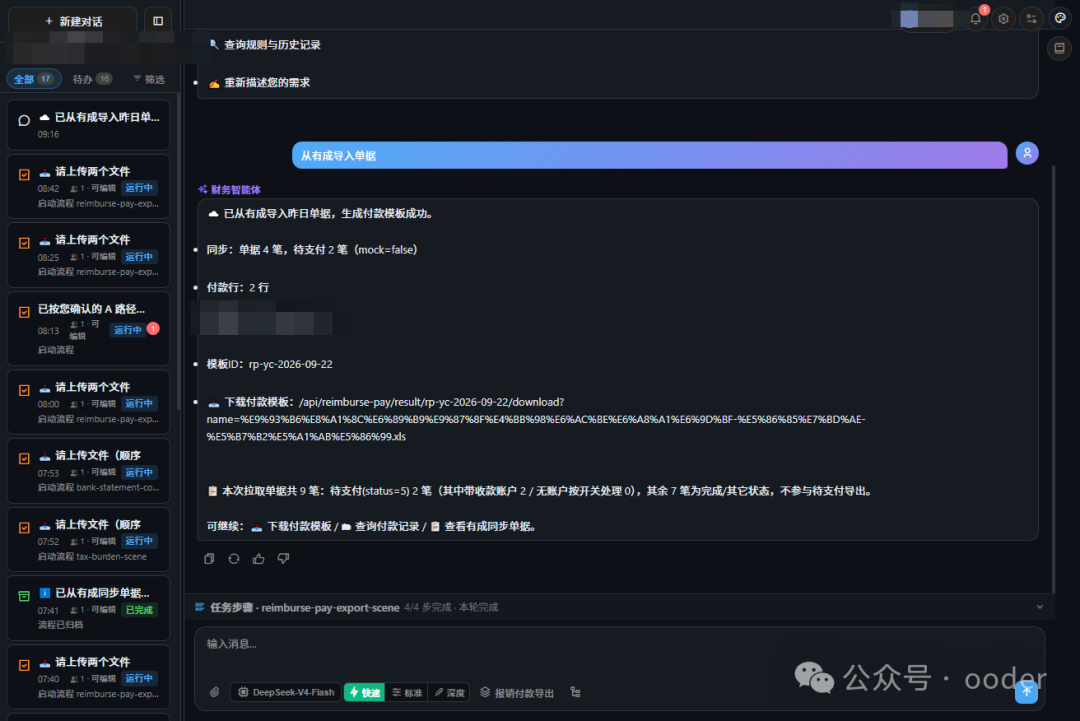
图片
图 2 | 外部词汇表的对话式接入:财务智能体从有成拉取单据与支付数据、生成模板。字典的“实例”正是通过这类通道持续流入,并带上 mock=false 的真实性标记。
这套字典里最有架构价值的一份资产,是 field-type-map.json——外部表单类型到 OUC 组件的唯一映射矩阵。它不只记录“谁映射到谁”,还为每一条映射标注三个维度:支持度(有/部分/无)、严重级(P0 语义丢失 / P1 信息降级 / P2 仅布局影响)、以及最关键的——元数据损失清单。例如:
amount→ood.UI.Input(currency):支持,但 maxLimit/minLimit/showUnit 丢失(163 处);auxiliaryItem→ood.UI.ComboInput(@ComboPop):支持,但辅助核算类别与候选项丢失(216 处)——这是 P0,因为辅助核算类别是有成校验借贷凭证能否过账的硬约束;dateMerge(起止区间):被旧转换函数直接丢弃(114 处),P0。
为什么“损失清单”是本体的美德
多数转换器丢信息是静默的——字段悄悄变成 text,类别悄悄消失,等业务发现时数据已经被污染。把损失显式写成清单并给出影响面计数(如“216 处公司模板受影响”),意味着本体在每一次翻译中对自己诚实:哪些语义保真、哪些降级、哪些必须人工补录,全部可审计、可排期修复。
三、NLP 如何把一句话压进本体:元数据在表单设计中的真实作用
现在回答第一个核心问题。NLP 转换为专用表单设计的完整流水线分五个阶段,LLM 只在前两个阶段出场,且出场方式被严格约束:
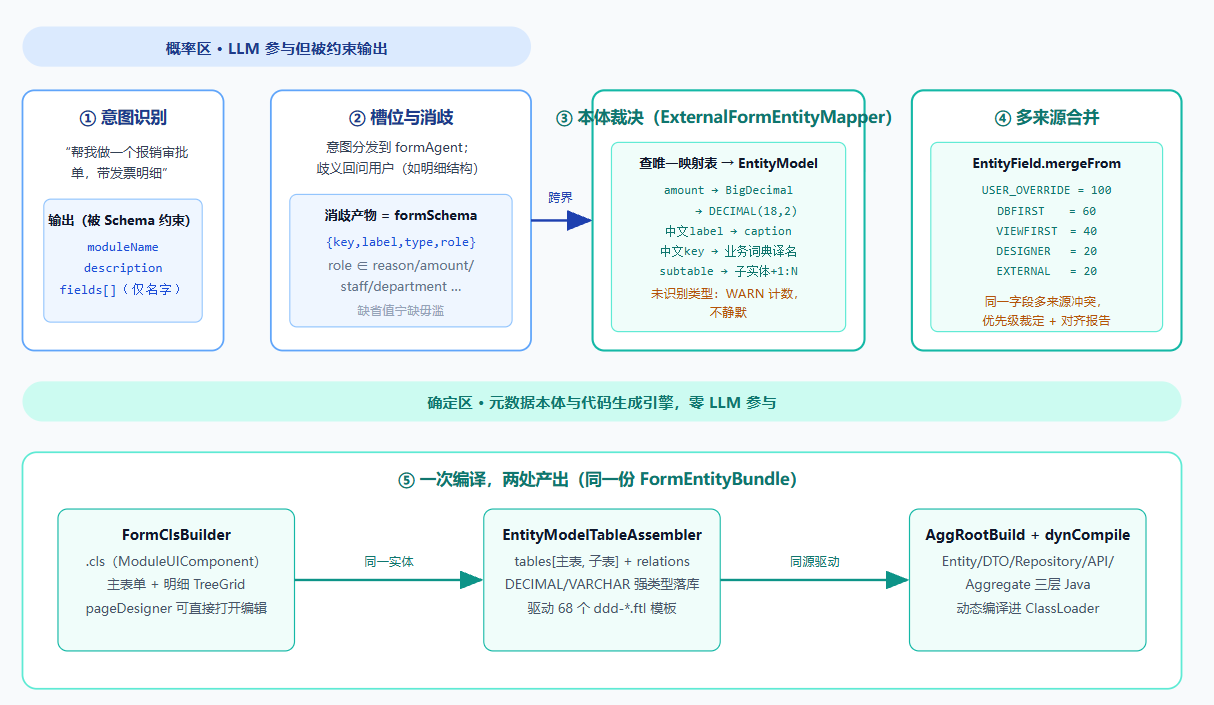
图 3 | NLP → 表单的五阶段流水线:LLM 只在①②出场;③④⑤完全由元数据本体与生成引擎裁决
3.1 元数据在此过程中的四重作用
回头看“元数据在这其中起到了什么作用”,可以归纳为四点,每一点都对应一条不可绕过的工程红线:
- 词汇约束(Vocabulary Constraint)——LLM 只能从 formSchema 的有限槽位说话:key、label、type、role。它说不出“DECIMAL(18,2)”这种持久化细节,也无需说出——这从根上消除了模型幻觉类型的风险。
- 类型裁决(Type Adjudication)——
amount → BigDecimal/DECIMAL(18,2)这类映射由唯一映射表决定而非模型判断。这里有一个极具戏剧性的对照:OUC 早期 NLP 管线里的guessFieldType()靠字段名关键词猜类型(“日期”→date、“金额”→number),而在财务域走的是查表 + 业务词典(BusinessNaming,如“报销审批单→ExpenseClaim”,词典覆盖不到就返回 null,绝不猜)。从“猜”到“查”,正是从概率生成走向本体裁决的分水岭。 - 冲突消解(Conflict Resolution)——真实企业里同一字段必然多来源:数据库有列、设计师配过、外部表单又导了一份。source 优先级合并(USER_OVERRIDE > DBFIRST > VIEWFIRST > DESIGNER_FIRST > EXTERNAL_FORM)让每一次合并结果可复现、可对账,并产出 FormAlignmentReport 留痕。
- 同源双产(Single-Source Dual Output)——一份 EntityModel 同时产出页面 .cls 与三层 Java,页面与后端不存在漂移。若走“页面为源、反推后端”的 U2C 路线,.cls 是纯 UI 结构不含 Java 类型/主外键,必须绕一圈把类型塞回去——这正是当初路线评审时放弃 U2C 的决定性理由。
一个真实样本的完整落点:钉钉“报销审批单”flow(formSchema 无 title,命名输入源按
entityClassName → title → flowId 去壳降级)→ 主实体ExpenseClaim(表 expense_claim,12 列 = 3 系统字段 + 8 业务字段 + 1 附件)+ 子实体InvoiceDetail(含税金额按列名语义判为 DECIMAL(18,2))+ 1 条 ONE_TO_MANY 关系。真实写盘 18.7KB 的 .cls,平台ModuleUIComponent解析通过——designer 直接可编辑。
图片
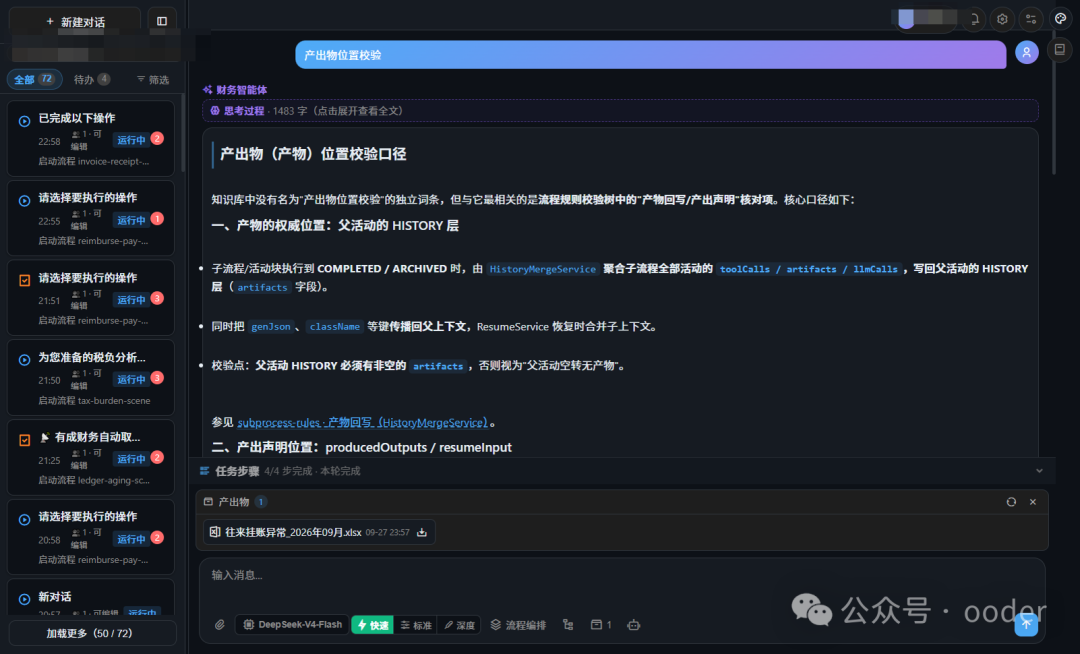
图 4 | 运行时视角:智能体的“思考过程”与“产物(artifacts)”在对话中留痕。生成产物必须可校验位置与归属——这是本体系统能被审计的前提之一。
四、字段类型在 OUC 上的智能转换:从数据类型到控件本体
第二个核心问题的一半在这里:表单字段的数据类型如何被智能转换。“智能”二字常被误解为“AI 猜得准”,但在工程语境里,智能体现在映射体系的分层完备——简单类型走直映射,复杂语义走机制组合,覆盖不到的走诚实降级。
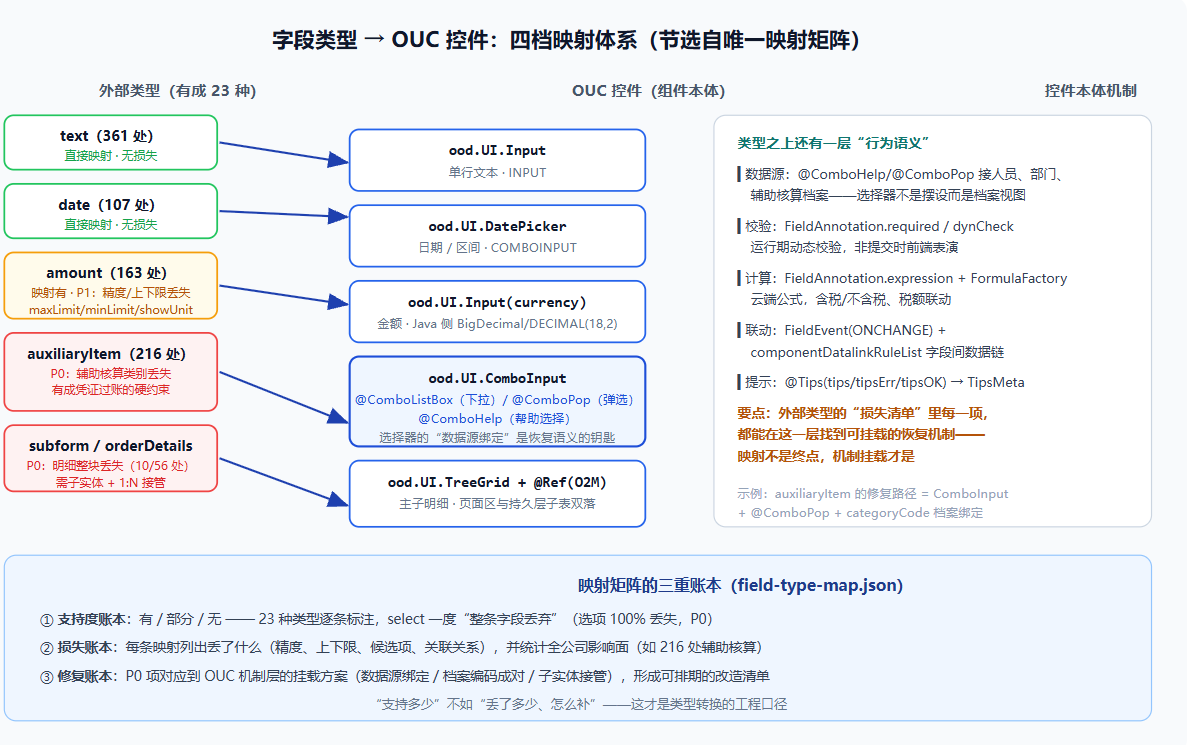
图 5 | 字段类型的四档映射体系与 OUC 控件机制层:类型映射只是第一步,机制挂载才是语义恢复的完成态
4.1 “智能转换”的真正含义:三段式
把金额、辅助核算这类财务字段的转换过程拆开看,“智能”其实是三段确定性逻辑的组合,任何一段都不需要模型在线判断:
- 第一段 · 源语义解析:外部模板的
configureObject.type + code是权威输入。类型映射的唯一表与导入工具的 TYPE_MAP 同源维护——两处口径一旦分叉,单测会抓住(真实案例:测试抓出ComponentType.MULTILIST根本不存在,正确映射是 select→LIST、date→DATEPICKER)。 - 第二段 · Java/SQL 强类型绑定:
amount → BigDecimal → DECIMAL(18,2)。这里曾修掉一个隐蔽缺陷:持久层装配器直接switch(sqlType),而实体的 dbType 带精度(如DECIMAL(18,2)),导致金额列全部落进 default 分支变成Types.VARCHAR——金额被当字符串存库。修法是先剥离括号再判型。类型本体的每一环都必须“带精度感知”。 - 第三段 · 控件行为挂载:金额控件不只是 Input(currency),还挂
expression公式(含税/不含税换算)与dynCheck上下限;辅助核算控件挂@ComboPop+ categoryCode 档案绑定。控件本体的机制层(图 5 右侧)才是语义恢复的主战场。
五、勾稽关系的编译:从业务不变量到 @Ref(O2M)
“勾稽关系”在会计语境里指凭证与凭证、凭证与单据之间必须满足的数字与逻辑对应关系。在表单系统的语境里,它泛化为三类结构约束:主子表 1:N、辅助核算成对、借贷方向与金额平衡。这三类在 OUC 上各有独立的编译通道,这也是第二个核心问题的另一半答案。
5.1 主子表 1:N:一条曾经断裂的“闸门”
最有代表性的是 1:N。表单上的明细区(如报销单的开票明细)如何在持久层变成真实的子表?我们的答案是六段全链路:
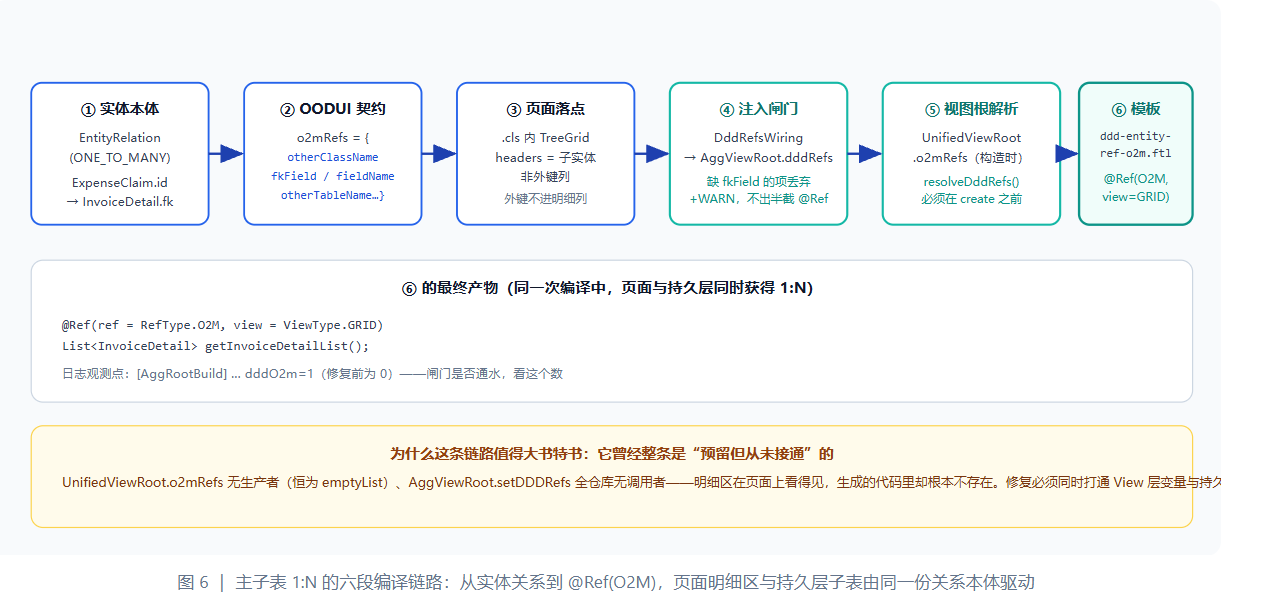
图 6 | 主子表 1:N 的六段编译链路:从实体关系到 @Ref(O2M),页面明细区与持久层子表由同一份关系本体驱动
5.2 辅助核算成对与借贷方向:财务域的勾稽知识库
1:N 是通用勾稽,财务域还有一批强业务不变量。它们以知识规则库的形式存在(与实现代码同源维护,改实现必须同步规则文件),举三个例子:
- 辅助核算成对约束:有成要求科目声明的核算类别辅助“成对齐全”——项目/职场科目只填其一,凭证必被拒绝(“科目关联辅助项目的数量与表格匹配的数据不一致”)。这条规则决定了表单字段建模时,
projectCode与workplaceCode必须作为成对字段组而非独立字段; - 科目判定的字段优先级:银行流水的科目判定走 备注 → 附言 → 用途 → 业务类型 → 摘要 的固定优先级,禁止仅凭摘要或金额猜测科目——这是把“LLM 不许越权裁决”从类型映射延伸到了业务语义层;
- 流程自检节点:出报表前强制检测空科目,命中即进入出纳核对环节,不允许绕过。勾稽校验不是表单提交时的一次性动作,而是编排进流程的活动节点。
勾稽在 OUC 上的三种编译形态
① 结构形态——1:N 关系编译为 @Ref(O2M) + 子表外键;② 控件形态——required/dynCheck/expression 编译为字段级行为,FieldEvent/ONCHANGE 编译为字段间联动;③ 流程形态——成对齐全、空科目自检这类跨字段/跨单据校验,编译为流程定义里的检查活动。三类形态共享同一份勾稽知识库,避免“前端一套规则、后端一套规则、流程又一套规则”的漂移。
六、formAgent 的边界:本体的“执法权”属于谁
本体再完备,也需要回答组织问题:这套语义裁决能力放在哪个模块、由谁部署、对谁负责?我们的答案是表单中心 Agent(formAgent)——一个依托 OUC 核心架构、可独立部署的领域,并画出了严格的 A/B/C 三层边界:
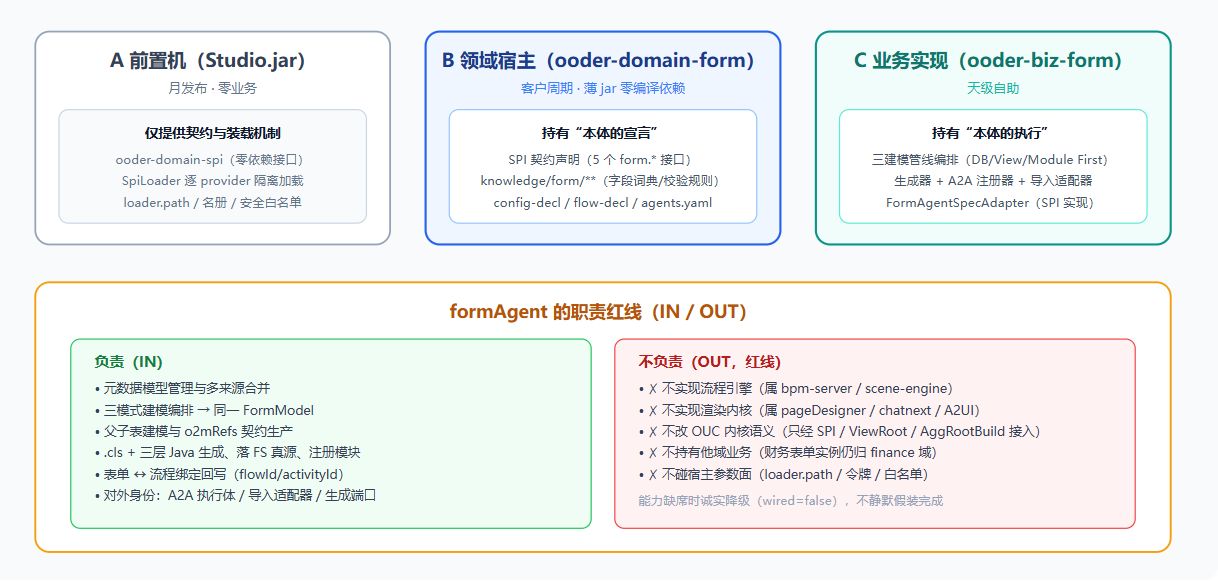
图 7 | formAgent 的 A/B/C 三层归属与 IN/OUT 红线:本体宣言在 B 层,本体执行在 C 层,宿主只装契约
三条建模管线(DBFirst 已有库表反推 / ViewFirst 视图描述正推 / Module 元字段直建)在此架构下殊途同归:只在“表单怎么来”上分叉,产出完全同构的 FormModel。首个落地模式选择了 Module(元字段)——因为它离 NLP 的输出形态最近,是“一句话进本体”的最短验证路径。
七、工程教训:本体系统在真实链路上的四次“打脸”
单测全绿从来不等于真实链路可用。以下四个真实发生的问题,每一个都是对“元数据即本体”命题的残酷补课:
# | 现象 | 根因 | 教训 |
|---|---|---|---|
1 | 首次真实生成即抛错:无法从 title 推导实体名 | 此前所有测试样本都带 title,而真实产物的 form-schema.json 只有 flowId——构造样本掩盖了输入差异 | 本体入口要定义命名输入源优先级(entityClassName → title → flowId 去壳),并假设最坏输入 |
2 | 生成端口报 CODEGEN_MODULE_NOT_FOUND | 只落了 FS 真源、未注册为平台模块——端口按 getModule 取模块再渲染 | “产物存在”与“产物可被平台发现”是两回事;注册动作必须成为生成链的内置步骤 |
3 | 真实链路 dddO2m=0,1:N 静默失效 | /api/nlp/integrate 会重建模块:18676 字节的 .cls 被系统重写为 10466→8485,写进 dsmProperties 的 llmMeta.o2mRefs 在重建中丢失 | 本体的数据也会被平台流程“冲刷”;修复是把 o2mRefs 回写放在 saveModule 之前的最后一刻,且以平台当前 llmMeta 为基底幂等合并 |
4 | 编译报错落在从未改过的文件上 | 并行任务改了上游模块但未 install,编译期依赖的是本地仓库的旧 jar | 改上游模块必须 install;“改了没生效”先查依赖版本,再怀疑自己的代码 |
第 3 条尤其值得展开:它揭示了元数据系统的一个深层矛盾——本体希望数据有唯一权威源(SSOT),而平台的长流程会不断重建、规范化、重写这些数据。解法不是禁止重建,而是把关键本体数据的回写点精确放在“所有重建都结束后、最终持久化之前”,并做成幂等合并。这个模式可以推广为一条定律:在多阶段流水线里,本体数据的注入点必须晚于最后一次破坏性变换。
八、结语:本体立场——确定性是对业务的尊重
回到最初的两个问题,现在可以给出完整的答案。
NLP 如何转换为专用的表单设计,元数据起到了什么作用?——NLP 通过意图识别与槽位抽取,把自然语言压缩为一个被 Schema 约束的 formSchema 意图;元数据本体随即接管全部设计决策:唯一映射表裁决类型与组件,业务词典裁决命名,source 优先级裁决多来源冲突,EntityRelation 裁决主子结构。元数据的作用不是“辅助 NLP”,而是充当表单设计的唯一立法机关——LLM 是证人,本体是法官。
字段类型与勾稽关系在 OUC 上如何实现智能转换?——类型转换是“直映射 → 强类型绑定 → 控件机制挂载”的三段确定性逻辑,配合对元数据损失的诚实记账;勾稽关系则编译为三种形态:结构形态(@Ref(O2M) 主子链路)、控件形态(required/dynCheck/expression/联动)、流程形态(自检活动节点)。所谓“智能”,不是模型的神来之笔,而是映射体系的分层完备 + 损失的可审计 + 机制的可挂载。
这套架构的哲学可以压缩成一个立场声明:在业务系统里,概率性生成负责降低表达门槛,确定性本体负责守住业务底线。表单是要提交、要入库、要过账、要审计的——它的每一个字段类型、每一条勾稽关系,都必须有出处、有依据、可追溯。这,就是我们把元数据当作本体来经营的全部理由。
文中数据与代码事实来源:OUC 引擎(ouc-core)的元模型与代码生成链路、data/finance-dictionary 字典与类型映射矩阵、ooder-domain-finance 勾稽知识规则库、formAgent 设计与边界规范(2026-10-11)及 entityfield → OUC 生成方案执行记录(2026-10-10)。文中截图已脱敏。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号