TriviumDB 0.9.0 ANN 实测:在 90% 召回率下比较三档向量检索
原创
TriviumDB 0.9.0 ANN 实测:在 90% 召回率下比较三档向量检索
原创
晨星成焰
发布于 2026-11-06 16:47:48
发布于 2026-11-06 16:47:48
现在TDB更新到了 0.9.0 正好最近有空 跑了一下 ANN实测 做向量检索性能比较时,只看最高 QPS 很容易把不同召回率的结果放到一起。对需要把检索结果交给后续模型或图查询的应用,更有参考价值的问题是:在目标召回率相同的条件下,各索引能处理多少查询?
本文围绕这个问题,复核 TriviumDB 0.9.0 内置向量索引 QuIVer 的一组 ANN 测量,并与 hnswlib、FAISS-HNSW 对照。测试覆盖三个嵌入向量维度;在这台机器、这些数据集和记录的参数下,TriviumDB 在目标召回处的 QPS 分别为 hnswlib 的 2.51×、2.20× 和 2.99×。
这是一组有明确边界的观测:它测量的是 Rust 内存索引的 ANN 路径,不是 Python 客户端、TQL 混合查询或应用端到端请求的吞吐。不同批次与历史波动也会在后文说明。
先看结果:按召回率对齐 QPS
数据集规模 | TriviumDB QPS | hnswlib QPS | FAISS-HNSW QPS | TriviumDB / hnswlib |
|---|---|---|---|---|
384d / 1M | 119,554 | 47,544 | 46,862 | 2.51× |
768d / 1M | 48,154 | 21,867 | 20,706 | 2.20× |
1536d / 990K | 34,377 | 11,485 | 11,684 | 2.99× |
表中 QPS 是在 cosine R@10 = 90% 处,沿召回率轴线性插值得到的结果;倍数用未取整结果计算。每个引擎在对应数据集上都独立构建了 3 次索引:先对每个搜索参数点取各轮中位数,再在中位曲线上插值。
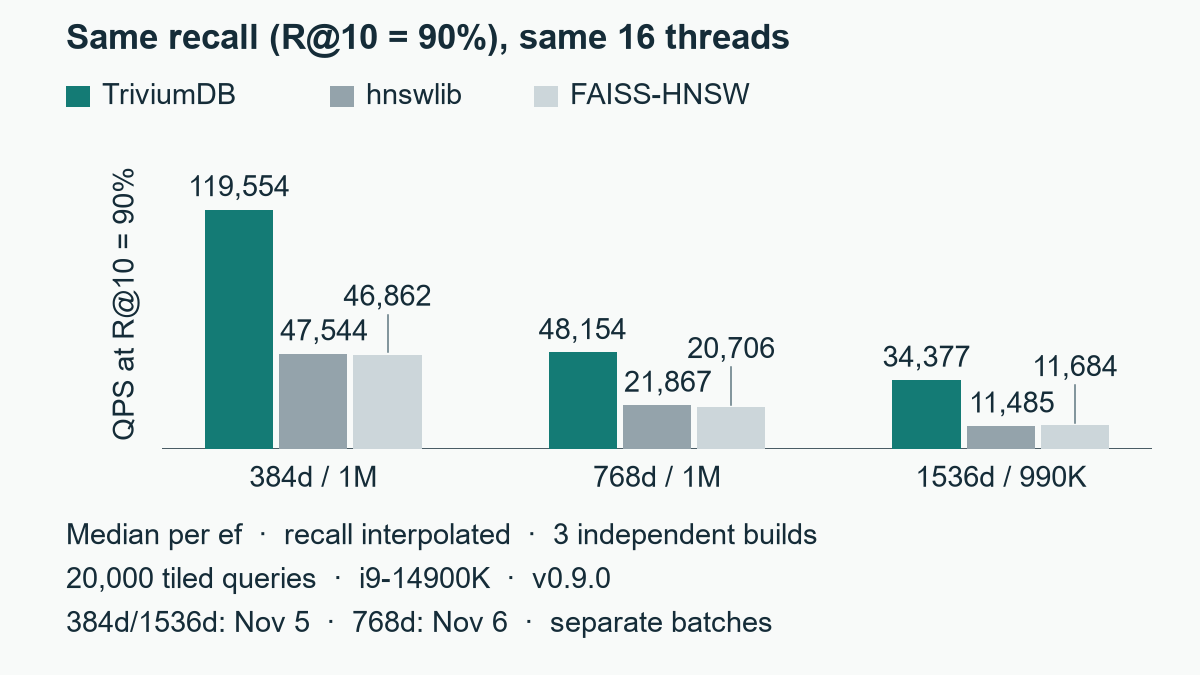
图一:相同目标召回率下的三引擎 QPS
这里的“对齐召回”不代表不同算法使用完全相同的搜索参数。各库分别扫描参数,再在各自曲线上找到目标召回处的插值位置;它也不等于从某个搜索参数点挑出最高 QPS。
测量条件与适用范围
测试在同一台 Intel i9-14900K、64 GB 内存、Windows 11 机器上进行,三个引擎均使用 16 线程。HNSW 使用 M=32、ef_construction=128;TriviumDB 的对应构建参数为 m=32、ef_c=128。数据集使用 cosine 口径,目标指标为 R@10。
每次完整查询批次包含 20,000 条平铺后的查询条目。平铺用于延长计时窗口,不应理解成 20,000 条彼此独立的新查询。ground truth 在预检中通过抽样精确对拍;这项抽样不等于对每条查询都重新执行了精确搜索。
两个批次需要明确区分:384d 与 1536d 结果来自 11 月 5 日的 v3 采集,768d 结果来自 11 月 6 日的定向重跑。它们使用同一机器和记录的参数,关键输入、库文件和可执行文件的边界哈希经过核对,但并非同一时段运行,也不是配对实验。入场资源检查和运行记录不能证明全过程没有后台干扰。
计时和预热过程也并不完全相同:TriviumDB 的查询计时包含 ground-truth 命中统计,两个基线的查询计时不包含召回计算;两个基线在每个 ef 计时前用 10 条查询预热,TriviumDB 在 ANN 扫描前运行 Exact Flat,但没有专门的逐 ef 预热。这些是解读 QPS 时需要保留的条件;数值不应直接外推成应用端到端延迟。
建图时间:三次独立构建的中位数
数据集规模 | TriviumDB | hnswlib |
|---|---|---|
384d / 1M | 38.9 秒 | 107.2 秒 |
768d / 1M | 48.2 秒 | 176.4 秒 |
1536d / 990K | 84.6 秒 | 379.5 秒 |
这是本次各引擎 3 次独立构建的时间中位数,不应与只建一次索引的旧结果混在一起,也不代表所有数据分布、硬件和参数下都有相同建图差距。
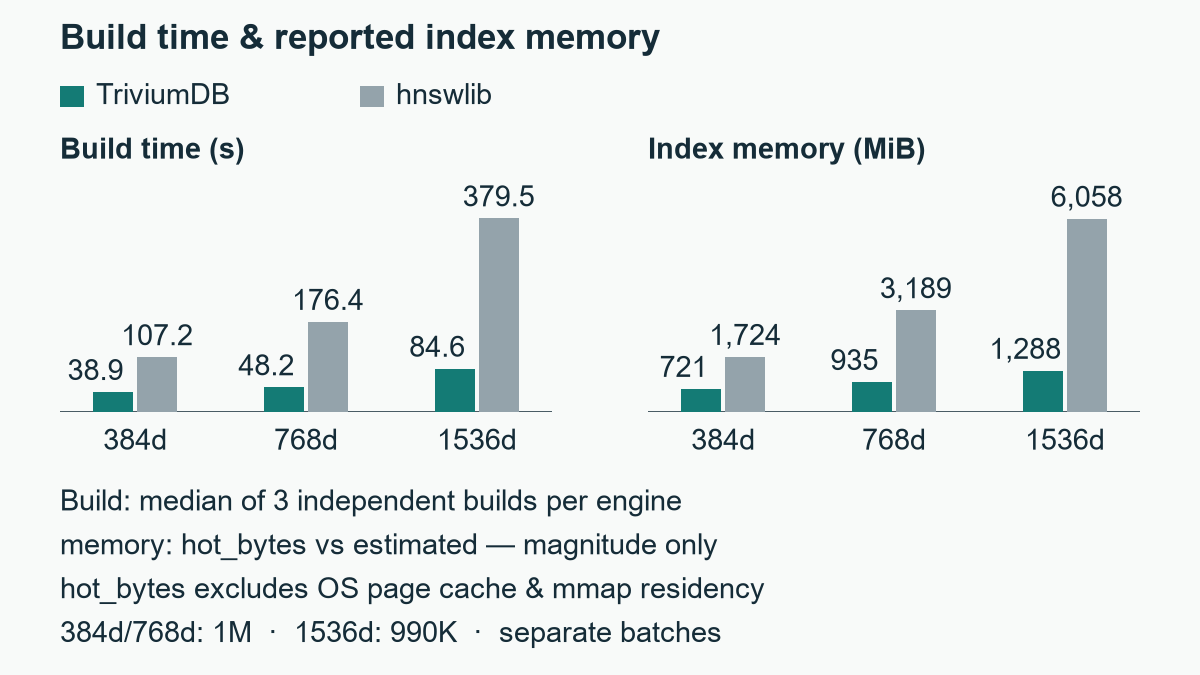
图二:建图时间与分别标注口径的内存数值
图中的内存需要特别注意:TriviumDB 报告的是 hot_bytes,不包含操作系统页缓存与 mmap 常驻;hnswlib 数值是公式估算。这两者不是相同的内存测量口径,图中只能作为带标签的量级参考,不能据此推导精确的内存节省倍数或进程总内存差距。
波动、边界与尚未解决的事项
本次 768d 定向批中,TriviumDB 在目标召回附近的插值邻点相对稳定,但其他 ef 档位仍有超过 8% 经验筛查线的查询波动。更早的 v3 批次中,该组在当时预注册的逐 ef 硬门槛下有 3 次完整尝试未通过。后续将 8% 定位为复查旗标是对既有数据的事后重新解释,不是原预注册门槛已经通过,也不能证明波动根因已消失。所有尝试及原始记录均保留在证据中。
3 次构建足以给出本批的中位数;本批未计算置信区间,三次样本也不足以精确刻画波动或所有环境下的稳定性。三个数据集展示的是这次所测 LLM embedding 工作负载,不代表对任意向量数据全面领先。
边界同样需要保留:在本次 SIFT-128 扫描中,TriviumDB 未达到 R@10 = 90%;对未达到的点不做外推,也不把它算作优势结果。如果工作负载以低维直方图向量为主,应使用自己的数据集和目标召回率复测。
这组 ANN 数字也不解决项目中仍开放的其他问题:管线 provenance 对照 #86、release 故障测试编译 #87、Windows SOAK 工作集检查 #89。它们不等于本次 ANN 指标被证明错误,但也不能从 ANN 结果推断这些事项已经修复,或声称全部测试通过。
TriviumDB 能力和继续复核
TriviumDB 是用 Rust 编写的嵌入式三模数据库,提供向量、属性图和文档型元数据能力。它可以作为进程内组件使用,不需要为本次演示启动独立数据库服务器。实际存储文件取决于模式:默认 Mmap 会使用多个文件,不能把所有配置概括成“单文件”。
Python 包可从 PyPI 的 0.9.0 版本页面查看;包的安装和应用性能不由本文的 Rust 裸索引基准证明。
完整数值、每轮记录和限制可从以下固定提交核对:
如果准备在自己的 Agent、RAG 或知识图谱工作负载中使用,建议沿用相同召回率比较方法,基于真实向量、过滤条件、查询分布和应用端到端路径独立复测。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号