AI 数据库建议加索引,先别进窗口
原创
AI 数据库建议加索引,先别进窗口
原创
数据库急诊室_阿哲
发布于 2026-11-11 11:17:13
发布于 2026-11-11 11:17:13
结论放前面:AI 数据库建议加索引,先别进窗口。不是建议一定错,而是它只完成了“找候选”,还没完成“证明可上线”。
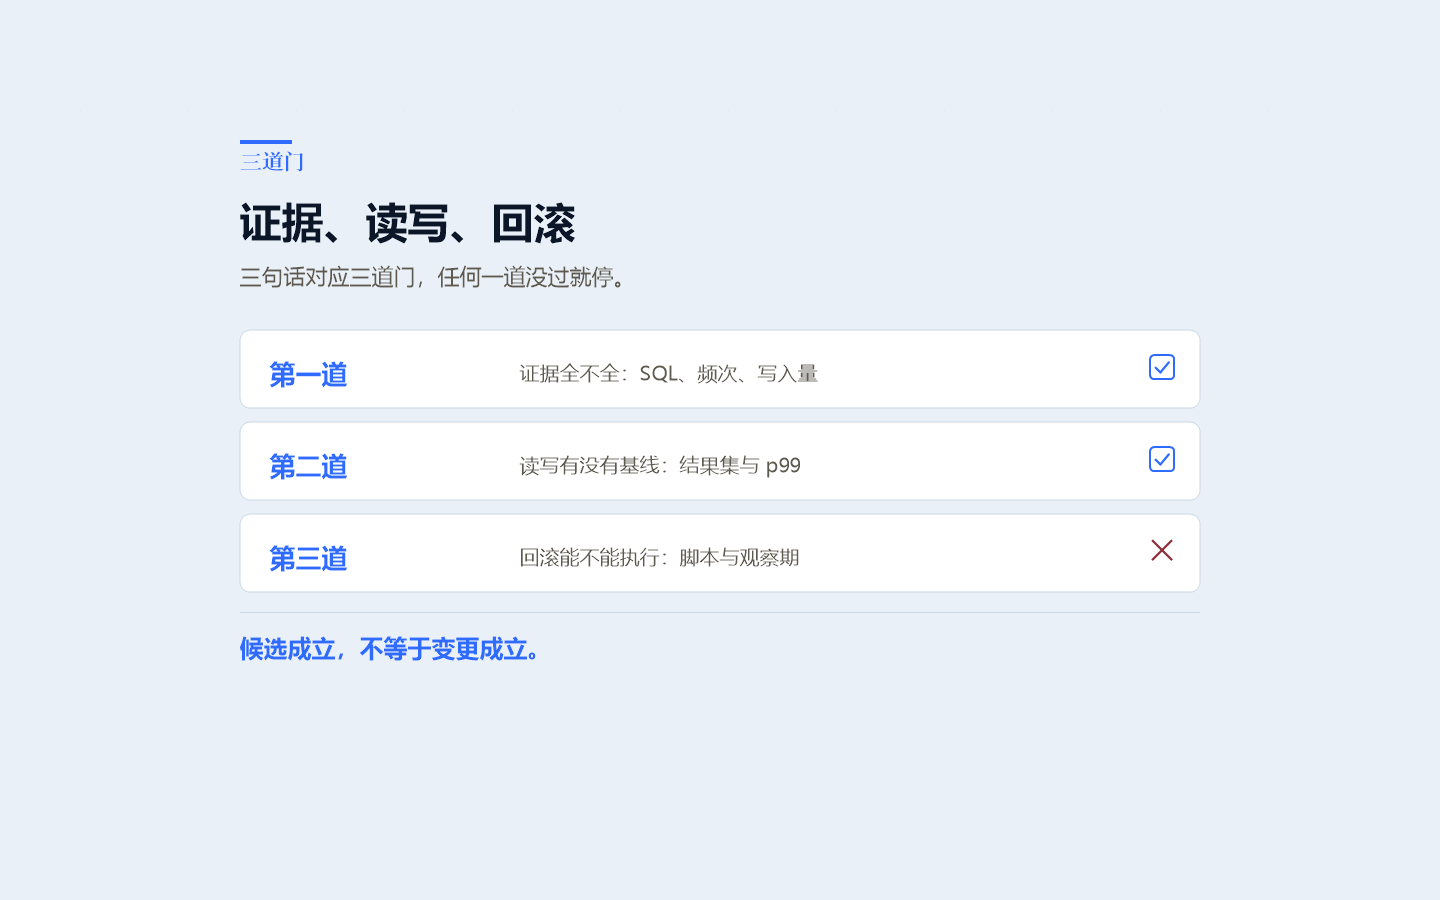
我判断的顺序是三句话:先看证据全不全,再看读写两侧有没有基线,然后看回滚和观察期能不能执行。三句话对应三道门,任何一道没过,建议就停在候选区。
我是阿哲,八年数据库运维和优化,金融行业甲方出身,后来做独立顾问。这篇不评厂商,只讲一条索引建议进窗口前要补什么。文中的表名、行数、延迟、索引大小都是示例环境,只用于说明方法。
一、为什么“加索引”不能直接排窗口
一份报告说,trade_flow 表的 status 字段选择性好,示例环境里 status = 'SUCCESS' 约占 3%,建议加 (status, created_at) 索引;这条 SQL 一小时约 200 次,表每分钟新增 1.2 万行。
这三个数说明它值得进入验证,不说明它可以上线。报告不知道你们的跑批窗口、写入峰值、现有索引重叠情况和回滚责任人。它给的是候选,不是变更单。
3% 的选择性只回答了一个问题:这一列值分布够不够散。它没回答查询还带了什么条件、索引前导列该放谁、统计信息是不是新的。示例里的查询还有时间范围,前导列放 status 还是 created_at,访问路径可能完全不同。
我会先问五个问题:SQL 原文和参数是什么;慢在读、算还是等;表每天写入多少;现有索引有没有重叠;写入变慢时怎么退、观察多久算通过。五问里有两三问答不上来,退回补充。
值班记录 现象:报告建议加 (status, created_at) 索引,只给了选择性和频次,没有 SQL 原文、写入曲线和回滚方案。 动作:退回,要求补 SQL、采样窗口、现有索引清单和回滚脚本。 结论:候选成立,变更不成立;不排窗口。
二、三道门:证据、读写、回滚
门 | 要回答的问题 | 过门证据 | 没过怎么办 |
|---|---|---|---|
证据门 | 是哪条 SQL,跑多快,跑多少次 | 原文、参数、采样窗口、频次 | 退回补充 |
读写门 | 结果有没有变,计划有没有变好,写入有没有变慢 | 双向比对、执行计划、p99、复制延迟 | 留在候选区 |
回滚门 | 出问题怎么退,观察多久 | 脚本、执行人、阈值、观察期 | 不排窗口 |
三道门是顺序关系,不是并列关系。证据门没过,后面的读写验证没有对象;读写门没过,回滚写得再漂亮也不该进窗口。
实际评审里,最容易漏的是回滚门。很多人把“能回滚”当成一句态度,没写成脚本、执行人和确认方法。真出问题时,这三样缺一样,窗口就会拖长。
三、读验证:先比结果集,再看计划
读验证放在只读副本或延迟副本上。先确认副本的数据时间点,再留加索引前的查询结果作为基线。示例写法,语法因库而异:
-- 基线表保存加索引前的结果
CREATE TABLE baseline_trade_flow AS
SELECT id, account_id, amount
FROM trade_flow
WHERE status = 'SUCCESS'
  AND created_at >= :start_time
  AND created_at < :end_time;

-- 加索引后,双向比对
SELECT 'baseline_minus_after' AS direction, COUNT(*) AS diff_rows
FROM (
  SELECT * FROM baseline_trade_flow
  EXCEPT
  SELECT id, account_id, amount FROM trade_flow
  WHERE status = 'SUCCESS'
    AND created_at >= :start_time
    AND created_at < :end_time
) d
UNION ALL
SELECT 'after_minus_baseline', COUNT(*)
FROM (
  SELECT id, account_id, amount FROM trade_flow
  WHERE status = 'SUCCESS'
    AND created_at >= :start_time
    AND created_at < :end_time
  EXCEPT
  SELECT * FROM baseline_trade_flow
) d;
两个方向都返回 0,才说明这份快照上结果一致。然后跑 EXPLAIN ANALYZE,看四行:访问方式、条件是进 Index Cond 还是只在 Filter、rows 估算与实际差多少、buffers 读了多少块。
这里有个前后对比:
观察项 | 加索引前 | 加索引后 | 判断 |
|---|---|---|---|
结果集 | 基线 | 双向差异 0 | 通过 |
条件位置 | Filter | Index Cond | 通过 |
访问方式 | 全表扫描 | 索引扫描 | 通过 |
扫描行数 | 高 | 明显下降 | 通过 |
这张表只说明“看什么”,不说明“一定会这样”。如果条件还在 Filter 里,或者 rows 估算差得远,先查统计信息和索引列序,不要继续往下签。
举个常见的偏差:加索引前条件是 Filter,加索引后还是 Filter,只是节点名从全表扫描换成了索引扫描。这种“换了名字没换路径”的情况,耗时可能没降,写入却已经多了一份维护。看到节点名变化,先别急着签,回到条件位置和 rows 再看一遍。
四、写验证:索引的代价在每一次写入
只读副本只能验读。写入副作用要在影子库、预发环境,或者业务低峰的小范围流量里测。示例环境里,同一轮写入压测的前后对比如下:
指标 | 加索引前 | 加索引后 | 口径 |
|---|---|---|---|
写入 p99 | 18 ms | 31 ms | 示例环境,1.2 万行/分钟 |
复制延迟 | 0.4 s | 0.9 s | 影子库,示例值 |
索引大小 | — | 2.3 GB | 示例环境 |
示例里 p99 从 18 ms 升到 31 ms,复制延迟从 0.4 s 升到 0.9 s。这个幅度能不能接受,要看你们的阈值,不是看这两个数字本身。阈值要在进窗口前写进变更单,不能等观察期结束再补。
压测要固定数据快照、并发和更新语句。换一批数据、换一个并发,p99 就不是同一个口径。报告里的收益通常只算读,变更单里要把写也算进去。
在线建索引(各库写法不同)能减少建索引时的写入阻塞,但它更慢,失败后可能留下无效索引。执行前确认长事务、锁等待和清理方案;执行后查索引是否有效,不要只看命令有没有报错。
值班记录 现象:结果集双向为 0,计划进入 Index Cond;影子库写入 p99 从 18 ms 升到 31 ms,复制延迟从 0.4 s 升到 0.9 s(示例值)。 动作:把观察期定为一个完整业务日加一个跑批窗口,旧索引保留,回滚脚本随变更单归档。 结论:读写两侧都有基线,写入代价在阈值内,附条件签字。
五、回滚与观察期
回滚脚本示例写法,语法因库而异:
-- 回滚:按各库的在线删除方式执行
DROP INDEX idx_trade_status_created;
回滚单写四样:谁执行、预计多久、执行后怎么确认索引已删除、业务查询怎么恢复。观察期至少覆盖一个完整业务日和一个跑批窗口。p99、复制延迟、业务报错,任何一项触线就回滚,不临时讨论。
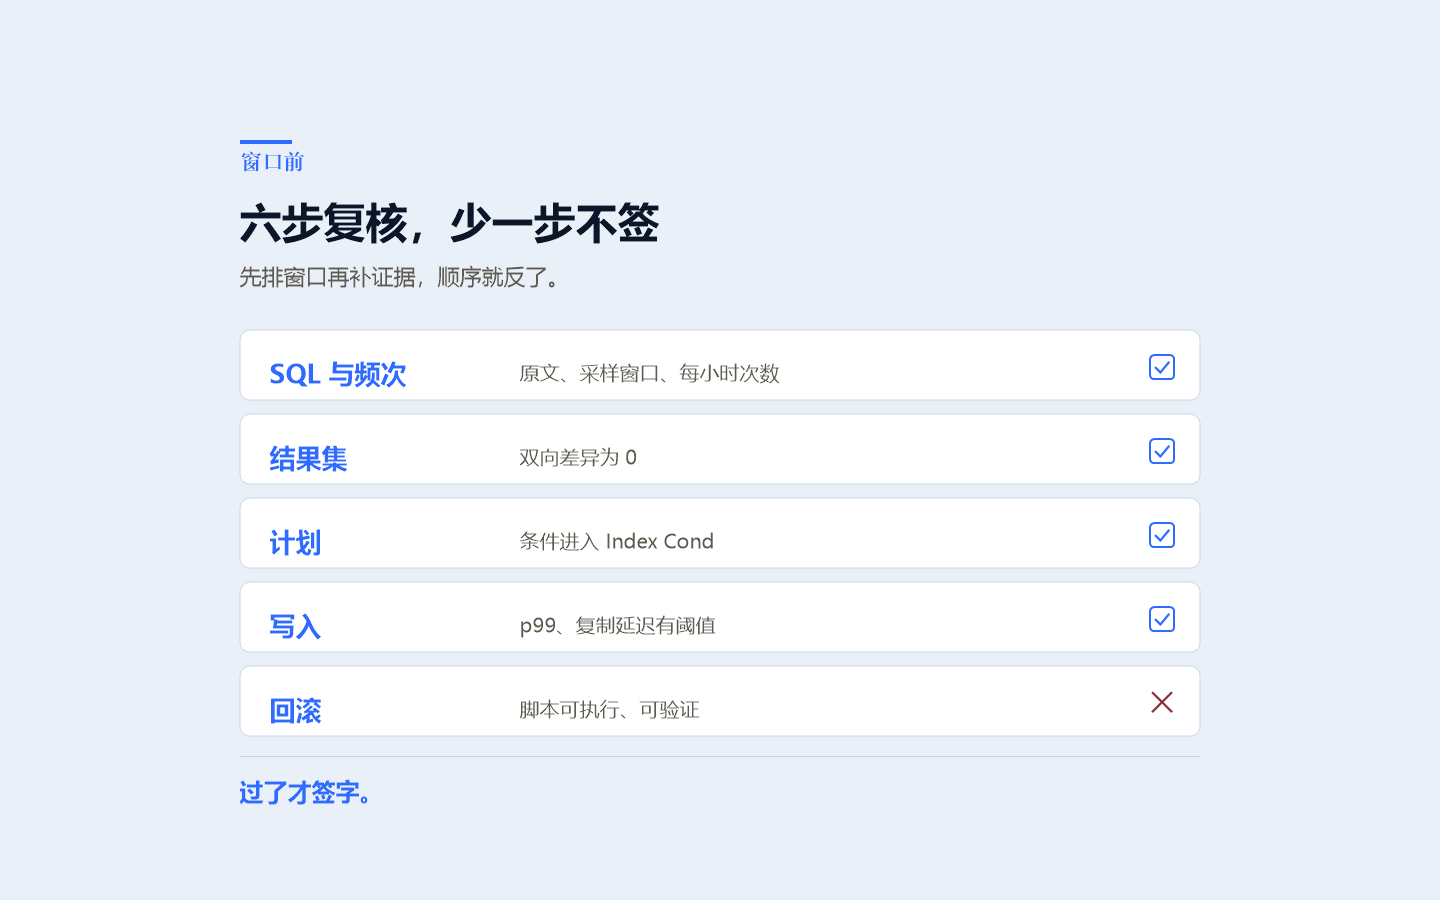
六、窗口前复核:六步,少一步不签
顺序 | 复核项 | 通过 | 退回或不签 |
|---|---|---|---|
1 | SQL、频次、写入量 | 三个数都有来源 | 只有报告结论 |
2 | 结果集 | 双向差异为 0 | 只比耗时 |
3 | 执行计划 | 条件进入 Index Cond,估算接近 | 只看节点名 |
4 | 写入副作用 | p99、复制延迟在阈值内 | 没测写入 |
5 | 回滚与观察期 | 脚本可执行,覆盖业务日/跑批 | 只有“可回滚” |
6 | 签字与归档 | 建议、执行、复核都能追到人 | 退回 |
窗口内只做已经演练过的动作。建索引、验证索引有效、跑一轮核心查询、看写入和复制延迟,按顺序来。窗口内不要临时改索引列序,也不要把“顺便删旧索引”塞进来。删索引也是变更,旧索引先留着,观察期结束再看它还有没有被使用。
七、适用条件
这套做法适用于有只读副本、写入量可观测、能安排观察期的业务库。如果表是纯写入流水,查询又是偶发,先算收益;如果变更窗口很短,回滚脚本和观察指标要提前准备好,窗口内补来不及。不同库的在线建索引方式不一样,步骤要按所在库的文档改写,不能照搬。如果这三样有一样不确定,先留在候选区,不要用窗口去试。
规则:证据门、读写门、回滚门,三道都过才排窗口;任何一道没过,建议继续留在候选区。
同样的现象可能有别的根因,欢迎带数字来讨论。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号