Google | 提出CoT解码新方法,无需Prompt,就能让大模型(LLM)进行CoT推理

Google | 提出CoT解码新方法,无需Prompt,就能让大模型(LLM)进行CoT推理

ShuYini
发布于 2024-02-22 13:21:23
发布于 2024-02-22 13:21:23
引言
在增强大语言模型(LLM)的推理能力方面,先前的研究主要集中在特定的Prompt技术上,例如少样本(Few-shot)或零样本(Zero-shot)思维链(CoT)提示。这些方法虽然有效,但通常涉及手工密集型Prompt工程。
为此,Google的研究人员提出了一种名为CoT-decoding的解码方法,「该方法能够有效提升大型语言模型在各种推理任务中的表现,并通过自发地揭示CoT推理路径,改善模型的推理能力和准确性」。这种方法避免了手动CoT提示工程,并实现了以无监督的方式评估LLMs的推理能力。

https://arxiv.org/pdf/2402.10200v1.pdf
背景介绍
大型语言模型(LLM)在各种复杂的推理任务上都表现出了强悍的性能。LLMs的这些推理能力通常是利用Prompt技术,这些提示技术可以是带有中间步骤的Few-shot Prompt,也可以是要求显示中间步骤的特定的Zero-shot Prompt;除此之外,另一种激发 LLM 推理能力的常用策略是使用大量的思想链 (CoT) 推理数据进行模型训练或指令调整。
「以上这些Prompt技术通常需要人为设计特定的提示语句来引导模型进行推理」。为此,本文研究旨在通过探索不同的视角来激发法学硕士的推理能力,并提出问题:「LLMs能否在没有提示的情况下进行有效的推理?」 它们能推理到什么程度?我们发现,可以通过简单地改变解码过程来从预训练的 LLM 中引发 CoT 推理。
CoT-decoding
下图展示了本文新提出的解码方法,即给定一个推理问题,LLM 通过标准贪婪解码路径生成错误答案,而Top-𝑘 Token中的替代路径检查揭示了模型内部固有的 CoT 路径(例如,解码路径 2 和 4), 这种解码修改绕过了 CoT 提示,完全无监督,并且无需对模型进行调整。
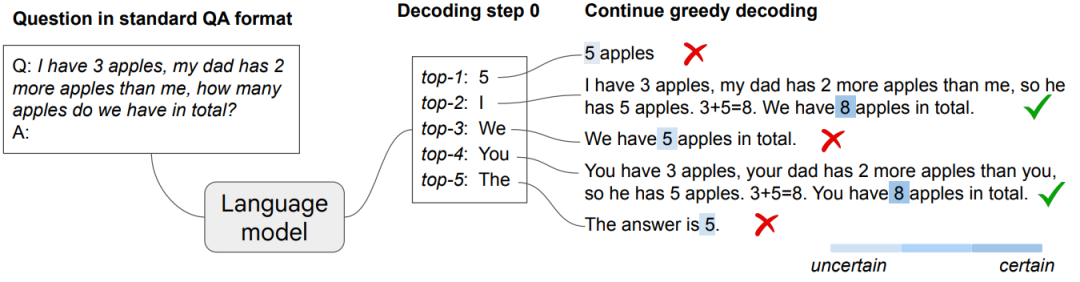
具体来说,作者使用标准问答 (QA) 格式来制定输入:“Q:[问题]”,尽管大多数现有工作表明LLMs在直接QA推理场景下表现不尽人意,但是本文研究结果却有一些新的发现。通过观察可以发现,当仅仅依赖于贪婪解码路径时,LLMs确实在推理上遇到了困难;然而,当考虑 top-𝑘 Token中的替代路径时,CoT 推理模式会自然地出现在 LLM 的解码轨迹中。
此外,作者还观察到了一个有趣的模式:当解码过程中存在 CoT 推理路径时,模型会增加对最终答案的置信度。这一点很明显,如上图所示,路径 2 和 4 在得出正确答案“8”时显示出更高的确定性,与导致错误“5”的路径中的高度不确定性形成鲜明对比。基于该种现象,本文开发了一种筛选
解码路径的方法,并将其称为CoT-decoding,从而找出模型输出的最可靠路径。
结合以上内容,本文CoT-decoding将能够提供以下几种功能:
「探索替代标记路径」:CoT-decoding方法首先通过探索LLMs在解码过程中选择替代Token的路径,即在第一个解码步骤中选择不同的标记,以寻找其中是否存在CoT推理路径。这种方法旨在发现LLMs是否在解码过程中自然生成具有推理能力的路径,而不是仅仅依赖于贪婪解码策略。
「提取可靠的推理路径」:一旦发现存在CoT推理路径,CoT-decoding方法会选择这些路径作为更可靠的推理路径。这些路径通常表现出模型对最终答案的更高信心度,从而提高了模型的推理准确性和可靠性。通过选择这些路径,CoT-decoding方法能够提取出更可靠的推理路径,从而改善模型的推理性能。
「评估模型的固有推理能力」:CoT-decoding方法的一个关键目标是评估模型的固有推理能力,而不是依赖外部提示或特定的任务设置。通过观察LLMs在解码过程中生成的推理路径,可以更好地了解模型在推理任务上的表现,并评估其固有的推理能力。
实验结果
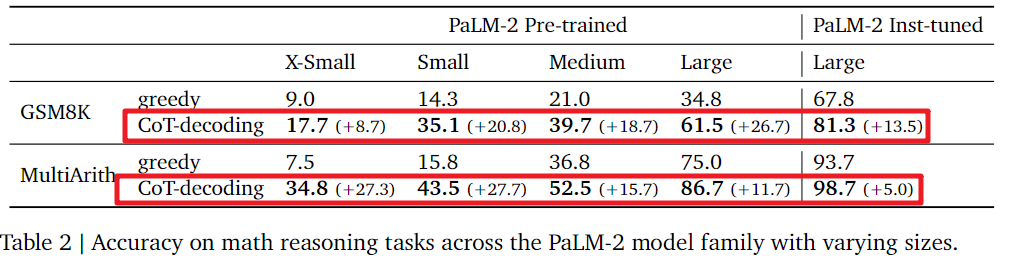
为了验证CoT-decoding方法的有效性,本文使用GSM8K和MultiArith数据集进行数学推理任务的实验,CoT-decoding方法在PaLM-2模型系列上表现出色,与传统的贪婪解码方法相比,显著提高了模型的推理能力,如下图所示。
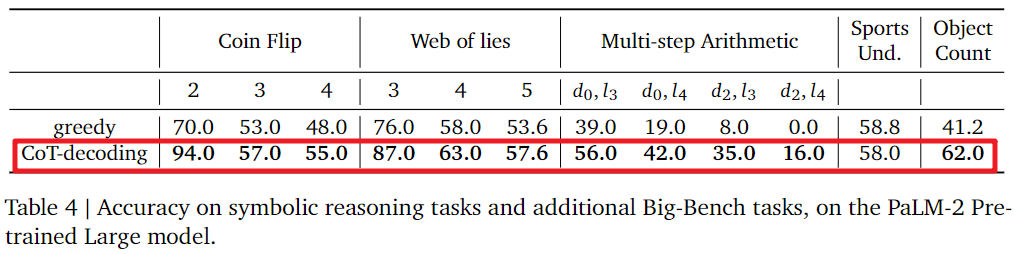
在PaLM-2 Large模型上,CoT-decoding相对于贪婪解码方法在GSM8K数据集上的绝对准确率提升了26.7%,如下图所示。
综上所述,CoT-decoding方法通过探索替代标记路径、提取可靠的推理路径、评估模型的固有推理能力以及进行实证研究和结果分析,为增强大型语言模型在推理任务中的表现提供了一种全面且有效的方法。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2024-02-21,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号