Hive数据模型深度解析:从数据库到分桶的高效查询基石

Hive数据模型深度解析:从数据库到分桶的高效查询基石

用户6320865
发布于 2025-11-29 09:01:45
发布于 2025-11-29 09:01:45
Hive概述与数据模型的重要性
在大数据技术快速演进的今天,Hive作为一个构建在Hadoop生态系统之上的数据仓库工具,持续在企业级数据处理中扮演重要角色。最初由Facebook开发并贡献给Apache基金会,Hive的设计初衷是为了降低大数据处理的门槛,让熟悉SQL的用户能够通过类SQL语言(HiveQL)来处理存储在HDFS上的海量数据,而无需编写复杂的MapReduce程序。随着Hadoop生态的不断成熟以及云原生和数据湖架构的兴起,Hive在2025年仍然广泛应用于日志分析、ETL流程、即席查询等场景,并与Spark、Flink等现代计算框架深度集成,形成互补的数据处理解决方案。根据2025年Gartner最新行业报告,超过78%的企业在数据湖架构中采用Hive作为核心查询引擎,其性能较2023年提升近40%,尤其在复杂即席查询场景中表现突出。
Hive的核心优势之一在于其数据模型的组织方式,它直接决定了数据查询和处理的效率。作为大数据查询的基石,Hive的数据模型不仅帮助用户以结构化的方式管理数据,还通过分层和细粒度的数据组织来优化查询性能。如果没有合理的数据模型设计,即使拥有强大的计算资源,查询也可能面临全表扫描、数据倾斜、资源浪费等问题,导致响应缓慢和成本高昂。因此,深入理解Hive的数据模型,对于任何希望高效利用大数据技术的从业者来说都至关重要。
Hive与Hadoop的关系密不可分。Hive并非一个独立的数据存储系统,而是构建在Hadoop分布式文件系统(HDFS)之上,通过元数据管理(存储在如MySQL或Derby等关系型数据库中)将结构化的数据文件映射为表结构。这意味着,Hive的数据模型直接依赖于Hadoop的存储特性,例如数据的分块存储、副本机制和容错性。同时,Hive在执行查询时可以利用MapReduce、Tez或Spark作为计算引擎,这种解耦的设计让用户可以根据需求灵活选择执行方式,平衡吞吐量和延迟。
在当前的趋势下,随着数据量的持续增长和实时处理需求的提升,Hive也在不断进化。例如,Hive LLAP(Live Long and Process)提供了更快的交互式查询能力,而Hive与云存储(如AWS S3、Azure Data Lake Storage)的集成使得跨云和数据湖架构变得更加普遍。此外,数据治理和安全性的要求也推动了Hive在元数据管理、访问控制和数据血缘分析方面的增强。这些发展进一步凸显了数据模型的重要性,因为只有良好组织的数据才能充分发挥这些新特性的效益。
Hive的数据模型包含几个层次化的结构:数据库(Database)、表(Table)、分区(Partition)和分桶(Bucket)。每个层级都服务于不同的目的,从逻辑隔离到物理优化,共同构建了一个高效的数据管理框架。数据库作为最高层的命名空间,帮助用户隔离不同的数据项目或业务线,避免表名冲突并简化权限管理。表则是核心的数据存储单元,定义了数据的结构和格式,例如内部表与外部表的区别决定了数据生命周期是否由Hive管理。分区通过将数据划分为更小的、基于特定列值的部分(如按日期或区域),大幅减少了查询时需要扫描的数据量,这对于时间序列或分类数据尤为有效。分桶则提供了另一种数据细分方式,通过哈希函数将数据分布到固定数量的桶中,常用于优化连接操作和数据采样。
理解这些组件如何协同工作,是掌握Hive高效查询的关键。例如,在一个典型的日志分析场景中,用户可能会先创建一个数据库来隔离不同应用的数据,然后在其中定义表结构,并使用日期分区来组织每日的日志文件。进一步,如果需要对用户ID进行高效连接,可能会引入分桶机制。这种分层设计不仅提升了查询性能,还增强了数据的可维护性和扩展性。
总的来说,Hive的数据模型是其强大功能的根基,它使得用户能够以声明式的方式处理大数据,而无需关心底层的分布式复杂性。随着技术生态的发展,这一模型仍在不断适应新的需求,例如支持更复杂的数据类型、优化资源利用率以及整合机器学习工作流。对于大数据爱好者和从业者而言, investing time in mastering these concepts will pay dividends in building scalable and efficient data solutions.
数据库(Database):Hive的数据组织起点
在Hive的数据组织架构中,数据库(Database)扮演着基础且关键的角色。作为数据管理的逻辑容器,数据库不仅提供了命名空间的隔离机制,还为后续表、分区和分桶的构建奠定了结构性基础。理解数据库的概念及其操作方法,是掌握Hive高效数据管理的第一步。
数据库的基本概念与作用
Hive中的数据库可以视为一个逻辑上的数据集合单元,类似于传统关系型数据库中的"数据库"或"模式(Schema)"。每个数据库内部可以包含多张表,而不同数据库之间的表名可以重复,这通过命名空间隔离实现了数据管理的灵活性和组织性。例如,在企业级大数据平台中,不同部门或业务线可以使用独立的数据库来存储和管理数据,既能避免命名冲突,又能简化权限控制和资源分配。
除了命名空间管理,数据库在Hive中还承担着元数据存储和资源隔离的功能。Hive的元数据存储于关系型数据库(如MySQL或Derby)中,每个数据库对应元数据仓库中的一组表定义、分区信息等。这种设计使得用户能够通过HiveQL(Hive Query Language)像操作传统数据库一样进行数据定义和查询,同时底层依赖Hadoop分布式文件系统(HDFS)存储实际数据文件。
创建与管理数据库
Hive提供了简洁的DDL(Data Definition Language)语法来操作数据库。创建数据库的基本命令是CREATE DATABASE,用户可以指定数据库的名称、存储路径、注释等属性。例如,以下代码展示了创建一个名为sales_db的数据库,并为其添加描述信息:
CREATE DATABASE IF NOT EXISTS sales_db
COMMENT 'Sales department database'
LOCATION '/user/hive/warehouse/sales_db.db';这里的LOCATION参数允许用户自定义数据库在HDFS上的存储路径,若不指定,Hive会使用默认的仓库路径(通常为/user/hive/warehouse)。IF NOT EXISTS子句可避免重复创建时报错,这在自动化脚本中非常实用。
数据库创建后,可以通过SHOW DATABASES命令查看所有数据库列表,使用DESCRIBE DATABASE sales_db获取数据库的详细属性。若需要修改数据库属性(如更新注释),Hive提供了ALTER DATABASE语句,但需要注意的是,Hive对数据库的修改功能相对有限,例如不支持重命名操作,通常需要借助元数据直接更新或重建数据库。
删除数据库使用DROP DATABASE命令,默认情况下,若数据库非空(包含表或其他对象),删除操作会失败。可以添加CASCADE关键字强制删除数据库及其所有内容:
DROP DATABASE IF EXISTS sales_db CASCADE;这一操作会同时移除数据库在HDFS上的存储目录,因此执行前需谨慎确认。
数据库的最佳实践
在实际应用中,合理规划数据库结构能显著提升数据管理效率。以下是一些常见的最佳实践:
- 按业务或功能划分数据库:例如,将日志数据、用户行为数据和交易数据分别存放在
log_db、user_db和transaction_db中。这种划分不仅清晰化了数据归属,还为后续的权限管理和资源调度提供了便利。 - 规范命名约定:建议使用具有业务意义的英文名称,并统一大小写风格(Hive默认不区分大小写,但元存储可能依赖配置)。避免使用特殊字符或空格,以减少后续查询和脚本编写的复杂性。
- 合理设置存储位置:对于大型企业环境,可以考虑将不同数据库的存储路径映射到不同的HDFS目录或存储策略中,结合HDFS的存储类型(如SSD、HDD)或加密区域(Encryption Zone)实现性能与安全的优化。
- 权限控制与审计:Hive集成Apache Ranger或Sentry等框架时,数据库可以作为权限分配的最小单元。通过为不同用户或组授予数据库级别的访问权限,可以有效实施数据安全策略。同时,数据库的创建和修改操作应纳入审计日志,以满足合规性要求。
数据库与资源管理
在多用户或大规模集群环境中,数据库还与资源管理密切相关。例如,通过Hive的数据库属性,可以关联到YARN队列资源或Kerberos认证策略。在一些高级应用中,用户可以为不同数据库配置独立的资源池,限制其CPU或内存使用量,防止单一业务消耗过多集群资源。
此外,随着数据湖架构的普及,Hive数据库逐渐与外部数据目录(如AWS Glue或Hadoop元存储服务)集成,实现跨引擎(如Spark、Presto)的元数据共享。这种趋势在2025年的大数据生态中尤为明显,进一步强化了数据库作为统一数据管理入口的角色。
实际应用示例
假设某电商公司需要构建数据平台,初步规划包含用户、订单和库存三个核心业务域。可以分别创建以下数据库:
CREATE DATABASE user_db
LOCATION '/data/user';

CREATE DATABASE order_db
LOCATION '/data/order';

CREATE DATABASE inventory_db
LOCATION '/data/inventory';此后,各类业务表(如user_db.user_profiles、order_db.orders)可以按需创建,并通过Hive视图或跨数据库查询实现关联分析。这种结构不仅清晰,也为未来数据治理(如数据血缘追踪、质量监控)提供了良好基础。
需要注意的是,尽管数据库提供了逻辑隔离,但Hive在查询时仍需显式指定数据库名称(除非使用USE database_name切换上下文),例如:
SELECT * FROM user_db.user_profiles WHERE region='Asia';这一特性要求用户在编写查询或应用代码时保持注意力,避免因数据库上下文混淆而导致错误。
通过上述内容,我们可以看到数据库在Hive中远不止是一个简单的容器,而是数据组织、权限管理和资源控制的重要单元。合理使用数据库,能够为后续表的创建、分区策略的实施以及分桶优化打下坚实基础。
表(Table):Hive的核心数据存储单元
在Hive的数据模型中,表(Table)是最核心的数据存储单元,承载着数据的结构化表示和查询操作的基础。无论是简单的数据存储还是复杂的分析任务,表都是所有操作的起点和终点。理解Hive表的定义、类型、创建方式以及其在查询优化中的作用,对于高效使用Hive至关重要。
表的定义与基本结构 在Hive中,表本质上是一种逻辑结构,用于描述存储在HDFS或其他兼容存储系统(如S3、ADLS)上的数据。每个表由一系列具有数据类型的列组成,这些列定义了数据的模式(Schema)。与关系型数据库类似,Hive表支持多种数据类型,包括基本类型(如INT、STRING、DOUBLE)和复杂类型(如ARRAY、MAP、STRUCT)。表的元数据(如表名、列定义、存储格式等)存储在Hive的元存储(Metastore)中,而实际数据则存储在分布式文件系统中。
表的创建通常通过HiveQL(Hive Query Language)完成,这是一种类似SQL的声明式语言。以下是一个创建内部表的示例:
CREATE TABLE employee (
    id INT,
    name STRING,
    salary DOUBLE,
    department STRING
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ','
STORED AS TEXTFILE;此代码定义了一个名为employee的表,包含四列,数据以逗号分隔,存储格式为文本文件。这种灵活性使得Hive能够处理多种数据格式,包括文本、Parquet、ORC等。
内部表与外部表 Hive表分为内部表(Managed Table)和外部表(External Table),这两种类型在数据生命周期管理和存储控制上有显著区别。
- 内部表:Hive全面管理其数据和元数据。当删除内部表时,Hive会同时删除元存储中的元数据和HDFS上的实际数据文件。内部表适用于数据完全由Hive控制的情况,例如中间表或临时表。
- 外部表:Hive仅管理元数据,而实际数据存储在外部位置(如HDFS或其他存储系统)。删除外部表时,仅删除元数据,实际数据保持不变。外部表适用于多系统共享数据的场景,例如与其他数据处理框架(如Spark或Impala)协同工作。
内部表和外部表的结构对比
创建外部表的语法如下:
CREATE EXTERNAL TABLE external_employee (
    id INT,
    name STRING,
    salary DOUBLE
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ','
LOCATION '/user/hive/external/employee';通过LOCATION子句指定数据存储路径,Hive不会移动或删除这些数据。
表的存储格式与数据序列化 Hive支持多种存储格式,每种格式各有优劣,直接影响数据的读写性能和存储效率。常见的格式包括:
- 文本文件(TEXTFILE):默认格式,人类可读,但存储和查询效率较低。
- 序列文件(SEQUENCEFILE):二进制格式,支持块压缩,适用于大规模数据存储。
- 列式存储格式(如Parquet、ORC):这类格式在查询时仅读取需要的列,大幅减少I/O操作,尤其适合分析型工作负载。ORC(Optimized Row Columnar)格式还支持谓词下推和压缩优化,是Hive中高性能查询的推荐选择。
以下是一个使用ORC格式创建表的示例:
CREATE TABLE employee_orc (
    id INT,
    name STRING,
    salary DOUBLE
)
STORED AS ORC
TBLPROPERTIES ("orc.compress"="SNAPPY");通过TBLPROPERTIES可以进一步配置存储属性,例如压缩算法。
表在查询优化中的角色 表的定义和存储格式直接影响Hive的查询性能。例如,使用列式存储格式(如ORC或Parquet)可以显著减少数据扫描量,尤其是在涉及大量列的查询中。此外,通过分区(Partition)和分桶(Bucket)机制,可以进一步优化数据组织方式。分区将数据按特定列(如日期或类别)划分为目录,而分桶则将数据哈希分布到固定数量的文件中。这两种机制都能减少查询时需要处理的数据量,提升性能。
以下是一个包含分区和分桶的表创建示例:
CREATE TABLE employee_optimized (
    id INT,
    name STRING,
    salary DOUBLE
)
PARTITIONED BY (department STRING)
CLUSTERED BY (id) INTO 4 BUCKETS
STORED AS ORC;通过PARTITIONED BY和CLUSTERED BY子句,数据会按部门分区并按ID分桶,使得查询可以快速定位到特定数据子集。
表的操作与管理
Hive提供了丰富的表操作命令,包括数据加载、查询、修改和删除。例如,使用LOAD DATA语句可以将数据从HDFS加载到表中:
LOAD DATA INPATH '/user/data/employee.csv' INTO TABLE employee;对于外部表,数据可以通过直接写入指定路径的方式添加,无需通过Hive加载。此外,Hive支持表的ALTER操作,例如添加列或修改存储属性:
ALTER TABLE employee ADD COLUMNS (age INT);表的统计信息收集也是优化查询的重要环节。通过ANALYZE TABLE命令,Hive可以收集表的行数、列的数据分布等统计信息,供查询优化器使用:
ANALYZE TABLE employee COMPUTE STATISTICS;表的设计最佳实践 在实际应用中,表的设计需综合考虑数据访问模式、存储成本和查询性能。以下是一些常见建议:
- 根据查询频率选择分区键,避免过度分区导致元数据膨胀。
- 对于大规模数据,优先使用列式存储格式并启用压缩。
- 在需要高效连接操作的场景中,使用分桶来优化数据分布。
- 外部表适用于多框架共享数据的场景,而内部表更适合Hive独占管理的中间数据。
通过合理利用表的特性和优化机制,可以充分发挥Hive在大数据处理中的潜力,为高效查询奠定坚实基础。
分区(Partition):提升查询效率的关键机制
在Hive的数据模型中,分区(Partition)是一种高效组织和管理大规模数据的核心机制。通过将表数据按照特定列的值进行物理划分,分区能够显著减少查询时需要扫描的数据量,从而加速数据检索过程。理解分区的原理和应用,对于设计高性能的大数据查询系统至关重要。
分区的概念与基本原理
分区本质上是将表中的数据按照一个或多个列(称为分区键)的值进行逻辑和物理上的划分。每个分区对应一个独立的目录,存储具有相同分区键值的数据文件。例如,对于一个存储销售记录的表,可以按照“日期”列进行分区,这样每天的数据会存储在不同的目录中。当查询特定日期的数据时,Hive只需扫描对应日期的分区目录,而无需读取整个表的数据,大大提升了查询效率。
分区键的选择通常基于查询模式中频繁使用的过滤条件。常见的分区键包括时间字段(如年、月、日)、地域字段(如国家、城市)或业务分类字段(如产品类别)。需要注意的是,分区键不应选择高基数列(即取值非常多的列),否则会导致分区数量过多,增加元数据管理的开销,反而可能降低性能。
静态分区与动态分区
Hive支持两种分区的创建方式:静态分区和动态分区。静态分区需要用户明确指定每个分区的值,适用于分区数量较少且值已知的场景。例如,在创建表时或插入数据时,可以通过以下方式指定分区:
-- 创建分区表
CREATE TABLE sales (
    product_id STRING,
    amount DOUBLE
)
PARTITIONED BY (sale_date STRING);

-- 插入数据到特定分区
INSERT INTO TABLE sales PARTITION (sale_date='2025-07-25')
VALUES ('P001', 100.0);
动态分区则允许Hive根据数据内容自动创建分区,适用于分区值来源于数据本身且分区数量较多的场景。例如,从一个已有表中抽取数据并按照日期动态分区:
-- 启用动态分区
SET hive.exec.dynamic.partition = true;
SET hive.exec.dynamic.partition.mode = nonstrict;

-- 插入数据并动态分区
INSERT INTO TABLE sales PARTITION (sale_date)
SELECT product_id, amount, sale_date FROM raw_sales;动态分区虽然灵活,但需要注意控制分区的数量,避免因为分区过多导致性能问题。Hive提供了一些配置参数(如hive.exec.max.dynamic.partitions)来限制动态分区的数量。
分区的管理与优化
分区的管理包括添加、删除、修复和查询分区信息。例如,可以通过ALTER TABLE语句添加或删除分区:
-- 添加新分区
ALTER TABLE sales ADD PARTITION (sale_date='2025-07-26');

-- 删除分区
ALTER TABLE sales DROP PARTITION (sale_date='2025-07-25');此外,分区表的元数据需要与实际数据目录保持一致。如果通过HDFS等外部工具直接操作数据文件,可能需要使用MSCK REPAIR TABLE命令修复分区信息。
分区的一个重要优化手段是结合分桶(Bucket)使用。例如,可以先按日期分区,再按产品ID分桶,这样可以在分区内进一步细分数据,提升查询和连接操作的效率。
分区对查询性能的影响
分区通过减少数据扫描量来加速查询,尤其适用于范围查询或过滤条件涉及分区键的场景。例如,查询某一天的数据:
SELECT * FROM sales WHERE sale_date = '2025-07-25';由于数据已经按日期分区,Hive只需读取sale_date='2025-07-25'对应的目录,而无需扫描整个表。这种机制在大数据场景下效果显著,尤其是当表的数据量达到TB或PB级别时。根据2025年行业实践数据,合理设计的分区策略可以将查询时间减少60%以上,特别是在日志分析和时间序列数据处理中表现尤为突出。Hive 3.x版本进一步优化了分区元数据的管理效率,通过引入更智能的元数据缓存和异步加载机制,大幅降低了高分区数带来的性能开销。
分区机制优化查询数据扫描减少示意图
然而,分区并非万能解决方案。如果分区键选择不当,或者分区数量过多,可能会导致小文件问题,增加NameNode的元数据压力。此外,分区键的基数过高(如用户ID)时,分区效果会大打折扣,甚至可能带来负面性能影响。
实际应用案例
以一个电商平台的用户行为日志表为例,假设该表每天产生数十亿条记录。通过按日期分区(例如按天),可以高效支持按时间范围的查询,如分析某一天的用户活跃度或交易趋势。同时,可以结合动态分区自动化数据加载过程,减少人工维护成本。
另一个案例是多媒体内容平台,存储海量视频元数据表。按照视频上传日期和类别分区,可以快速检索特定时间段或分类的内容,支撑推荐系统和数据分析需求。在2025年的实际部署中,某头部视频平台通过分区优化,将日均查询响应时间从分钟级压缩到秒级,同时资源利用率提升了40%。
通过合理设计分区策略,这些系统能够在保证数据管理灵活性的同时,实现高性能的查询响应。
分桶(Bucket):进一步的数据细分策略
在Hive的数据组织架构中,分桶(Bucket)是一种在分区基础上进一步细分数据的策略,它通过哈希函数将数据均匀分布到固定数量的存储单元中,从而在特定场景下显著提升查询性能和资源利用率。与分区不同,分桶不是基于目录的物理划分,而是对数据文件内部进行逻辑分组,每个桶对应一个文件。这种机制的核心在于,通过控制数据的分布方式,优化数据采样、连接操作以及并行处理。
分桶的创建依赖于CLUSTERED BY子句,在Hive建表时指定分桶列和桶的数量。例如,以下代码展示了如何创建一个按user_id列分桶的表,设置4个桶:
CREATE TABLE user_activities (
    user_id INT,
    activity STRING,
    event_time TIMESTAMP
)
CLUSTERED BY (user_id) INTO 4 BUCKETS
STORED AS ORC;这里,Hive会对user_id的值应用哈希函数,计算每个记录所属的桶编号,并将数据写入对应的文件。需要注意的是,分桶通常与高效的文件格式(如ORC或Parquet)结合使用,以最大化性能收益。此外,为了确保数据正确分布,在导入数据时,应启用动态分桶设置(例如,设置hive.enforce.bucketing=true),或通过INSERT语句显式指定分桶。
分桶与分区的主要区别在于其数据划分的维度和目的。分区是基于列值(如日期、地区)的粗粒度划分,每个分区对应一个HDFS目录,适用于减少查询时的数据扫描范围;而分桶是基于哈希值的细粒度划分,适用于优化数据分布,提升连接和采样效率。例如,在对大表进行JOIN操作时,如果两个表都按相同列分桶且桶数量一致,Hive可以执行高效的桶映射连接(Bucket Map Join),避免全表扫描,大幅降低I/O和计算开销。
在实际应用中,分桶的两个关键场景是数据采样和连接优化。对于数据采样,分桶允许快速、随机地抽取数据子集,而无需扫描全表。例如,使用TABLESAMPLE子句可以从分桶表中高效获取样本:
SELECT * FROM user_activities TABLESAMPLE(BUCKET 1 OUT OF 4 ON user_id);这条语句会返回第一个桶的数据,约占整体的25%,采样过程直接定位到对应文件,避免了随机读取带来的性能损失。在连接优化方面,分桶尤其适用于星型模型或大规模表关联。假设有一个订单表分桶于order_id,另一个订单明细表也按相同列和桶数分桶,那么执行JOIN时,Hive只需对匹配的桶进行局部连接,极大减少了数据移动和计算负载。
然而,分桶并非万能策略,其效果取决于数据分布和查询模式。如果分桶列的基数过低或数据倾斜严重,可能导致桶内数据不均,反而降低性能。因此,在设计分桶时,需选择高基数列作为分桶键,并合理设置桶数量(通常建议与集群节点数或任务并行度对齐)。此外,分桶表的维护成本较高,例如数据更新或插入时需要重新计算分布,这可能影响ETL流程的效率。
从发展趋势看,随着大数据技术生态的演进,分桶在云原生架构和实时处理场景中的应用正在扩展。例如,结合Hive 3.x以上的ACID事务特性,分桶可以支持更高效的数据更新操作。同时,在数据湖架构中,分桶与格式优化(如ORC的索引)结合,进一步提升了查询响应速度。尽管分桶增加了初始设计的复杂性,但对于需要高性能查询的大数据平台,它仍然是优化数据模型的重要手段。
综合应用与最佳实践
在大数据处理的实践中,Hive的数据模型设计直接影响着查询性能和资源利用效率。让我们通过一个具体的案例来展示如何综合运用数据库(Database)、表(Table)、分区(Partition)和分桶(Bucket)这些核心组件,构建一个高效的数据组织架构。
假设我们正在为一家电商平台设计用户行为日志分析系统。该平台每日产生数十亿条用户点击、浏览和购买记录,查询需求包括按日期范围统计用户行为、分析特定商品类别的访问趋势,以及进行用户画像的关联分析。
首先,我们创建一个名为ecommerce_analysis的数据库,用于隔离电商相关的所有数据对象,避免与其他业务数据(如财务或库存管理)产生命名冲突。通过数据库级别的权限管理,我们可以控制不同团队(如数据分析师和算法工程师)的访问权限,确保数据安全。
CREATE DATABASE IF NOT EXISTS ecommerce_analysis;
USE ecommerce_analysis;接下来,我们设计主表user_behavior_logs,用于存储用户行为数据。考虑到日志数据的来源和格式多样性,我们选择创建外部表,这样数据文件的实际存储位置可以与Hive元数据解耦,便于与其他数据处理流程(如Spark或Flink)集成。表结构包括用户ID、行为类型、商品ID、时间戳等关键字段。
CREATE EXTERNAL TABLE user_behavior_logs (
    user_id BIGINT,
    behavior_type STRING,
    item_id BIGINT,
    category_id INT,
    timestamp BIGINT
)
PARTITIONED BY (dt STRING)
CLUSTERED BY (user_id) INTO 50 BUCKETS
STORED AS PARQUET
LOCATION '/data/ecommerce/user_behavior';在这个表设计中,我们引入了分区机制,按日期(dt字段)进行分区。每日的数据会被存储在不同的分区目录中,例如/data/ecommerce/user_behavior/dt=2025-07-25/。这种设计使得按日期范围的查询可以快速定位到相关分区,避免全表扫描。例如,查询“2025年7月1日至7月25日的用户点击行为”只需要扫描25个分区,而不是数十亿条记录。
然而,仅靠分区可能无法满足更细粒度的查询需求。例如,如果我们需要频繁按用户ID进行过滤或连接操作(如分析特定用户的行为序列),分区键(日期)无法直接优化这类查询。这时,分桶机制发挥了作用。我们通过CLUSTERED BY (user_id) INTO 50 BUCKETS将每个分区内的数据进一步划分为50个桶,每个桶存储特定哈希范围内的用户ID数据。这样,在执行基于用户ID的等值查询或连接操作时,Hive可以只扫描相关的桶,大幅减少I/O和计算开销。
在实际应用中,这种组合策略显著提升了查询性能。例如,以下查询可以同时利用分区和分桶优化:
SELECT behavior_type, COUNT(*)
FROM user_behavior_logs
WHERE dt BETWEEN '2025-07-01' AND '2025-07-25'
AND user_id = 123456
GROUP BY behavior_type;Hive会先通过分区过滤到7月1日至25日的分区,然后在每个分区内仅扫描包含user_id=123456的桶,极大减少了数据处理量。
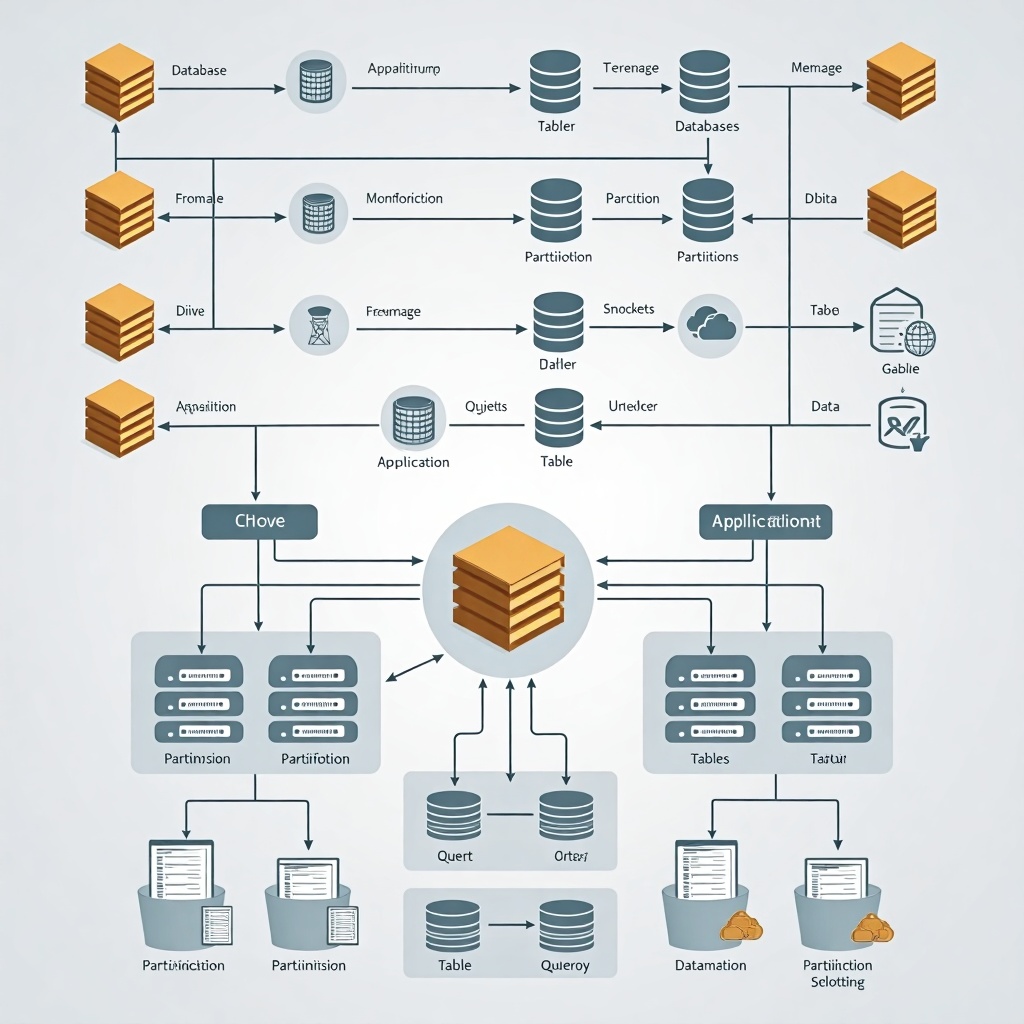
Hive数据模型组件协同工作
尽管这种设计带来了性能优势,但也存在一些常见陷阱。首先,分区粒度过细可能导致“小文件问题”。如果每个分区的数据量过小,会产生大量小文件,增加HDFS的元数据压力并降低查询效率。避免方法是根据数据规模合理选择分区键(如按周或月分区,而不是按日),或使用Hive的合并小文件工具(如ALTER TABLE ... CONCATENATE)。
其次,分桶数的选择需要谨慎。过多的桶会增加元数据管理和任务调度开销,而过少的桶则可能无法充分发挥分桶的优势。一般建议根据数据量和查询模式动态调整,例如每个桶的数据量控制在几百MB到1GB之间。
另一个常见错误是忽略数据倾斜问题。如果分区键或分桶键的分布不均匀(例如某些日期的数据量极大,或某些用户ID过于频繁),会导致部分任务负载过重。解决方法包括使用动态分区时结合随机前缀,或对倾斜键进行预处理(如拆分或聚合)。
最后,数据模型的维护也不容忽视。例如,定期使用MSCK REPAIR TABLE同步分区元数据,避免因手动添加分区而导致元信息不一致。同时,监控存储格式(如Parquet或ORC)的压缩率和编码效率,确保存储空间和查询性能的平衡。
通过上述案例,我们可以看到,一个高效的数据模型需要根据查询需求灵活组合数据库、表、分区和分桶。分区适用于粗粒度的数据裁剪,分桶则优化细粒度的数据定位,而外部表和存储格式的选择影响了数据的可维护性和兼容性。在实际项目中,建议通过迭代测试和性能剖析不断调整模型设计,以适应 evolving 的数据和查询模式。
高效查询的基石:数据模型实战 insights
在Hive的数据处理架构中,数据库、表、分区和分桶这四个核心组件并非孤立存在,而是通过紧密协作,共同构建起高效查询的底层支撑。理解它们之间的协同机制,是掌握Hive性能优化的关键。
首先,数据库作为命名空间的管理单元,为表提供了逻辑分组和资源隔离的环境。在实际应用中,通过将不同业务域或功能模块的数据表归类到不同的数据库,不仅可以避免命名冲突,还能在权限控制和资源分配上实现更精细的管理。例如,在电商场景中,用户行为日志、订单交易数据和商品信息可以分别存储于不同的数据库,这样在执行查询时,Hive能够快速定位到目标数据所在的库,减少元数据检索的开销。
表作为数据存储的基本单位,其结构设计直接影响查询效率。内部表和外部表的选择需根据数据生命周期管理需求而定:内部表适合Hive全权管理的数据,外部表则适用于与其他系统(如HDFS或云存储)共享的数据场景。在表的创建过程中,合理设置数据格式(如ORC、Parquet)和压缩算法(如Snappy、Zlib)能够显著减少I/O开销和存储空间。例如,使用列式存储格式ORC,结合压缩,可以在扫描大量数据时仅读取需要的列,极大提升查询速度。
分区机制通过将数据按特定维度(如日期、地区)进行物理划分,实现了查询时的数据剪枝。当查询条件包含分区键时,Hive只需扫描相关的分区目录,而非全表数据。例如,按日期分区的日志表,在查询某一天的数据时,可以跳过其他所有分区的扫描,将数据读取量降低数个数量级。动态分区和静态分区的灵活运用,可以根据数据写入模式选择最适合的方式——动态分区适用于维度值多变的情况,而静态分区则在批量导入固定分区数据时更为高效。
分桶则进一步在分区内对数据进行哈希分散,将数据划分为更小粒度的存储单元。分桶的优势主要体现在两方面:一是提升采样效率,随机抽样时可直接读取指定桶而无需全表扫描;二是优化连接操作,当两个表基于相同字段分桶且桶数一致时,Hive可以执行桶式连接(Bucket Map Join),大幅减少Shuffle过程中的数据移动。例如,用户表与订单表按用户ID分桶后,进行用户行为分析查询时,可避免大规模的数据重新分布,直接在映射阶段完成连接操作。
在实际项目中,这些组件的协同设计需要根据查询模式和数据特性进行权衡。例如,高频查询的筛选条件应优先作为分区键,而需要等值连接或采样的字段则适合作为分桶键。过度分区可能导致小文件问题,增加元数据管理负担;而分桶数过多或过少也会影响数据均匀性和查询并行度。因此,通常建议先按时间或地域等自然维度进行分区,再在分区内根据查询需求设置分桶。
随着数据规模的持续增长和计算引擎的不断演进,Hive数据模型的最佳实践也在逐步发展。在2025年的技术环境下,云原生数据湖架构的普及使得外部表与对象存储的结合更为常见,而智能优化器的发展也减少了对手动分桶的依赖。然而,理解底层数据组织原理,仍然是构建高效、可扩展数据平台的基础。未来,随着机器学习驱动的自动优化技术成熟,数据模型的设计可能会更加自动化,但核心的分区与分桶思想仍将持续影响大数据查询的性能边界。
,这些组件的协同设计需要根据查询模式和数据特性进行权衡。例如,高频查询的筛选条件应优先作为分区键,而需要等值连接或采样的字段则适合作为分桶键。过度分区可能导致小文件问题,增加元数据管理负担;而分桶数过多或过少也会影响数据均匀性和查询并行度。因此,通常建议先按时间或地域等自然维度进行分区,再在分区内根据查询需求设置分桶。
随着数据规模的持续增长和计算引擎的不断演进,Hive数据模型的最佳实践也在逐步发展。在2025年的技术环境下,云原生数据湖架构的普及使得外部表与对象存储的结合更为常见,而智能优化器的发展也减少了对手动分桶的依赖。然而,理解底层数据组织原理,仍然是构建高效、可扩展数据平台的基础。未来,随着机器学习驱动的自动优化技术成熟,数据模型的设计可能会更加自动化,但核心的分区与分桶思想仍将持续影响大数据查询的性能边界。
通过将这些数据模型组件有机结合,开发者可以在实际项目中构建出既满足业务需求,又具备高性能查询能力的数据架构。下一步,我们将深入探讨如何监控和调优基于该模型的数据操作,以确保系统在真实负载下保持稳定高效。
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2025-11-27,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号