智谱GLM视觉模型家族横向评测:从轻量OCR到多模态Agent,一文搞清怎么选

智谱GLM视觉模型家族横向评测:从轻量OCR到多模态Agent,一文搞清怎么选
代码简单说
发布于 2026-06-16 13:24:13
发布于 2026-06-16 13:24:13
智谱GLM视觉模型家族横向评测:从轻量OCR到多模态Agent,一文搞清怎么选
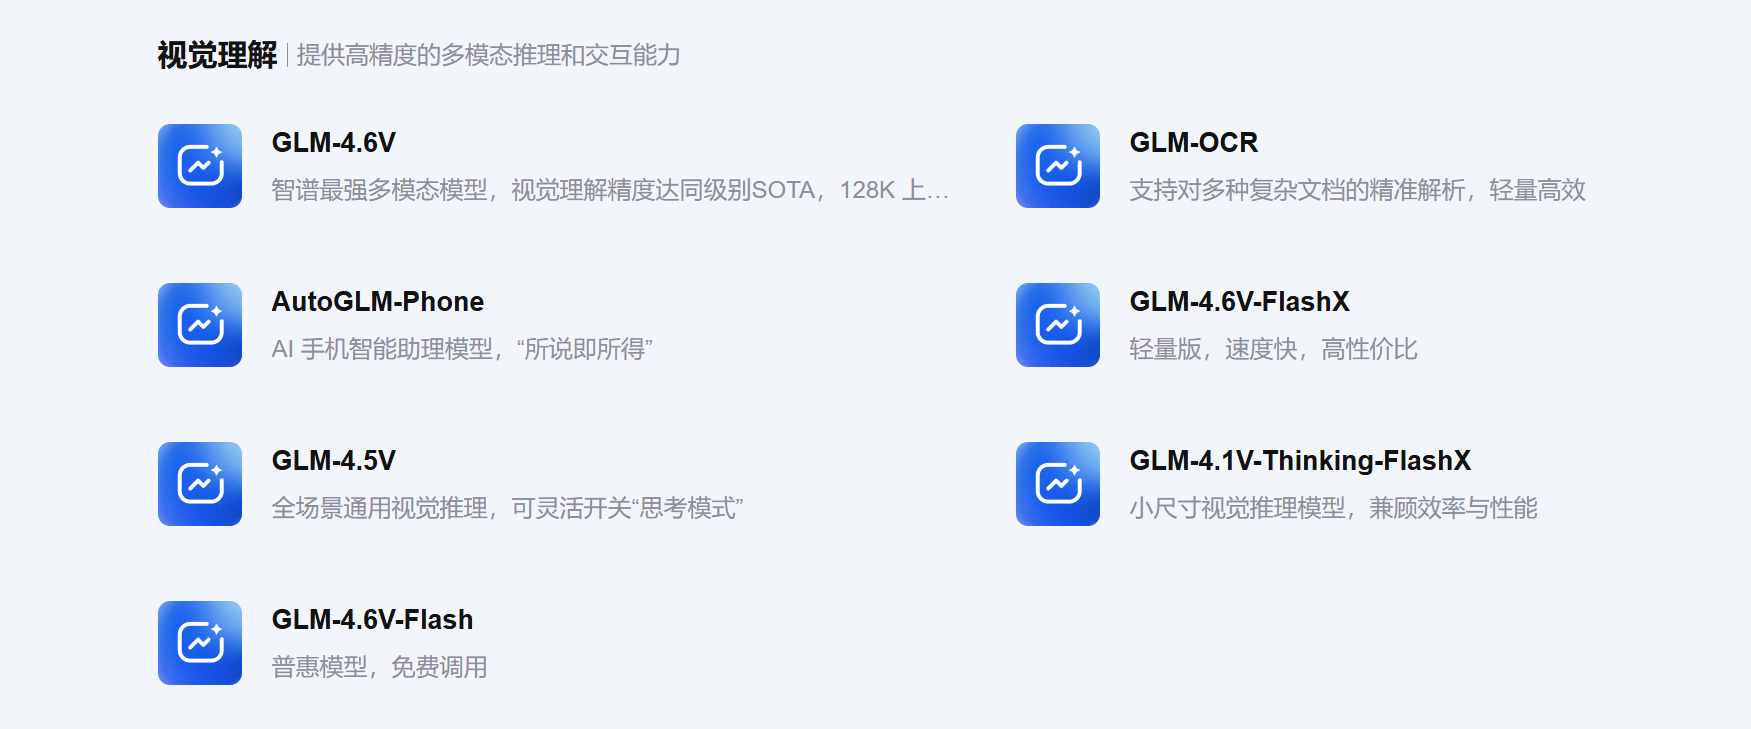
随着多模态大模型从“看图说话”迈入“视觉理解+自主决策”深水区,智谱AI近期密集更新了GLM视觉矩阵。面对 GLM-OCR、GLM-4.6V、GLM-4.1V-Thinking、GLM-5V-Turbo、AutoGLM-Phone 五款定位迥异的模型,开发者往往陷入“参数焦虑”与“选型困难”。本文基于官方技术文档与实战场景,为你做一次彻底的横向对比与场景匹配指南。
在这里插入图片描述
📊 一、 核心参数与定位速览
模型 | 参数量/定位 | 上下文窗口 | 输入/输出模态 | 核心亮点 | 典型价格 |
|---|---|---|---|---|---|
GLM-OCR | 0.9B / 专业轻量OCR | 最大100页PDF | PDF/图片 → 文本/MD/JSON | 文档解析SOTA,表格/公式/印章识别精准,推理成本仅为传统方案1/10 | 0.2元/百万Tokens |
GLM-4.6V | 106B(FlashX 9B) / 全能多模态基座 | 128K | 视频/图像/文本/文件 → 文本 | 原生多模态Function Call,“图像即参数,结果即上下文”,长视频/文档理解 | 按量计费(Flash免费) |
GLM-4.1V-Thinking | 10B / 视觉推理专家 | 64K | 视频/图像/文本 → 文本 | 内置思维链(CoT),10B级推理SOTA,理科解题/图表分析能力强 | Flash免费,FlashX 2元/百万Tokens |
GLM-5V-Turbo | - / 多模态Coding基座 | 200K | 视频/图像/文本/文件 → 文本 | 视觉编程闭环,深度适配Claude Code/OpenClaw,支持长程规划与自主探索 | 按量计费 |
AutoGLM-Phone | 端侧智能体框架 | 20K | 任务指令 → 设备操作执行 | VLM+ADB操控,支持50+主流App自动化,移动端“所说即所得” | 限时免费 |
💡 注:所有模型均支持
zai-sdk或zhipuaiSDK 调用,API 风格统一,便于在业务流中无缝切换。
🔍 二、 深度解析:五大模型能力与场景匹配
1️⃣ GLM-OCR:轻量级文档解析“卷王”
- 技术定位:专攻文档、票据、表格、公式的结构化提取。0.9B 参数却在
OmniDocBench V1.5拿下 94.62 分,性能直逼超大参数模型。 - 核心能力:
- 复杂表格(多层表头、合并单元格)直接转 HTML/Markdown
- 印章、手写体、代码文档、多语言混排高保真还原
- 支持自定义 JSON Schema 抽取关键信息
- 🎯 最佳场景:
- RAG 知识库数据清洗与切片
- 财务/政务/物流票据自动化录入
- 学术论文、研报、教材的公式与图表结构化
2️⃣ GLM-4.6V:全能型多模态基座,打通“视觉-行动”链路
- 技术定位:智谱多模态方向的重要迭代,首次将 Function Call 原生融入视觉模型,实现“感知→理解→执行”闭环。
- 核心能力:
- 128K 超长上下文,单次可处理 150页文档 / 1小时视频
- 图像/截图/文档页面可直接作为工具参数,无需先转文本
- 支持视频时间轴构建、瑕疵检测、图像反推提示词(Image2Prompt)
- 🎯 最佳场景:
- 多模态 Agent 构建(如识图购物、智能客服、内容创作)
- 长视频剪辑辅助、关键帧提取、爆款视频热点拆解
- 跨页合同比对、多文档关联分析、复杂版式重构
3️⃣ GLM-4.1V-Thinking:小参数大推理,科学计算与GUI的“最强大脑”
- 技术定位:10B 参数规模,引入课程采样强化学习策略,默认开启思维链(CoT)推理,在28项权威基准中18项持平或超越8倍参数量模型。
- 核心能力:
- 复杂题解、多步演绎、公式逻辑推演
- 图表深度解读与数据交叉分析
- 界面结构理解与GUI任务自动化
- 🎯 最佳场景:
- 教育/科研领域的理科题目解答与过程解析
- 商业报表/数据大屏的指标提取与趋势研判
- 自动化测试中的UI控件定位与交互逻辑规划
4️⃣ GLM-5V-Turbo:多模态 Coding 基座,Agent时代的“视觉程序员”
- 技术定位:智谱首个面向视觉编程任务打造的基座模型,200K上下文+128K最大输出,专注“看懂环境→规划动作→执行任务”。
- 核心能力:
- 设计稿/截图像素级还原为可运行前端代码
- 结合 Claude Code/OpenClaw 实现自主网页探索与代码生成
- 内置多模态工具链(画框、截图、读网页、Bug定位修复)
- 30+任务协同强化学习,覆盖GUI Agent、Video、Coding等
- 🎯 最佳场景:
- 前端开发:Figma/原型图一键转 React/Vue 工程
- 智能运维:Bug页面截图自动定位样式错位并生成修复补丁
- 复杂多模态Agent:视觉探查、GUI导航、自动化测试脚本生成
5️⃣ AutoGLM-Phone:手机端智能体,让“所说即所得”成为现实
- 技术定位:非单一推理模型,而是 VLM + ADB 的设备控制框架。通过自然语言解析屏幕内容,自动规划并执行手机操作。
- 核心能力:
- 支持 50+ 主流中文 App(微信、美团、京东、12306、小红书等)
- 原生支持
Tap/Swipe/Type/Launch/Back/LongPress等底层操控 - 遇到验证码/登录页自动触发
Take_over请求人工接管
- 🎯 最佳场景:
- 个人生活助理:外卖下单、比价购物、行程规划、音乐播放
- 跨应用复杂工作流:如“在飞书请假 → 去携程订高铁票 → 整理行程发微信”
- 移动端 RPA 自动化测试与数据抓取
🧭 三、 选型指南:按业务需求对号入座
你的核心需求 | 推荐模型 | 组合建议 |
|---|---|---|
只要高精度OCR、票据/表格/公式提取、对接RAG | GLM-OCR | 直接调用 layout_parsing API,输出Markdown/JSON |
长视频分析、多模态内容理解、需要调用外部工具 | GLM-4.6V | 开启 thinking 与 function_call,构建视觉Agent |
理科解题、图表推理、GUI自动化、追求性价比 | GLM-4.1V-Thinking | 使用 Flash 版免费测试,复杂任务切 FlashX |
设计稿转代码、前端复刻、Agent视觉规划执行 | GLM-5V-Turbo | 配合 OpenClaw/Claude Code,开启多模态工具链 |
手机App自动化操作、跨应用任务流执行 | AutoGLM-Phone | 部署 ADB 环境,通过框架下发自然语言指令 |
🛠️ 进阶玩法:模型串联 pipeline
在实际企业级场景中,往往需要多模型协同:
[GLM-OCR] 解析合同/发票 → 提取结构化JSON
    ↓
[GLM-4.1V-Thinking] 对关键指标进行逻辑校验与风险推理
    ↓
[GLM-5V-Turbo] 生成审批流前端页面或自动化执行脚本
    ↓
[AutoGLM-Phone] (可选) 在手机端完成最终审批点击与消息推送
通过 API 统一接入 zai-sdk,可轻松搭建高可用、低延迟的视觉智能工作流。
📝 四、 总结
智谱 GLM 视觉家族已形成清晰的**“垂直专精 + 通用基座 + 端侧执行”**矩阵:
- 追求极致性价比与文档精度 → 选
GLM-OCR - 需要长上下文与多模态工具调用 → 选
GLM-4.6V - 强逻辑推理与科学计算 → 选
GLM-4.1V-Thinking - 视觉编程与 Agent 自动化 → 选
GLM-5V-Turbo - 手机端 GUI 操控 → 选
AutoGLM-Phone
多模态大模型已进入“场景定义模型”的时代。建议开发者先明确业务链路中的感知、推理、执行边界,再按需组合调用。智谱统一的 API 规范与完善的 SDK 生态,已为快速落地扫清了技术障碍。
欢迎在评论区分享你的业务场景与调用实践,一起探讨多模态 Agent 的落地边界!👇
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2026-04-20,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号