利用AI技术实现道路运输许可证自动化识别,通过计算机视觉与自然语言处理,高效准确地提取许可证信息
原创
利用AI技术实现道路运输许可证自动化识别,通过计算机视觉与自然语言处理,高效准确地提取许可证信息
原创
中科逸视OCR
发布于 2026-11-05 18:26:06
发布于 2026-11-05 18:26:06
如果你在物流公司干过审核,大概率经历过这样的场景:司机拍来一张道路运输经营许可证,歪的、糊的、皱的,还得配上手机屏幕反光"限量版"。审核员得眯着眼把业户名称、许可证号、经营范围、有效期限一个个敲进系统——一家企业动辄几十分钟,敲错了还得返工。
道路运输经营许可证识别技术,就是让 AI 来干这个"眯眼敲字"的活:拍张照,几秒钟,一张许可证变成一份规规矩矩的结构化数据。下面咱们拆开看看,它是怎么做到的。
先说清楚:它不是"扫描仪",而是"读证件的人"
传统 OCR(光学字符识别)的思路是"看到字就抄下来",抄完给你一堆零散的文字块,你还得自己对号入座。
道路运输经营许可证识别系统走的是另一条路:计算机视觉(CV)负责"看",自然语言处理(NLP)负责"懂"。它不光认字,还知道哪行是"业户名称"、哪行是"经营范围"、这行内容跟那个标签是不是一家的。从拍照到输出可用的数据,整个流程一气呵成,不需要人工在中间"翻译"。
技术原理:四步流水线,步步有讲究
整个过程可以想象成一条工厂流水线,一共四道工序。
第一步:先给照片"洗个澡"——图像预处理
现实中的证件照片五花八门:灯光暗的、拍歪的、纸皱的、背景全是方向盘的。系统先做两件事:
- 图像增强:用基于生成对抗网络(GAN)的算法,自动调亮度、拉对比度、去噪点,相当于给照片"美颜",但美的是清晰度;
- 几何矫正:通过定位证件的四个角点,用单应性矩阵把一张歪歪扭扭的照片"掰正"成标准的正面视图。
这一步的目的是给后面的识别环节交一份干净的作业,地基打好了楼才稳。
第二步:把字"圈出来"——文本检测
全国各省市、不同年份发的许可证,版式都不完全一样,"经营范围"这栏还忽长忽短。系统采用 PSENet 这类像素级分割算法,在图上给每一个文字区域画框——哪怕是弯曲的、挤在一起的、被章压了一半的字,也能精准圈出来。
简单说:先找到"字在哪",再谈"字是什么"。
第三步:把字"认出来"——文本识别
圈好之后,就轮到基于注意力机制的 Transformer 模型上场,一个字符一个字符地读。针对许可证里汉字、数字、字母混排的情况,模型在大量交通证件数据上做过专项训练。
更妙的是,像"许可证号"这种有固定编码规则的字段,系统会拿规则去反向校验——比如把认错的小写"l"改回数字"1","0"和"O"这种长得像的双胞胎也能分清。相当于 AI 认完字,还有个较真的老师傅逐字核对。
第四步:把字"读懂"——语义理解与结构化
这是它和普通 OCR 拉开差距的地方:
- 键值对绑定:通过版面分析模型理解"业户名称:XX 物流公司"这种对应关系,哪怕标签和内容离得比较远也能配对成功;
- 实体抽取:"经营范围"里那一长串"普通货运、危险货物(3类、5类1项……)(剧毒化学品除外)",系统会用 NER 技术提取出具体的运输类别;
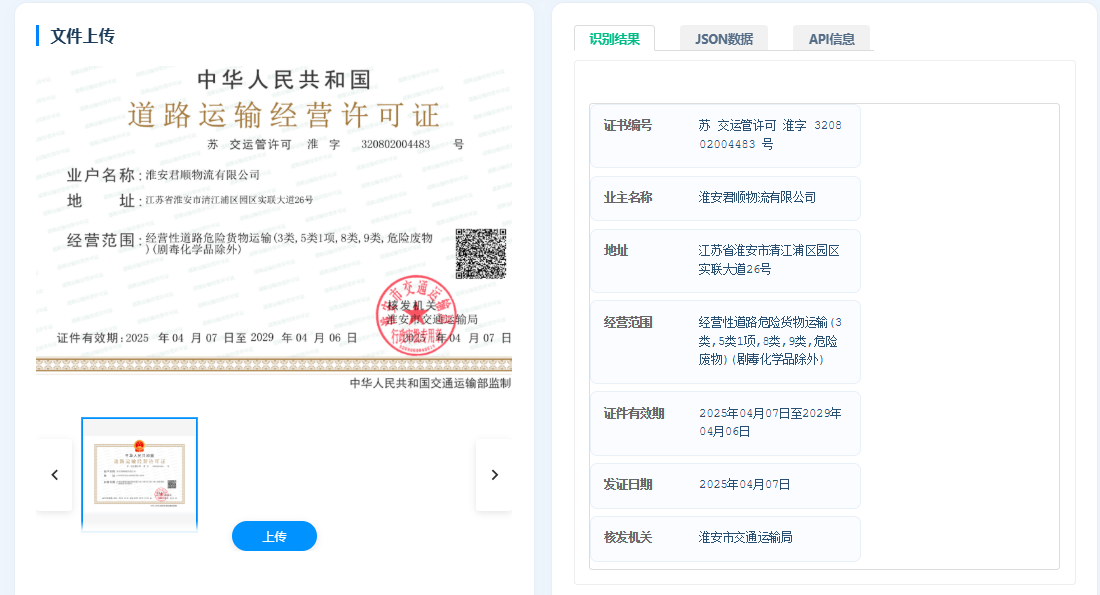
四步走完,输出的是一份字段齐全、经过校验的 JSON 数据,可以直接塞进业务系统,而不是一堆需要人工整理的文字碎片。
几个难啃的硬骨头,它是怎么啃的
- 红章压字:许可证上一般都盖着红色公章,正好压在黑字上。系统通过颜色空间分离加上深度学习去章算法,把红章"抠掉",把底下的字还原出来;
- 版式五花八门:全国各省历史版式一大堆。系统用了少样本学习(Few-shot Learning)机制,遇到新版本式,只需少量标注样本微调一下就能适配,不用推倒重训;
照片质量感人:司机在颠簸的路边随手一拍,糊了。系统内置超分辨率重建模块,先"修图"再识别,极端条件下也能把信息捞回来。
功能特点,一句话版清单
全字段识别,重点不漏
- 覆盖业户名称、许可证号、经营地址、经济类型、发证机关、发证日期、有效期、经营范围等核心字段,正本副本都支持,长文本经营范围也能完整提取,不会截断。
抗造,适配真实拍摄场景
- 手机随手拍、扫描件、PDF 文件都能接;倾斜、轻微褶皱、反光、红章遮挡、暗光环境,都有不错容错,不用大家专门找灯光、摆正证件再拍。
毫秒级出结果,支持批量处理
- 单张识别速度很快,适合前台实时核验;同时支持异步批量上传,一大堆承运商资质材料一次性处理,不用一张一张排队上传。
输出结构化数据,直接对接系统
- 识别结果以标准 JSON 输出,不用人工二次整理,直接喂给 TMS 物流系统、运政监管平台、风控台账、ERP,打通数据流转。
部署灵活,兼顾安全需求
- 公有云 API 轻量接入,适合中小平台;也支持私有化本地部署,数据不出内网,满足政务、大型物流企业的数据合规要求,同时适配国产软硬件生态。
适配多版式,上新证不用反复改模板
- 依托少样本学习,遇到地方新版式、改版证件,少量样本就能快速适配,不用整套模型重新训练,迭代更快。
这技术都用在哪?
- 物流平台入驻审核:货运平台每天新入驻成百上千家企业,AI 自动采集、自动核验,把审核从"小时级"压到"秒级";
- 政府行业监管:接入交通主管部门的监管平台,批量核验、合规监测,从"人防"走向"技防";
- 企业年审:运输企业年审时快速提取信息、核验有效期,还能在证件快到期时自动提醒,避免"证过期了才知道"的尴尬;
- 执法与路面稽查:执法人员用移动终端一拍,秒级读证并比对数据库,过期证、伪造证无所遁形;
- 保险与金融风控:保险公司核保、金融机构授信时,快速拿到运输企业真实的经营资质,作为风险评估的依据。
写在最后
说到底,道路运输经营许可证识别技术的价值不是"识别"本身,而是它把一张张纸质的许可证,变成了机器能读懂、系统能直接用的高质量数据。物流审核快了,监管准了,风控有底了。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号