illumina芯片负数矩阵竟然也可以分析,只是结果诡异-学徒作业

illumina芯片负数矩阵竟然也可以分析,只是结果诡异-学徒作业

生信菜鸟团
发布于 2023-09-09 17:13:45
发布于 2023-09-09 17:13:45
1- 作业链接
不正常的illumina芯片数据如果使用lumi包的lumiR.batch函数读取会失败 (qq.com)
《不正常的illumina芯片数据如果使用lumi包的lumiR.batch函数读取会失败》
2- 作业内容
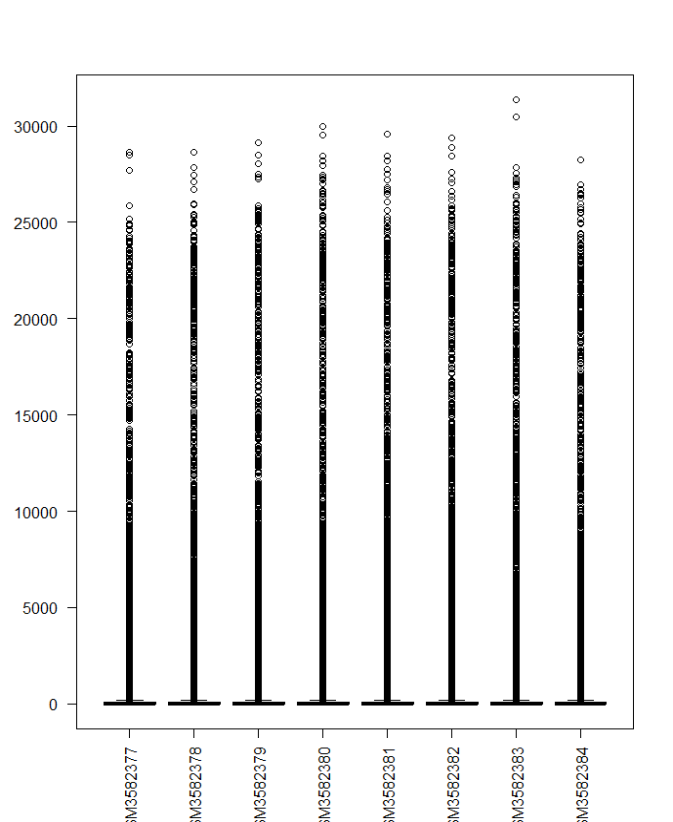
表达量矩阵箱线图如下:
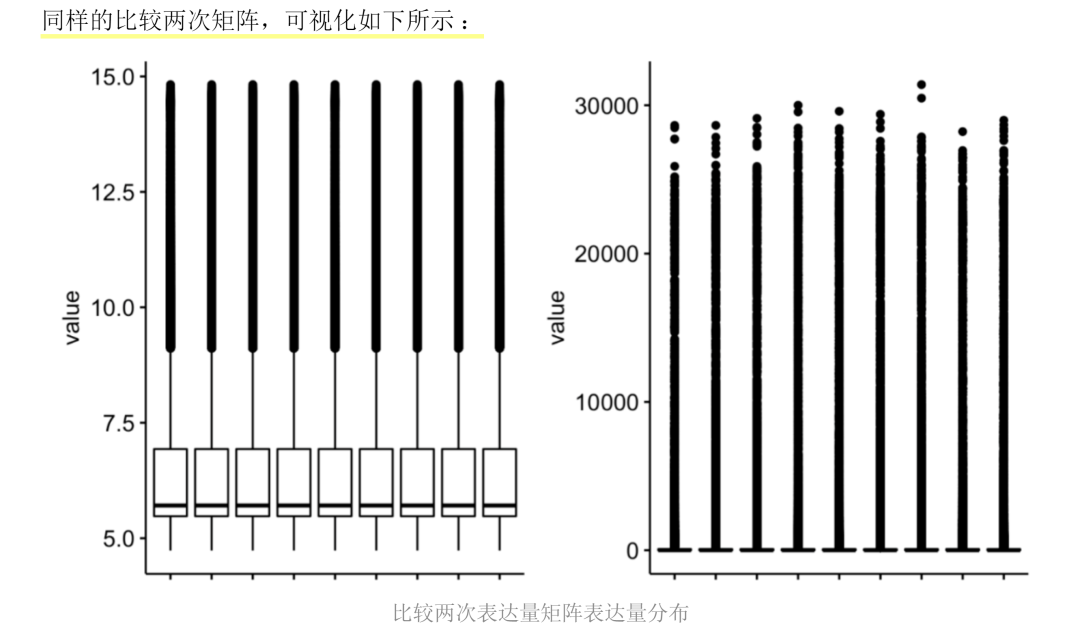
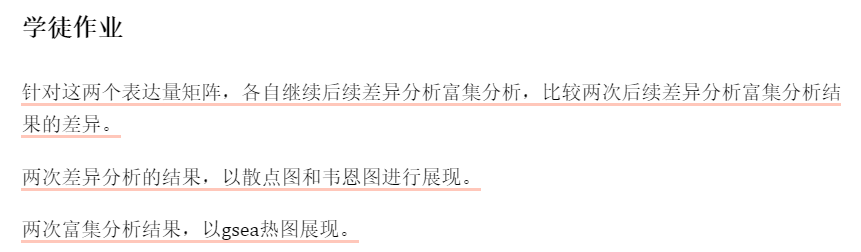
小结:
1- 先获得这两个数据集,两个表达量矩阵分别差异分析,富集分析,比较差异富集分析结果的差异
2- 差异结果,画散点图和韦恩图画结果
3- 富集结果,画GSEA热图
3- 箱线图复现
3.1 左侧箱线图(lumiR.batch读取矩阵)
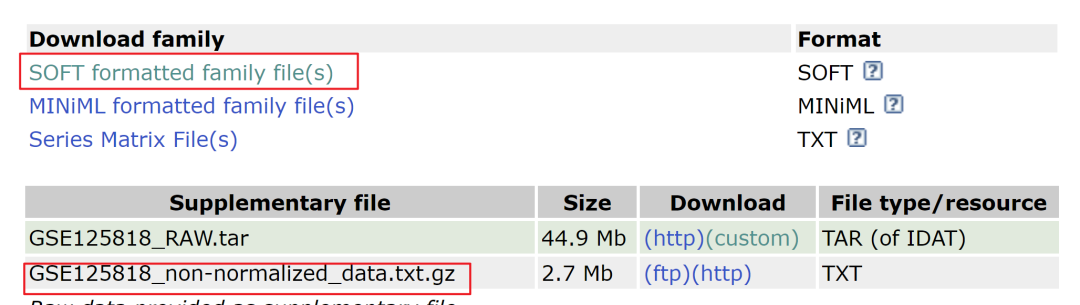
3.1.1 数据准备
GEO Accession viewer (nih.gov)下载以下2个文件放在工作目录
3.1.2 复现代码与结果
# 复现推文结果
rm(list = ls())
options(stringsAsFactors = F)

library(GEOquery)
library(limma)
library(annotate)
library(lumi)

studyID='GSE125818'
fileName <- 'GSE125818_non-normalized_data.txt' # Not Run
#x.lumi <- lumiR.batch(fileName)
library(R.utils)
# gunzip("GSE125818_non-normalized_data.txt.gz") # 手动下载文件并解压
a=read.table(fileName,header = T,sep = '\t')
dim(a)

GPL_data_2 <- getGEO(filename = 'GSE125818_family.soft.gz', AnnotGPL = F,getGPL = F)
#save(GPL_data_2,file="GSE125818_getGEO.Rdata")
npd=GPL_data_2@gsms
pdname=names(unlist(lapply(npd, function(ppdd){ppdd@header$title})))#获取样本名称
pdname
pd=unname(unlist(lapply(npd, function(ppdd){ppdd@header$title})))#获取样本代码编号
pd
colnames(a)=c('PROBE_ID',paste(pd,
                               rep(c('AVG_Signal','Detection Pval'),9)
                               ,sep='.'))
colnames(a)
write.table(a,file = 'tmp.txt',sep = '\t',quote = F)
x.lumi <- lumiR.batch('tmp.txt') ##, sampleInfoFile='sampleInfo.txt')
pData(phenoData(x.lumi))
## Do all the default preprocessing in one step
#lumi.N.Q <- lumiExpresso(x.lumi, normalize = F)
lumi.N.Q <- lumiExpresso(x.lumi)
### retrieve normalized data
dat <- exprs(lumi.N.Q)
dim(dat)#看一下dat这个矩阵的维度
# GPL13667
dat[1:4,1:4] #查看dat这个矩阵的1至4行和1至4列,逗号前为行,逗号后为列
# PBMC_IgAN1 (array) PBMC_IgAN3 (array) PBMC_IgAN5 (array) PBMC_HC2 (array)
# ILMN_1762337           5.569807           5.508666           5.579357         5.660291
# ILMN_2055271           5.806544           5.594331           5.935723         5.500253
# ILMN_1736007           5.347042           5.519961           5.486298         5.545353
# ILMN_2383229           5.640962           5.618221           5.833357         5.839585
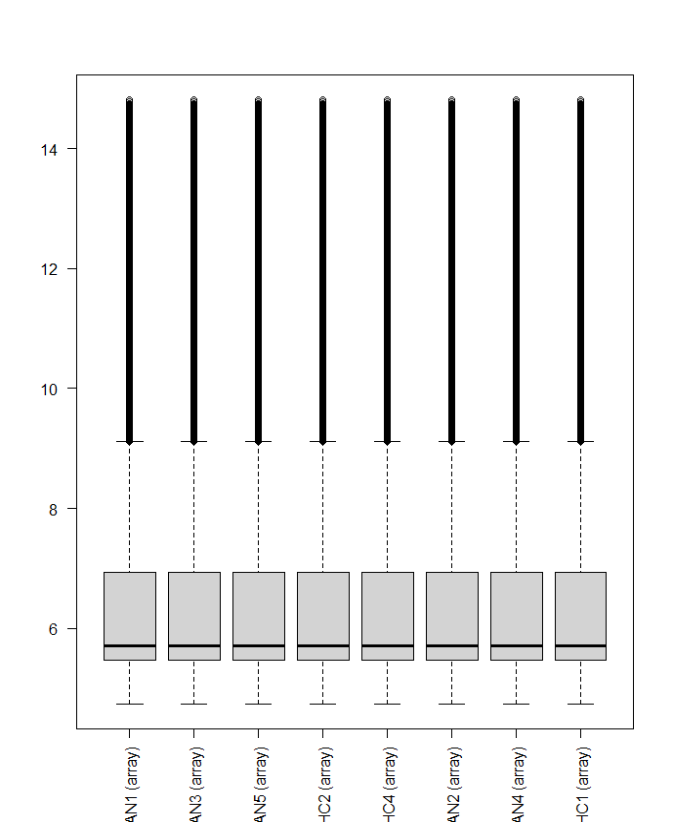
boxplot(dat[ ,1:8],las=2) # 左图复现完成
save(dat,file="1_main_1.Rdata")
结果:与目标左图一致
3.2 右侧箱线图(getGEO读取矩阵)
3.2.1 数据准备
无
3.2.2 复现代码与结果
# 右侧图代码
rm(list = ls())
options(stringsAsFactors = F)
f='GSE125818_eSet.Rdata'
# https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE125818
library(GEOquery)
# 这个包需要注意两个配置,一般来说自动化的配置是足够的。
#Setting options('download.file.method.GEOquery'='auto')
#Setting options('GEOquery.inmemory.gpl'=FALSE)
if(!file.exists(f)){
  gset <- getGEO('GSE125818', destdir=".",
                 AnnotGPL = F,     ## 注释文件
                 getGPL = F)       ## 平台文件
  save(gset,file=f)   ## 保存到本地
}
load('GSE125818_eSet.Rdata')  ## 载入数据
class(gset)  #查看数据类型
length(gset)  #
class(gset[[1]])
gset
# 因为这个GEO数据集只有一个GPL平台,所以下载到的是一个含有一个元素的list
a=gset[[1]] #
dat=exprs(a) #a现在是一个对象,取a这个对象通过看说明书知道要用exprs这个函数
dim(dat)#看一下dat这个矩阵的维度
# [1] 47315     9
# GPL13667
dat[1:4,1:4] #查看dat这个矩阵的1至4行和1至4列,逗号前为行,逗号后为列
# GSM3582377   GSM3582378   GSM3582379   GSM3582380
# ILMN_1343291 24883.620000 27447.080000 27370.200000 28187.110000
# ILMN_1343295  4642.974000  3839.610000  4329.715000  4486.146000
# ILMN_1651199    -6.188349    -5.960838    -1.866697    -2.246824
# ILMN_1651209    18.789020    13.068600    29.756870    26.723110
boxplot(dat[ ,1:8] ,las=2)
apply(dat[ ,1:4], 2, min)
# GSM3582377 GSM3582378 GSM3582379 GSM3582380
# -20.09653  -16.76761  -20.52279  -18.73800
save(dat,file = 'dat_from_GEOquery.Rdata')
save(dat,file="1_main_2.Rdata")
apply(dat[ ,1:4], 2, min)
# GSM3582377 GSM3582378 GSM3582379 GSM3582380
# -20.09653  -16.76761  -20.52279  -18.73800
apply(dat[ ,1:4], 2, fivenum)
# GSM3582377    GSM3582378    GSM3582379    GSM3582380
# [1,]   -20.0965300   -16.7676100   -20.5227900   -18.7380000
# [2,]    -0.1987076    -0.1155374    -0.0840481     0.2983347
# [3,]     7.7955250     7.6259680     7.9264700     8.1877510
# [4,]    81.6684750    80.1462700    81.5019450    76.4720900
# [5,] 28640.8700000 28643.9500000 29118.6100000 29999.7300000
结果:与目标右图一致
4- 差异分析的散点和韦恩图
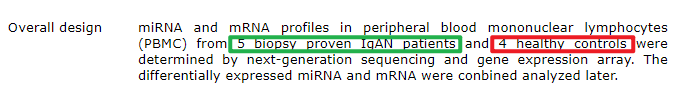
4.1 获取分组
代码:
# 2_差异分析
## 获取分组
rm(list = ls())
load(file="1_main_1.Rdata")
dat[1:4,1:4]
colnames(dat)
library(stringr)
group=ifelse(str_detect(colnames(dat),"IgAN"),"IgAN","HC")
group=factor(group,levels = c("HC","IgAN"))
group
# [1] IgAN IgAN IgAN HC   HC   IgAN IgAN HC   HC
# Levels: HC IgAN
4.1 获取ids
GEO Accession viewer (nih.gov)
## 获取ids
anno <- data.table::fread("GPL10558-50081.txt")#读取
colnames(anno)
b=anno
ID=b$ID
Symbol=b[,"ILMN_Gene"]
ids=cbind(ID,Symbol)
ids=as.data.frame(ids)
ids[1:4,]
# ID ILMN_Gene
# 1 ILMN_1343048
# 2 ILMN_1343049
# 3 ILMN_1343050
# 4 ILMN_1343052
ids = ids[ids$ILMN_Gene!="",]
ids[1:4,]
# ID ILMN_Gene
# 10  ILMN_1343291    EEF1A1
# 11  ILMN_1343295     GAPDH
# 782 ILMN_1651199 LOC643334
# 783 ILMN_1651209   SLC35E2
save(ids,group,file="ids_group.Rdata")
4.1 差异分析
差异分析代码:修改load的数据就可以换组,不重复演示
# 差异分析
rm(list = ls())
load(file="ids_group.Rdata")
load(file="1_main_1.Rdata")
#load(file='1_main_2.Rdata')
library(limma)
#DEGs、富集分析准备
##得deg 需要表达矩阵和Group,不需要改
design=model.matrix(~group)
fit=lmFit(dat,design)
fit=eBayes(fit)
deg=topTable(fit,coef=2,number = Inf)
没啥差异:查看文章比对:

没有文章
4.2 散点图(火山图)
绘图代码:以lumiR.batch为例
##1.加probe_id列,把行名变成一列
probe_id=rownames(deg)
deg=cbind(probe_id,deg)
deg[1:4,1:4]
colnames(deg)
#3.加change列,标记上下调基因
library(dplyr)
logFC_t=1
p_t = 0.05
k1 = (deg$P.Value < p_t)&(deg$logFC < -logFC_t)
k2 = (deg$P.Value < p_t)&(deg$logFC > logFC_t)
deg <- mutate(deg,change = ifelse(k1,"down",ifelse(k2,"up","stable")))
table(deg$change)
# 完成注释
colnames(ids)=c("probe_id","symbol")
new_deg=merge(deg,ids,by="probe_id")
table(new_deg$change)
#去重复
# deg<- deg[!duplicated(deg$symbol),]
# logFC_t=with(deg,mean(abs(logFC)))
# 绘制火山图
library(dplyr)
library(ggplot2)
dat  = deg[!duplicated(new_deg$symbol),]

volcano_plot <- ggplot(data = dat,
                       aes(x = logFC,
                           y = -log10(P.Value))) +
  geom_point(alpha=0.4, size=3.5,
             aes(color=change)) +
  scale_color_manual(values=c("blue", "grey","red"))+
  geom_vline(xintercept=c(-logFC_t,logFC_t),lty=1,col="black",linewidth=0.8) +
  geom_hline(yintercept = -log10(p_t),lty=1,col="black",linewidth=0.8) +
  theme_bw()
volcano_plot
dev.off()
save(volcano_plot,file="vol_1.Rdata")
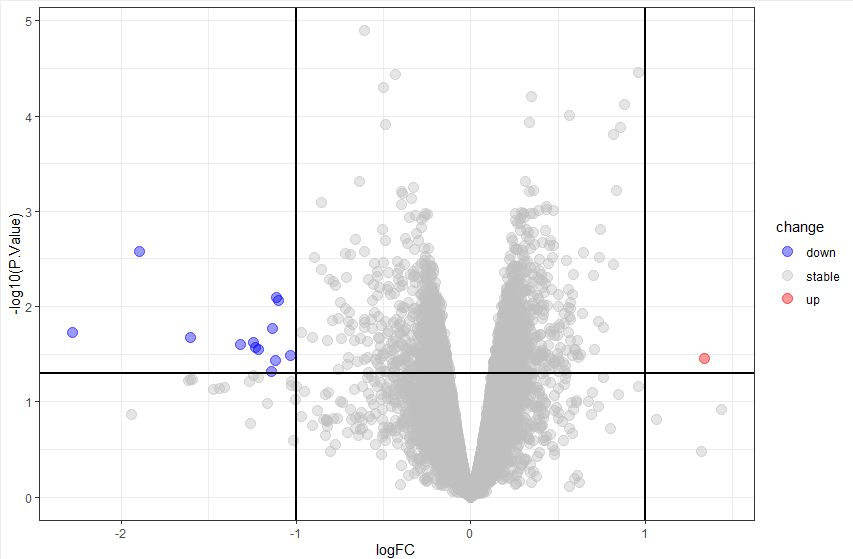
散点图结果:lumiR
getGEO
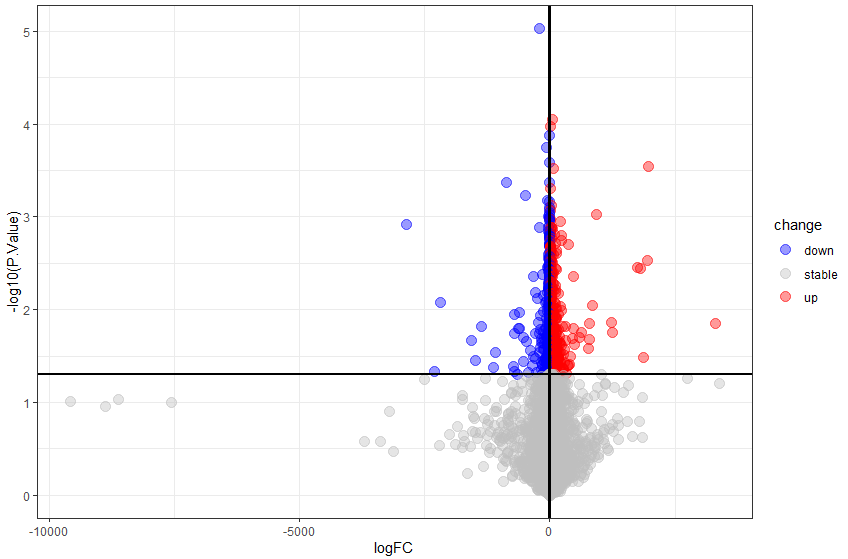
getGEO组因为logFC数值极差巨大,导致基因都聚集在y轴附近。这个时候两者都使用LogFC=1作为同一标准分别显著和不显著基因是有问题的。
4.3 韦恩图
绘图代码:
#韦恩图
## up
library(ggvenn)
gene_set1 <- rownames(deg.1[(deg.1$change == "up"),])#输入第一个基因集
gene_set2 <- rownames(deg.2[(deg.2$change == "up"),]) #输入第二个基因集

a <- list(`Gene Set 1` = gene_set1,
          `Gene Set 2` = gene_set2)
p1 <- ggvenn(a, show_elements = F,fill_color = c("white", "white","white"),
             label_sep = "\n", stroke_size = 1.5,set_name_size = 5,
             text_size = 3)
p1
条件:logFC_t = 1; pvalue_t = 0.05
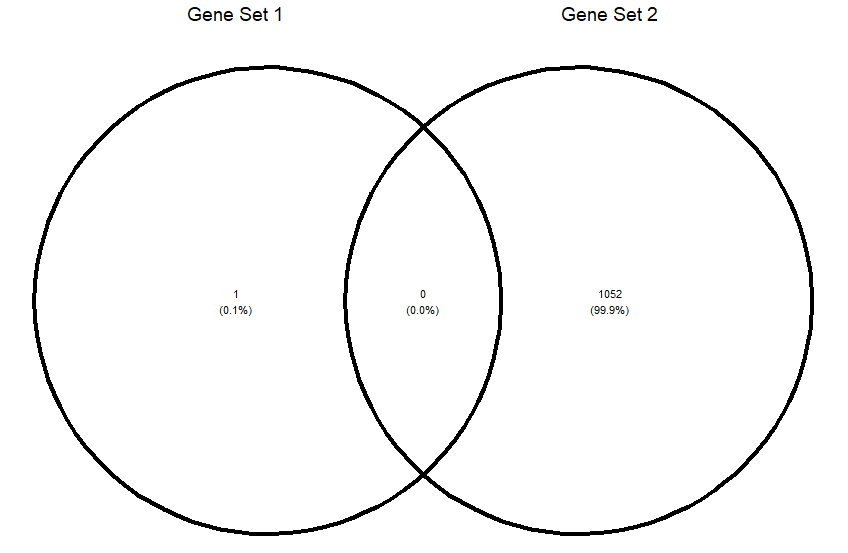
up组:没有重合的,其实正常lumi组只有一个基因
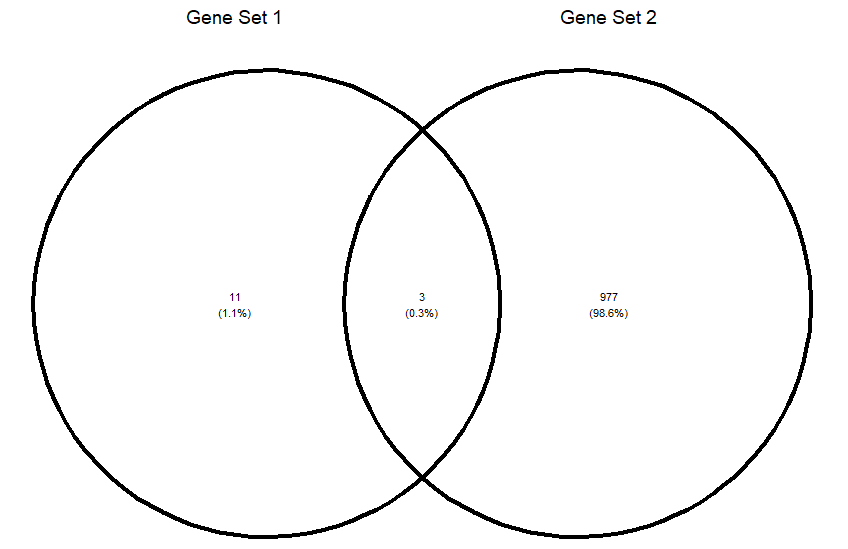
down组:lumi组14个有3个重合的
条件2:logFC_t = 0.5; pvalue_t = 0.05
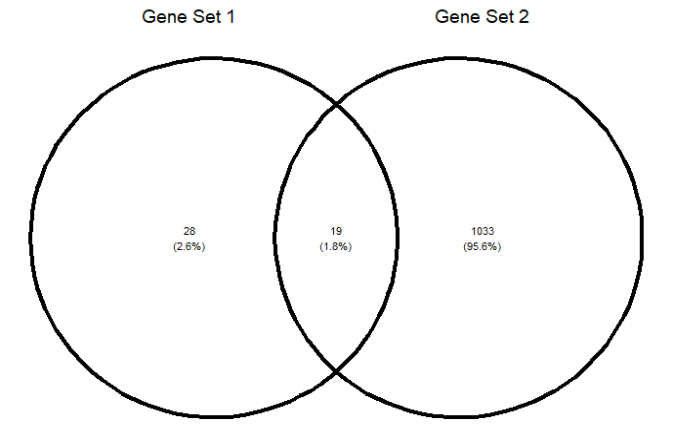
up组图:上调基因有重合,两组数据logFC值明显存在差异
down组图:基因有重合
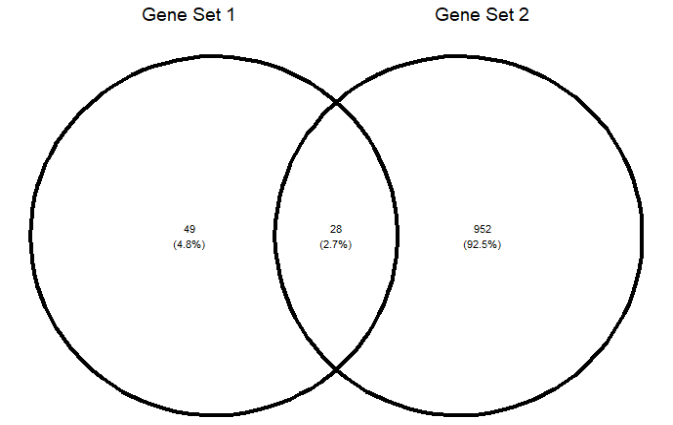
两组数据的LogFC和大小排名看来并不完全相同
5- 富集分析的GSEA热图
代码:
# GSEA富集分析
rm(list = ls())
load("2_deg.Rdata")
deg.2=new_deg
load(file="ids_group.Rdata")

deg=deg.2
# deg$symbol=rownames(deg)
suppressMessages (library(org.Hs.eg.db))
suppressMessages (library(clusterProfiler))
df <- bitr(deg$symbol,
           fromType = "SYMBOL",
           toType = "ENTREZID",
           OrgDb = org.Hs.eg.db)#人
head(df)
DEG=deg
DEG=merge(DEG,df,by.y='SYMBOL',by.x='symbol')
#save(DEG,file = 'anno_DEG_1.Rdata')
#save(DEG,file = 'anno_DEG_2.Rdata')
#load(file = "anno_DEG_1.Rdata")

library(dplyr)
library(ggplot2)
geneList=DEG$logFC
names(geneList)=DEG$ENTREZID
geneList=sort(geneList,decreasing = T)
head(geneList)

library(clusterProfiler)
kk_gse <- gseKEGG(geneList     = geneList,
                  organism     = 'hsa',#按需替换 *******
                  #nPerm        = 1000,
                  minGSSize    = 10,
                  pvalueCutoff = 0.9,
                  verbose      = FALSE)

tmp=kk_gse@result
dim(tmp)

  kk=DOSE::setReadable(kk_gse, OrgDb='org.Hs.eg.db',keyType='ENTREZID')#按需替换 *******
  tmp=kk@result
  dim(tmp)

pro='comp1'
write.csv(kk@result,paste0(pro,'_kegg_2.gsea.csv'))
save(kk,file = 'gsea_kk_2.Rdata')

# 绘图
down_k <- kk_gse[tail(order(kk_gse$enrichmentScore,decreasing = T)),];down_k$group=-1
up_k <- kk_gse[head(order(kk_gse$enrichmentScore,decreasing = T)),];up_k$group=1

dat=rbind(up_k,down_k)
colnames(dat)
dat$pvalue = -log10(dat$pvalue)
dat$pvalue=dat$pvalue*dat$group
dat=dat[order(dat$pvalue,decreasing = F),]

library(enrichplot)
gseaplot2(kk_gse,geneSetID = head(dat$ID,6),color = "firebrick", rel_heights=c(1, .2, .6))
gseaplot2(kk_gse,geneSetID = tail(dat$ID,6),color = "firebrick", rel_heights=c(1, .2, .6))
结果:
选了最显著的6个上调和下调通路绘图 上调:lumiR组:
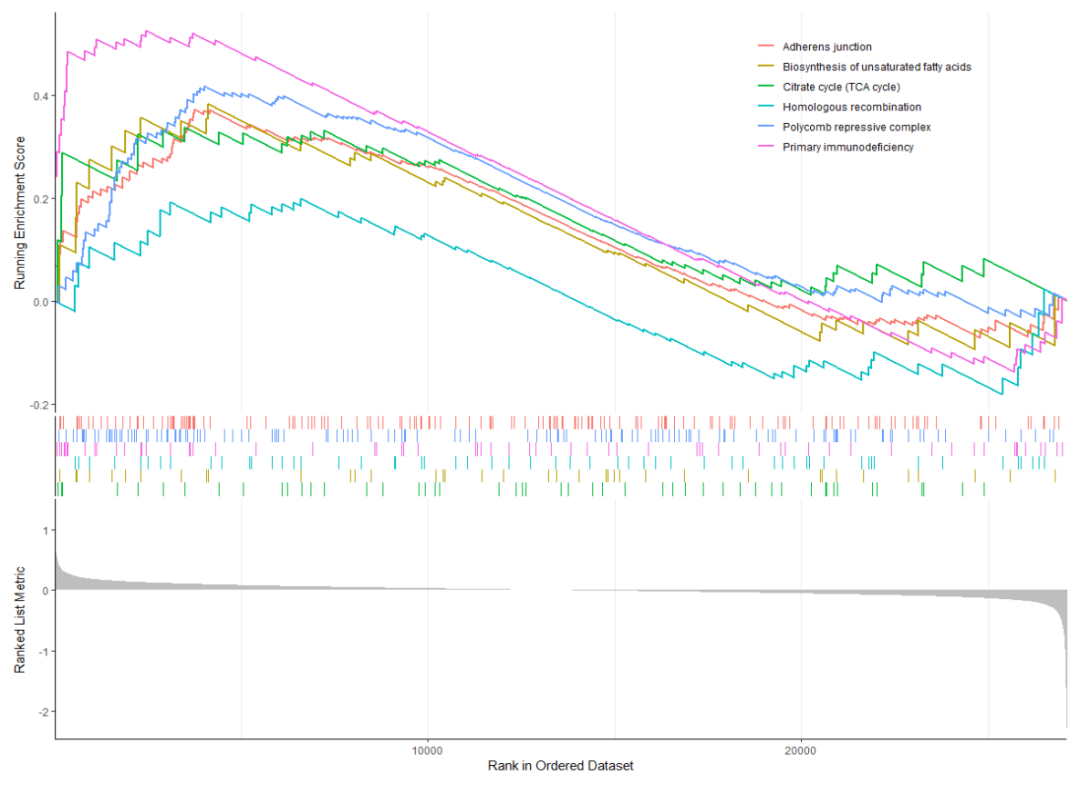
getGEO组:
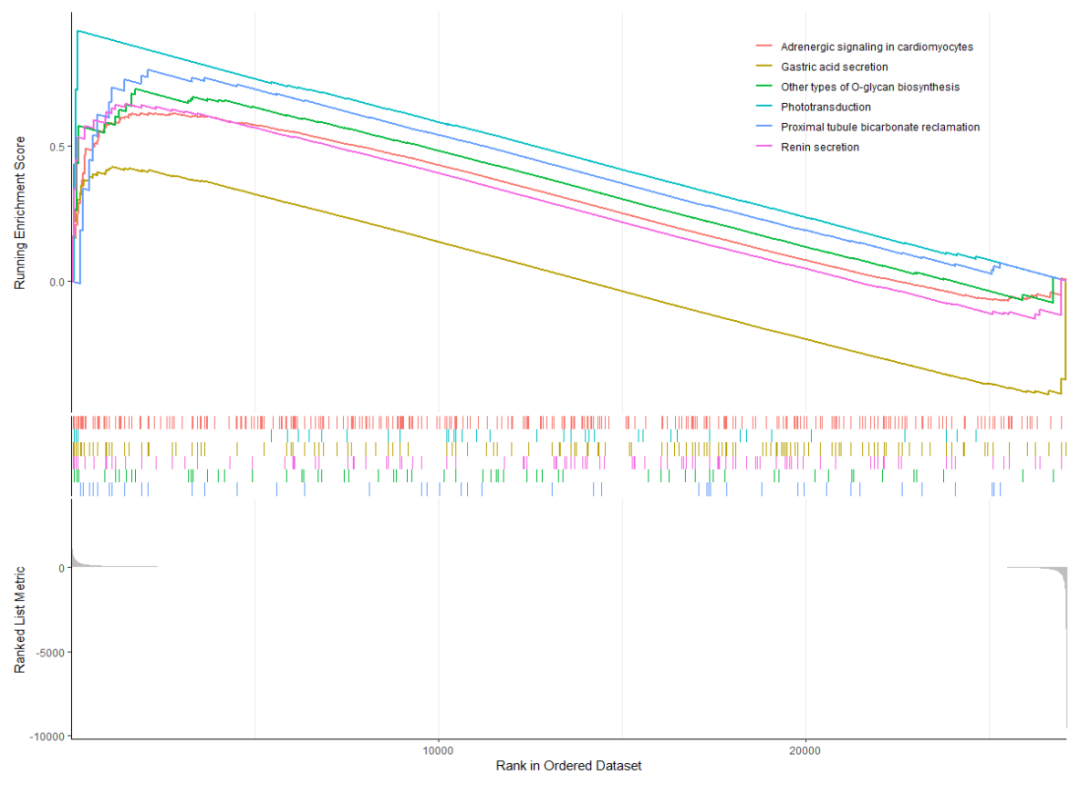
没有一个通路能对应上...
下调 lumiR组:
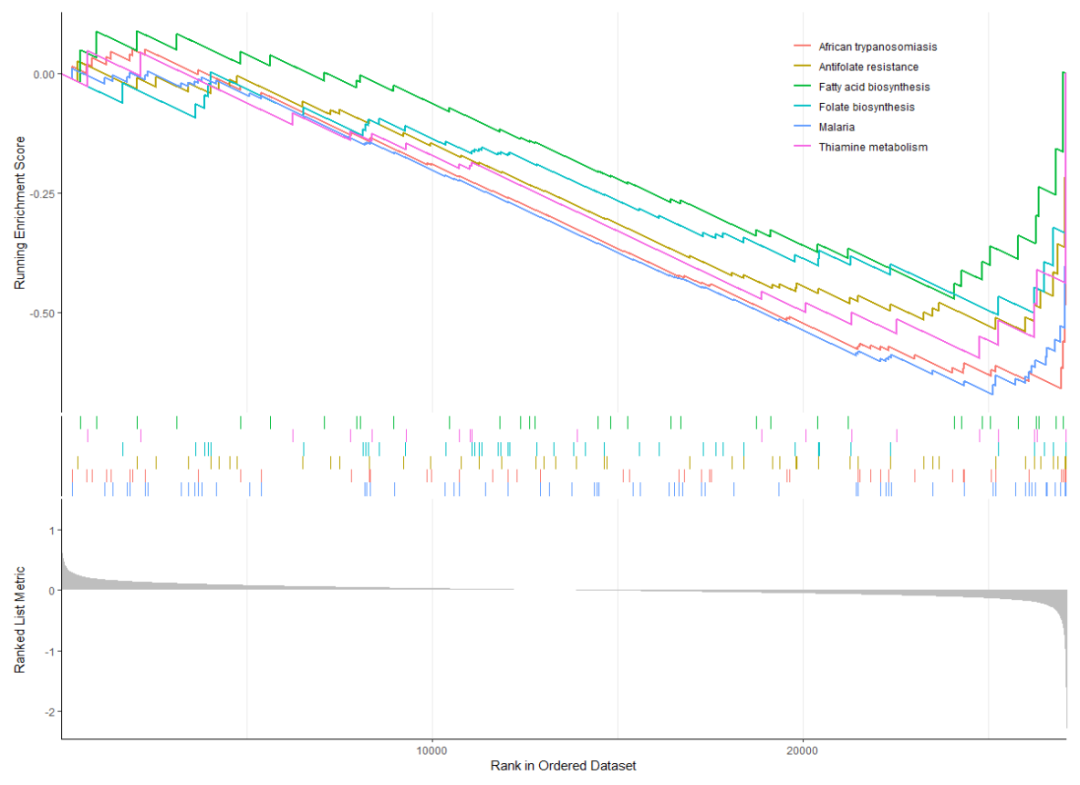
getGEO组:
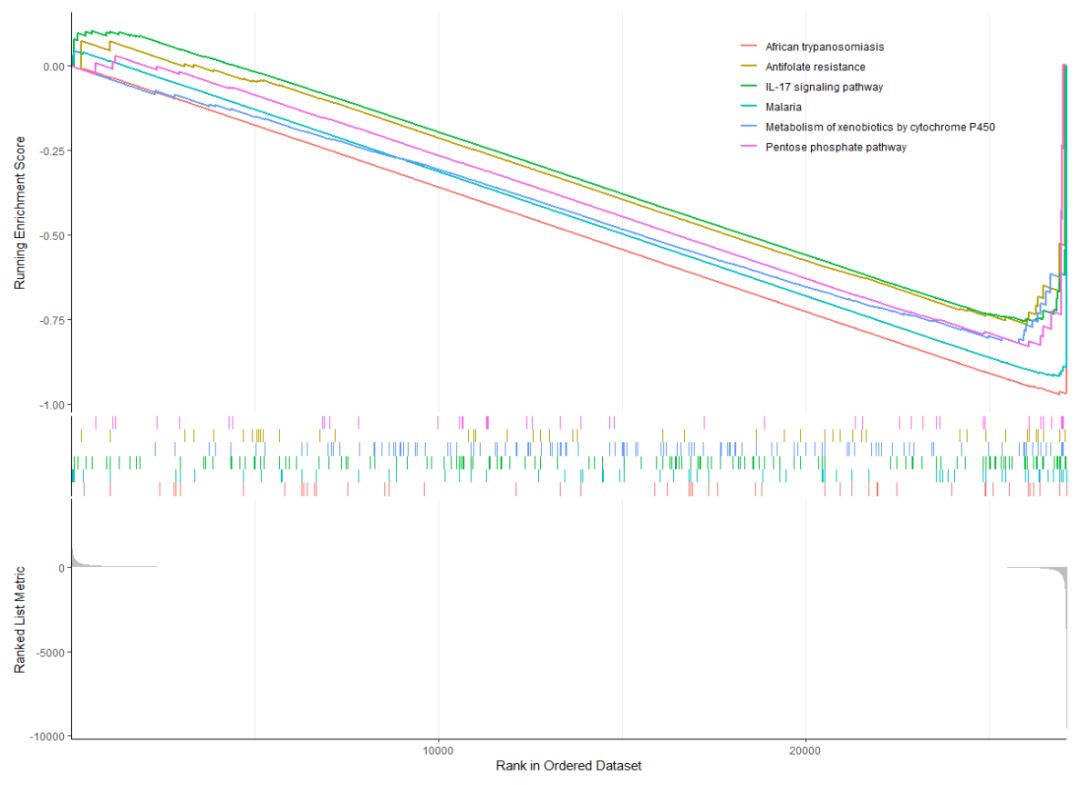
6个能对上2个
行吧
6-小结
1- 原本以为用负值做分析会出现报错,没想到竟然能画出图来...
2- 从火山图看,表达矩阵的数值过大差异直接导致火山图变形,明显说明两组差异分析的结果存在差异
3- 从韦恩图看,明显两组表达矩阵的差异分析结果的LogFC的基因排名不同
4- GSEA的结果印证了上述第3条描述。
5- 另外我觉得还有一点,在我设置logFC_t = 1; pvalue_t = 0.05为上下调基因条件时,上调结果的韦恩图没有交集基因,但下调结果是有2个交集基因的。而GSEA结果,能看到上调通路的前6位是完全没有交集的,但下调却有2个交集。觉得可能存在某种联系。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2023-08-28,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号