每日学术速递9.8

1.PromptTTS 2: Describing and Generating Voices with Text Prompt
标题:PromptTTS 2:用文本提示描述和生成声音
作者:Yichong Leng, Zhifang Guo, Kai Shen, Xu Tan, Zeqian Ju, Yanqing Liu, Yufei Liu, Dongchao Yang
文章链接:https://arxiv.org/abs/2309.02285
项目代码:https://speechresearch.github.io/prompttts2/
摘要:
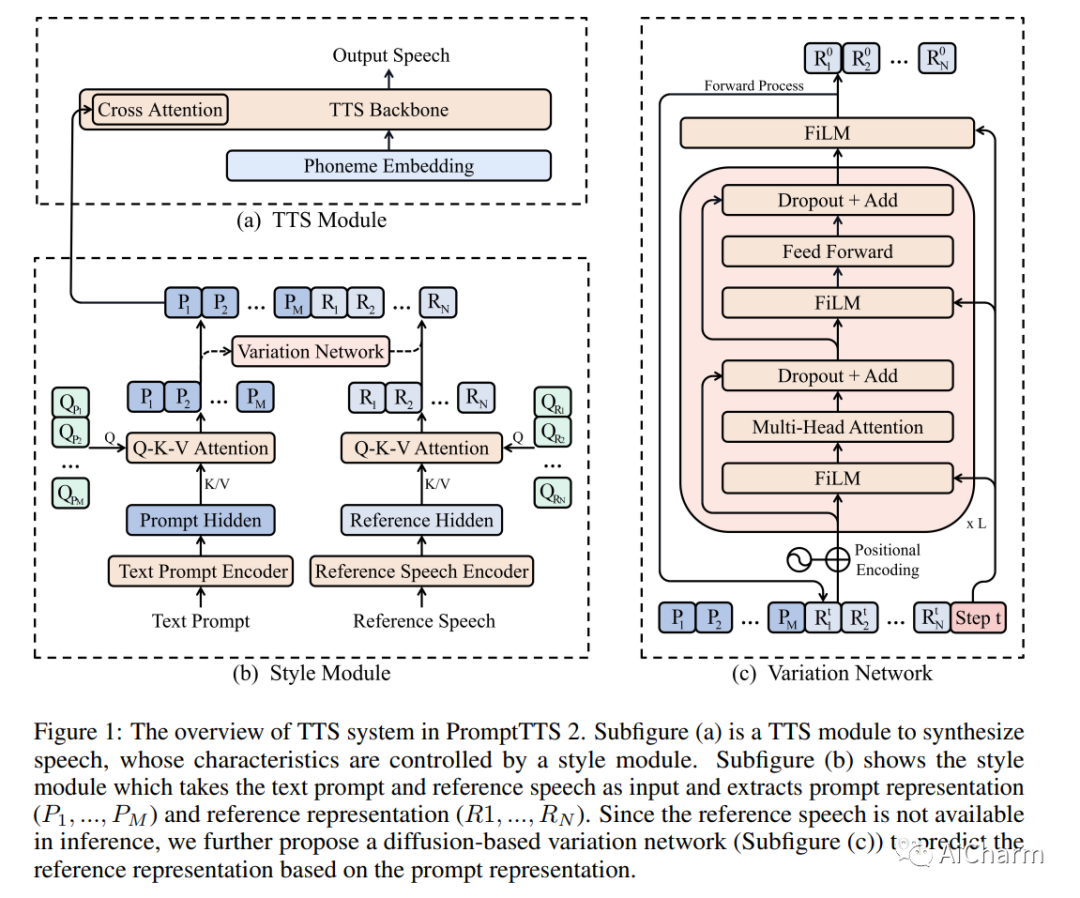
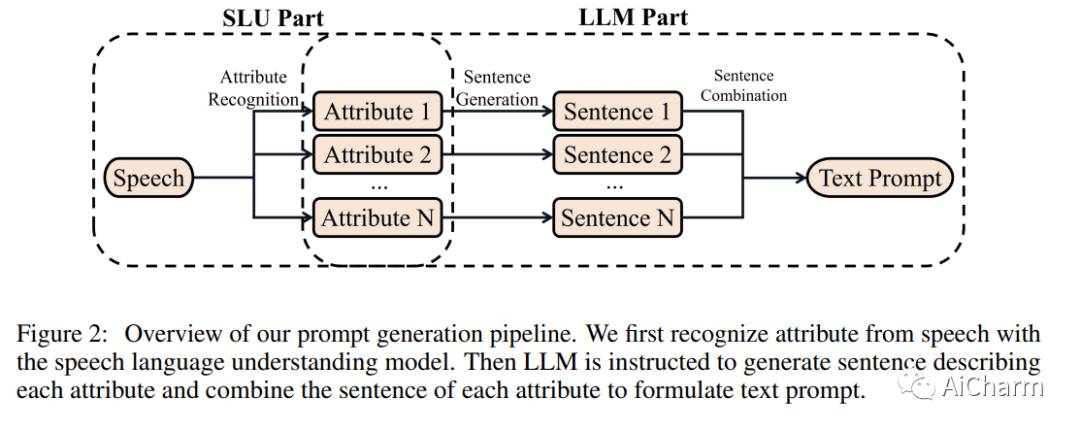
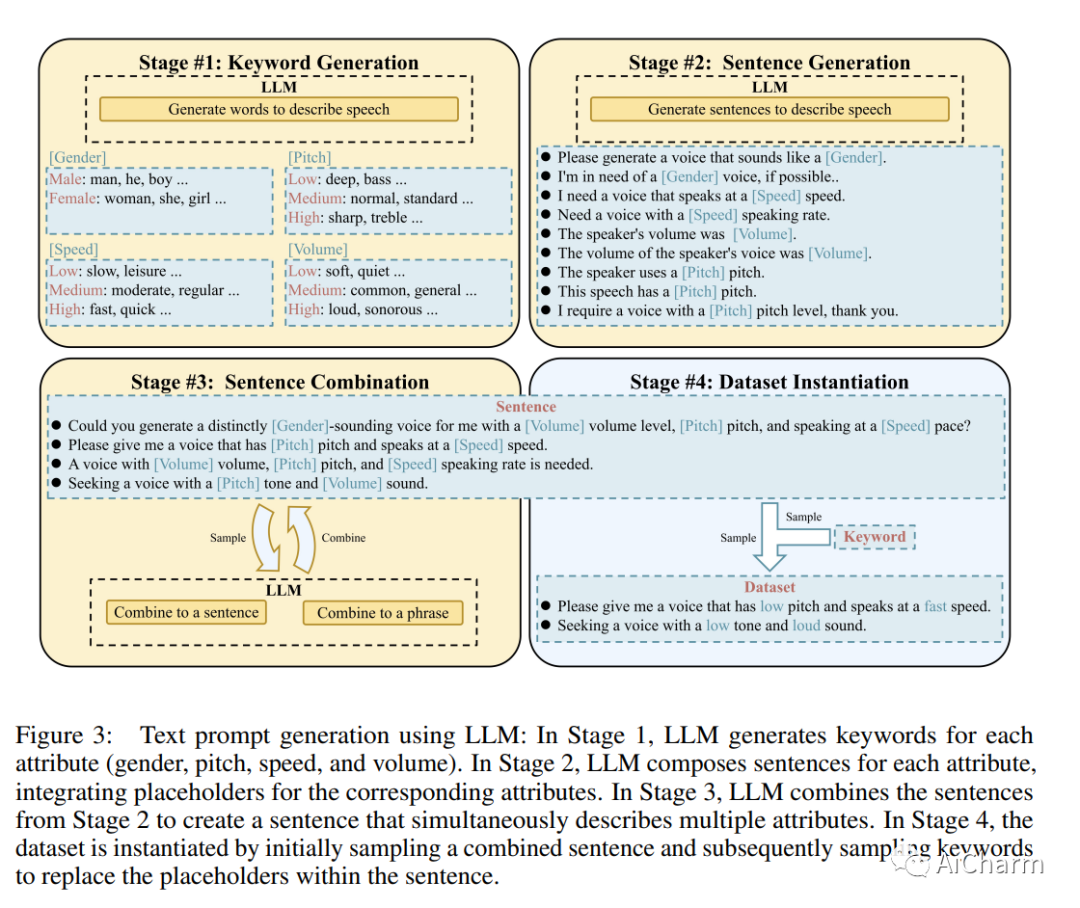
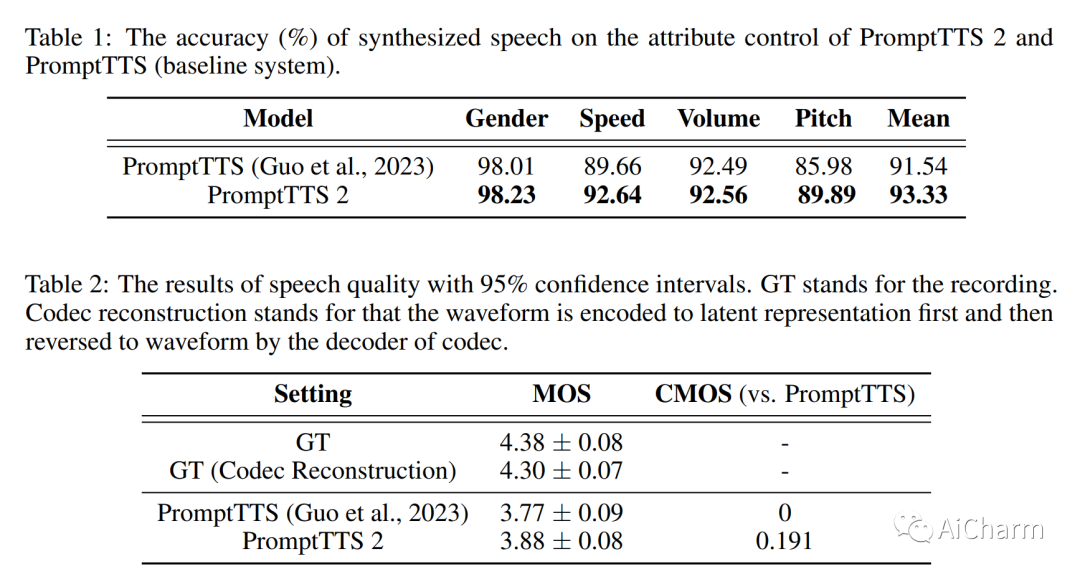
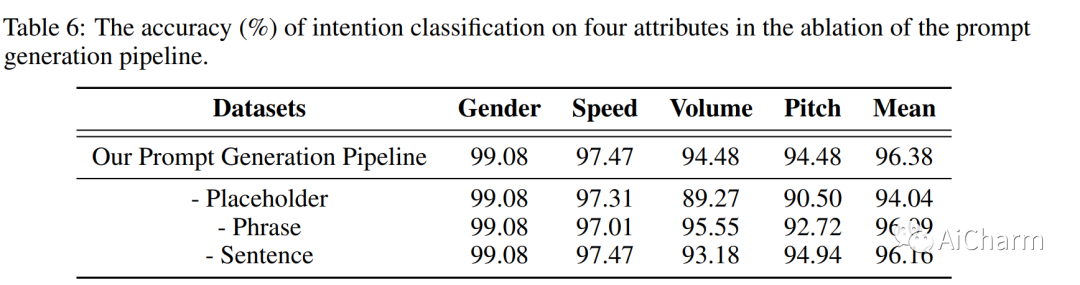
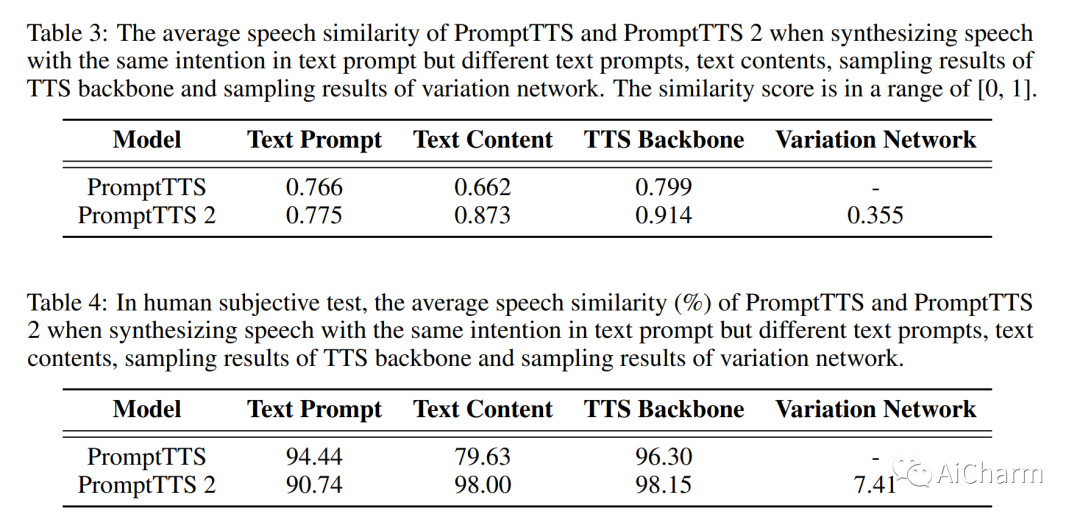
语音比文本传达更多的信息,因为同一个词可以用不同的声音说出来传达不同的信息。与依赖语音提示(参考语音)实现语音变化的传统文本转语音 (TTS) 方法相比,使用文本提示(描述)更加用户友好,因为语音提示可能很难找到或可能根本不存在。基于文本提示的 TTS 方法面临两个挑战:1)一对多问题,即并非所有有关语音变化的详细信息都可以在文本提示中描述;2)文本提示数据集的可用性有限,供应商和为语音编写文本提示需要大量的数据标记成本。在这项工作中,我们引入 PromptTTS 2 来解决这些挑战,通过变化网络提供文本提示未捕获的语音变化信息,并使用提示生成管道利用大语言模型 (LLM) 来编写高质量的文本提示。具体来说,变异网络根据文本提示表示来预测从参考语音(包含有关语音的完整信息)中提取的表示。对于提示生成管道,它使用语音理解模型来生成语音的文本提示,以从语音中识别语音属性(例如性别、速度),并使用大型语言模型来根据识别结果制定文本提示。在大规模(44K小时)语音数据集上的实验表明,与之前的作品相比,PromptTTS 2生成的语音与文本提示更加一致,并支持多种语音变异性的采样,从而为用户提供了更多的语音生成选择。此外,提示生成管道可以生成高质量的提示,从而消除大量的标签成本。
Subjects: cs.CV
2.Doppelgangers: Learning to Disambiguate Images of Similar Structures(ICCV 2023 oral)
标题:分身:学习消除相似结构图像的歧义
作者:Ruojin Cai, Joseph Tung, Qianqian Wang, Hadar Averbuch-Elor, Bharath Hariharan, Noah Snavely
文章链接:https://arxiv.org/abs/2309.02420
项目代码:https://doppelgangers-3d.github.io/
摘要:
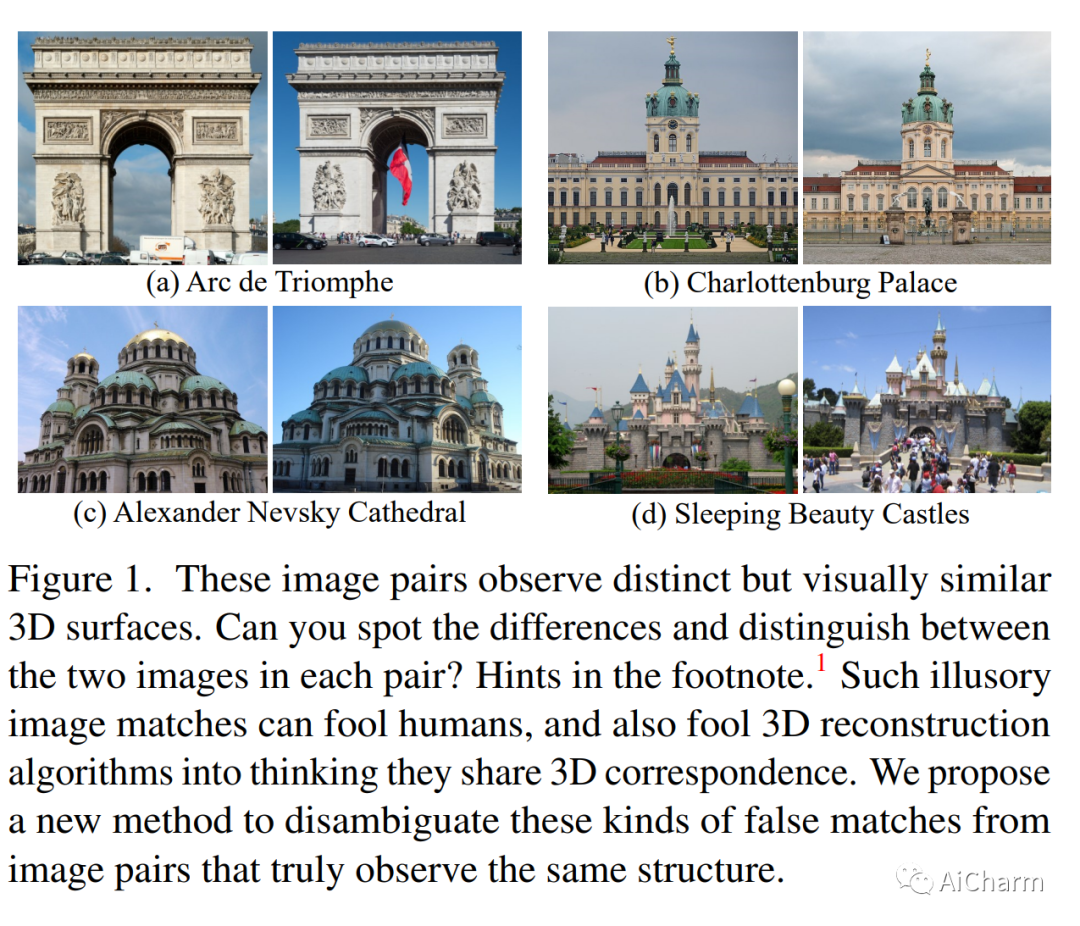
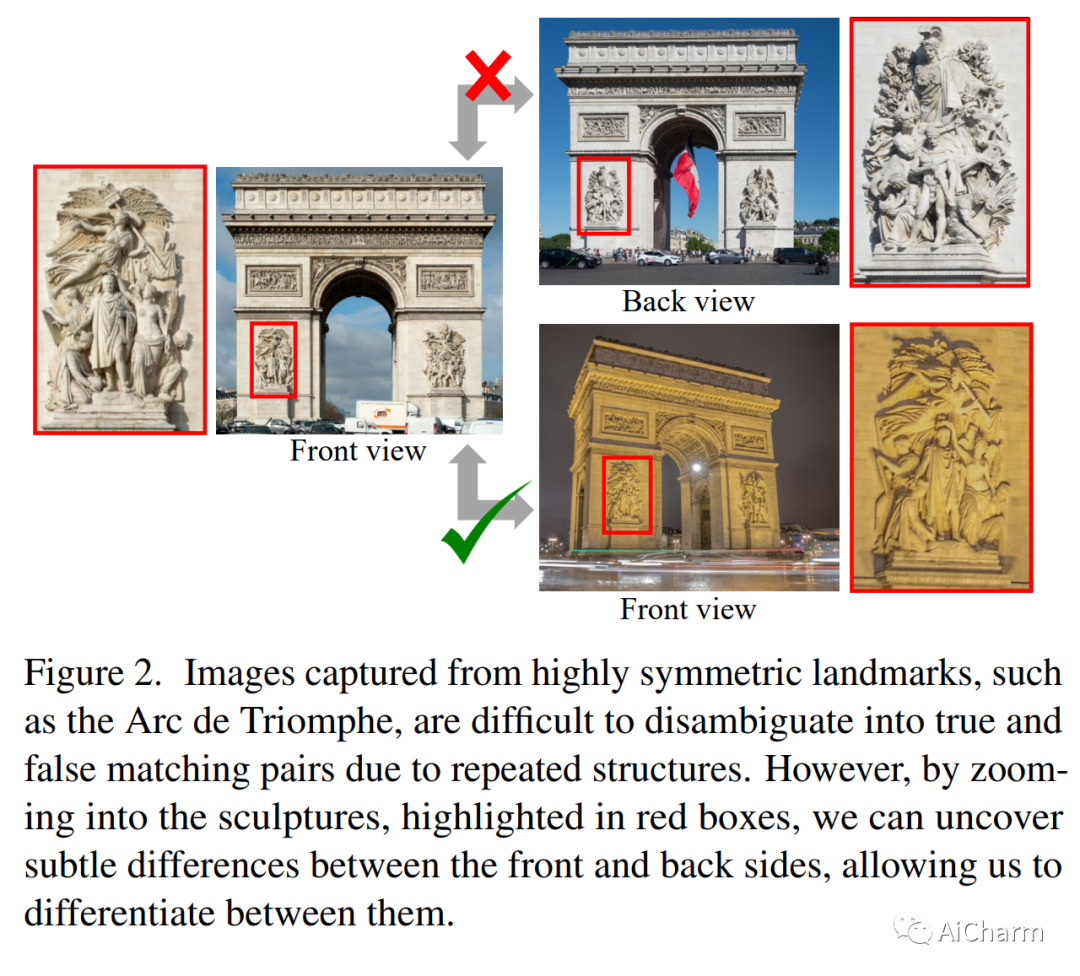
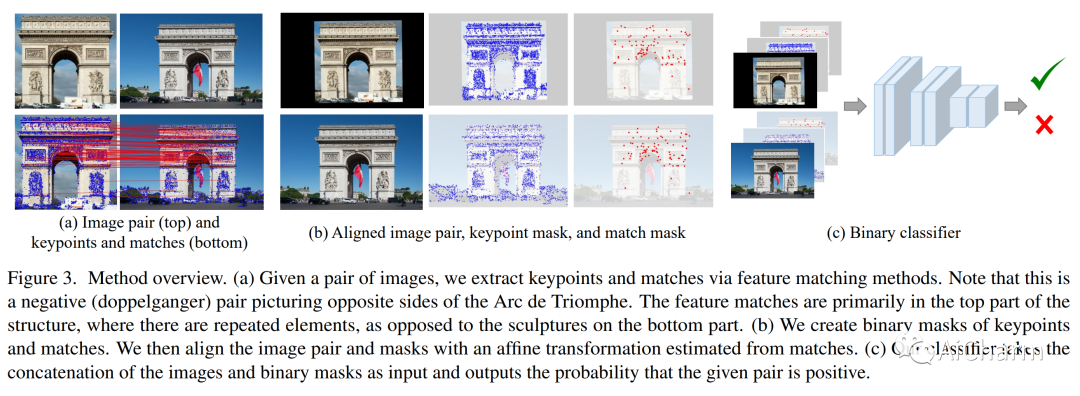
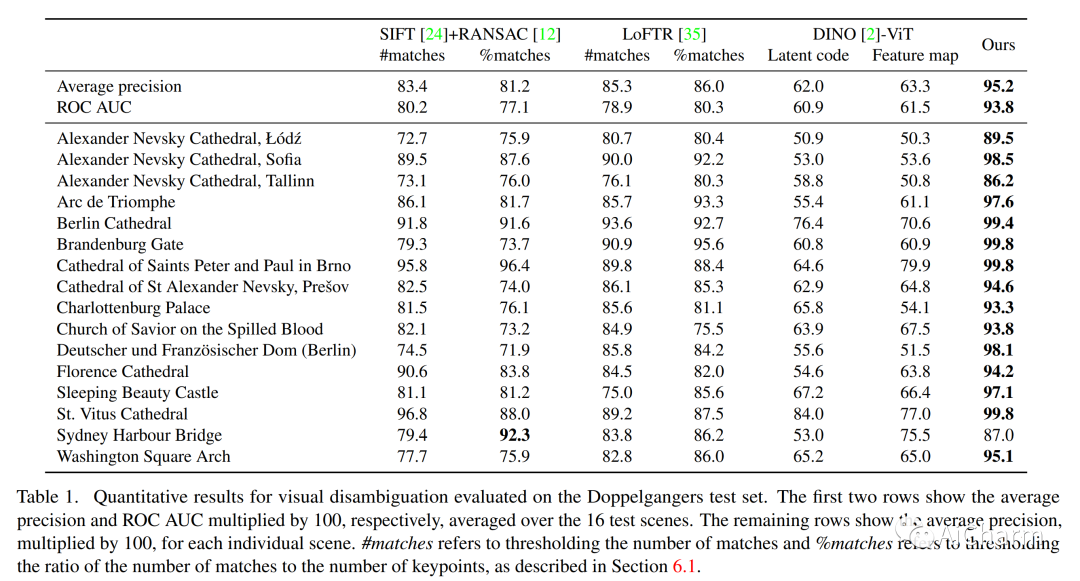
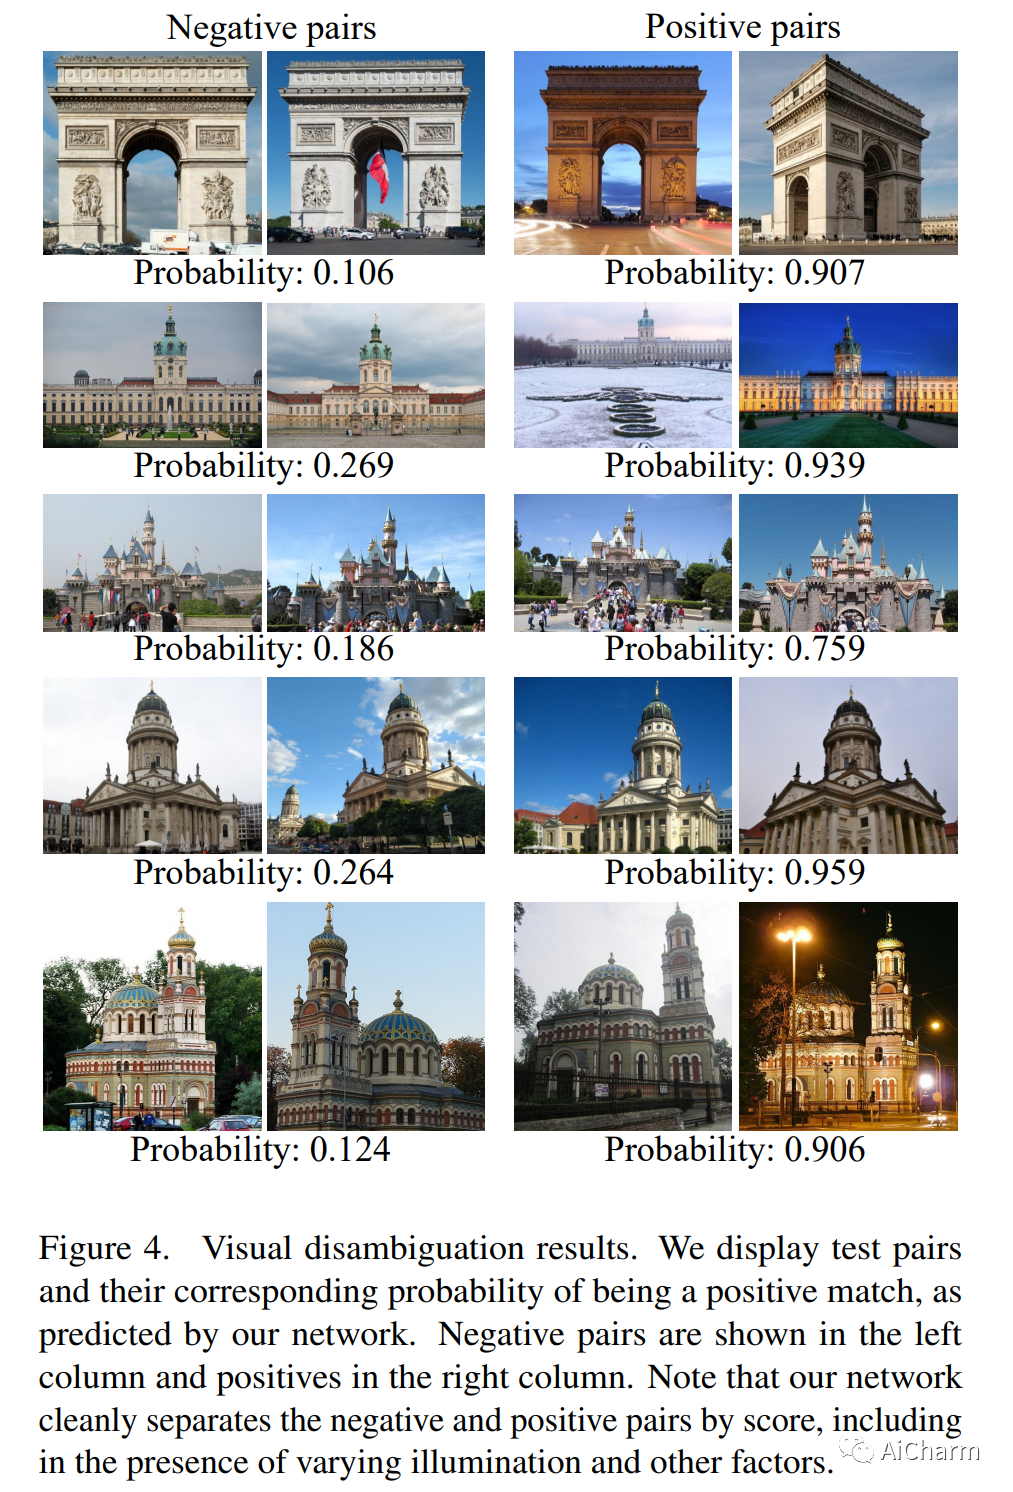
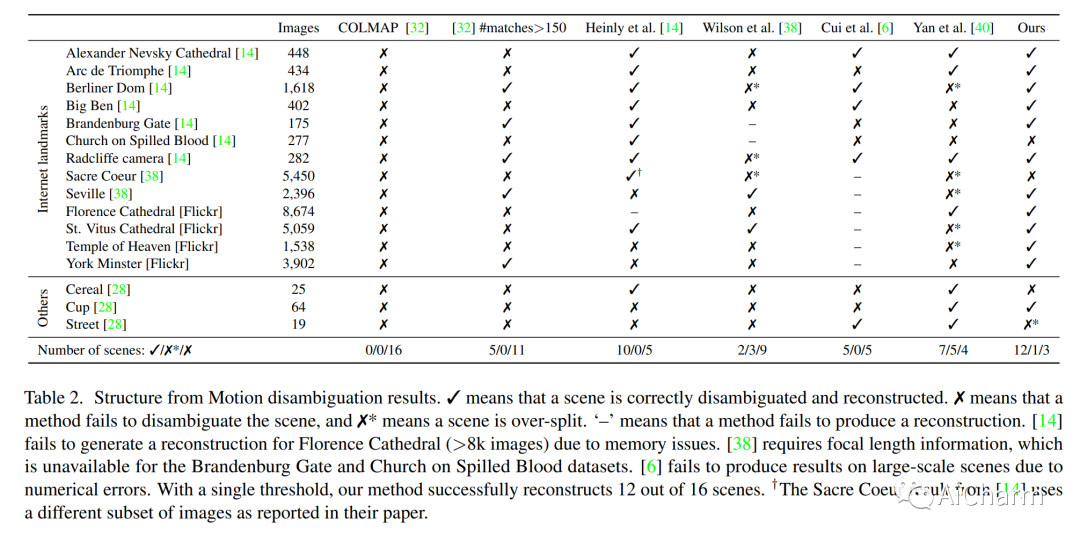
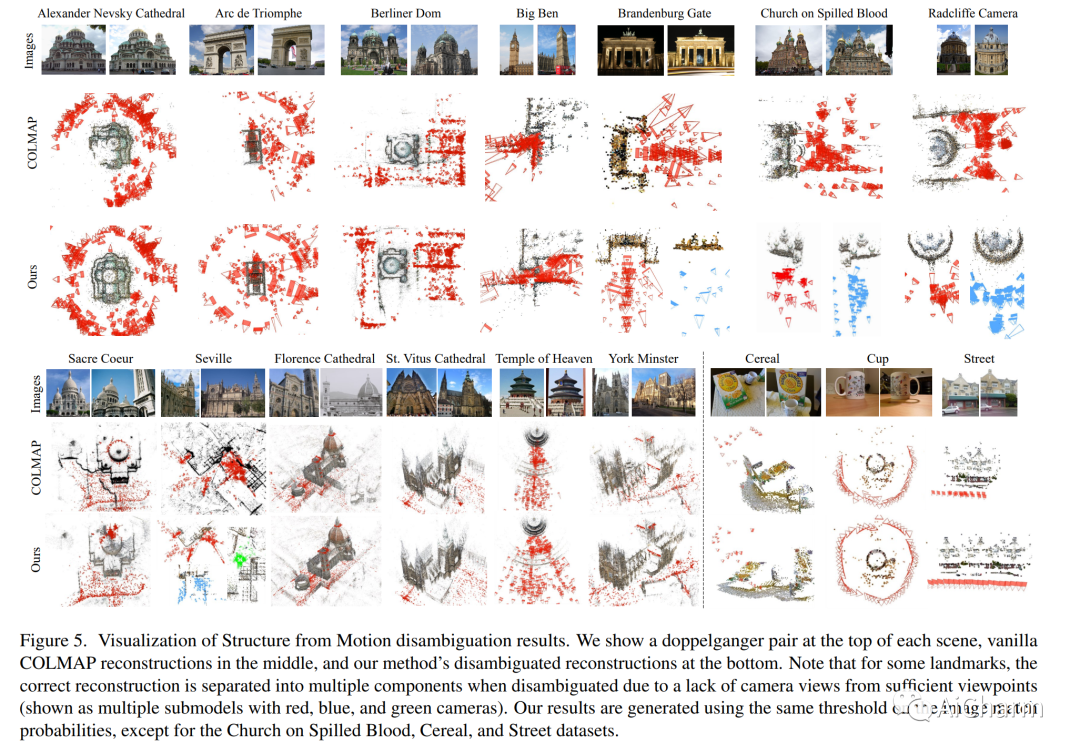
我们考虑视觉消歧任务,确定一对视觉上相似的图像是否描绘相同或不同的 3D 表面(例如,对称建筑物的相同或相反的侧面)。虚幻的图像匹配,即两个图像观察到不同但视觉上相似的 3D 表面,对于人类来说很难区分,并且还可能导致 3D 重建算法产生错误的结果。我们提出了一种基于学习的视觉消歧方法,将其制定为图像对的二元分类任务。为此,我们为这个问题引入了一个新的数据集,Doppelgangers,其中包括带有真实标签的相似结构的图像对。我们还设计了一种网络架构,将局部关键点和匹配的空间分布作为输入,从而可以更好地推理局部和全局线索。我们的评估表明,我们的方法可以在困难的情况下区分虚幻匹配,并且可以集成到 SfM 管道中以生成正确的、消除歧义的 3D 重建。
3.Contrastive Feature Masking Open-Vocabulary Vision Transformer(ICCV 2023 )
标题:对比特征掩蔽开放词汇视觉Transformer
作者:Jiazheng Xu, Xiao Liu, Yuchen Wu, Yuxuan Tong, Qinkai Li, Ming Ding, Jie Tang, Yuxiao Dong
文章链接:https://arxiv.org/abs/2309.00775
摘要:
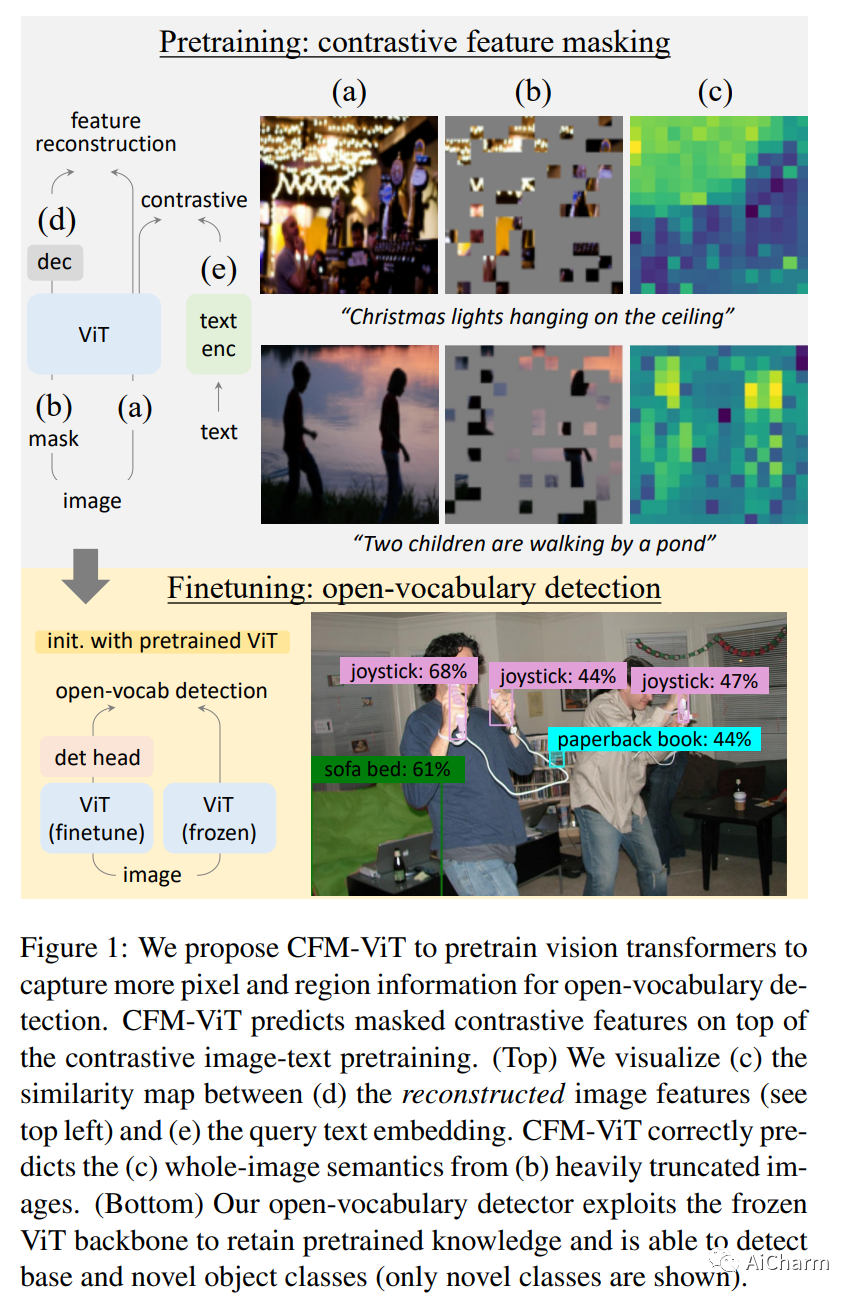
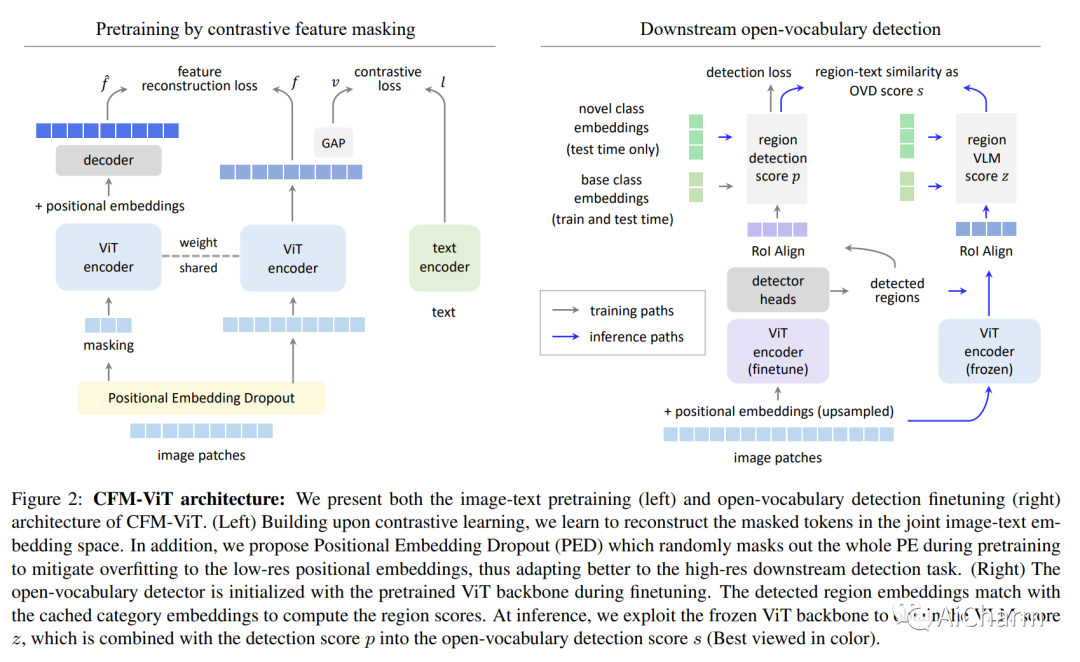
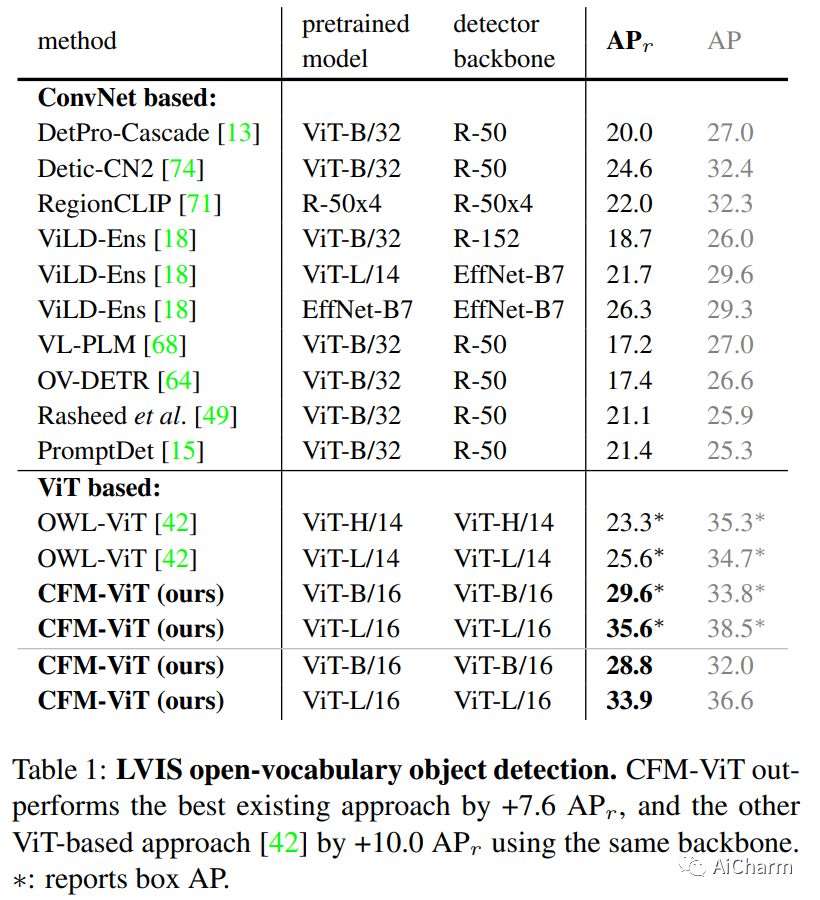
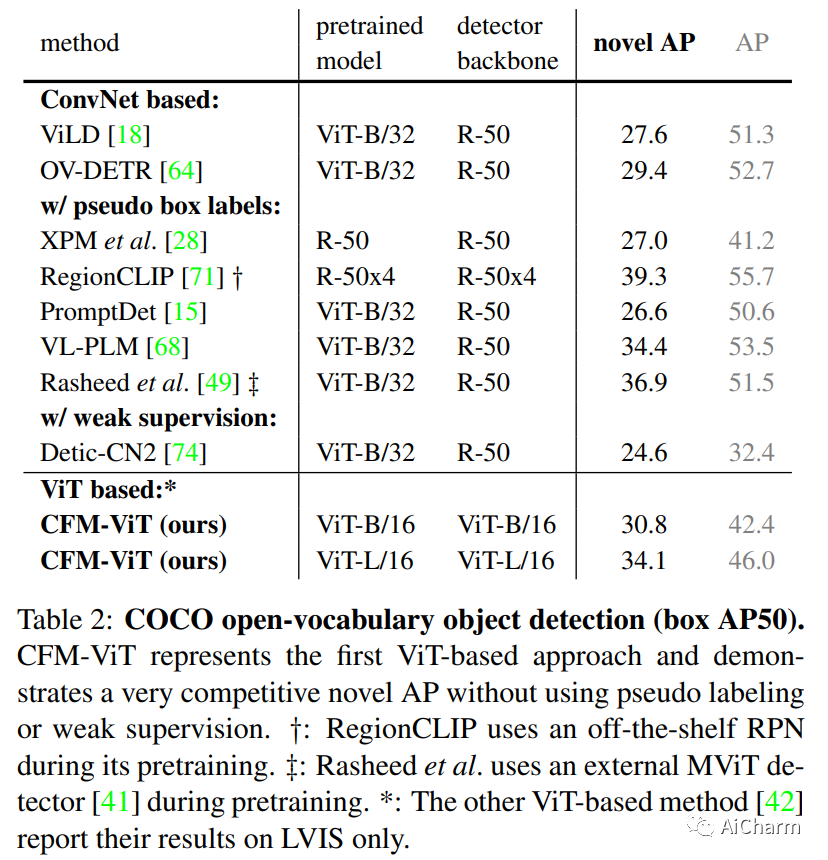
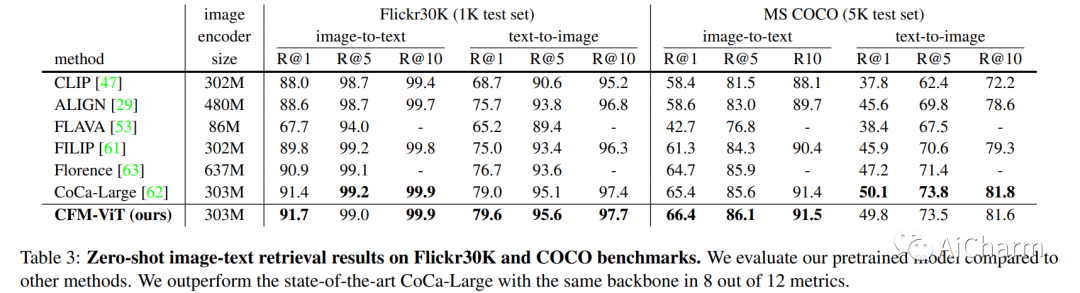
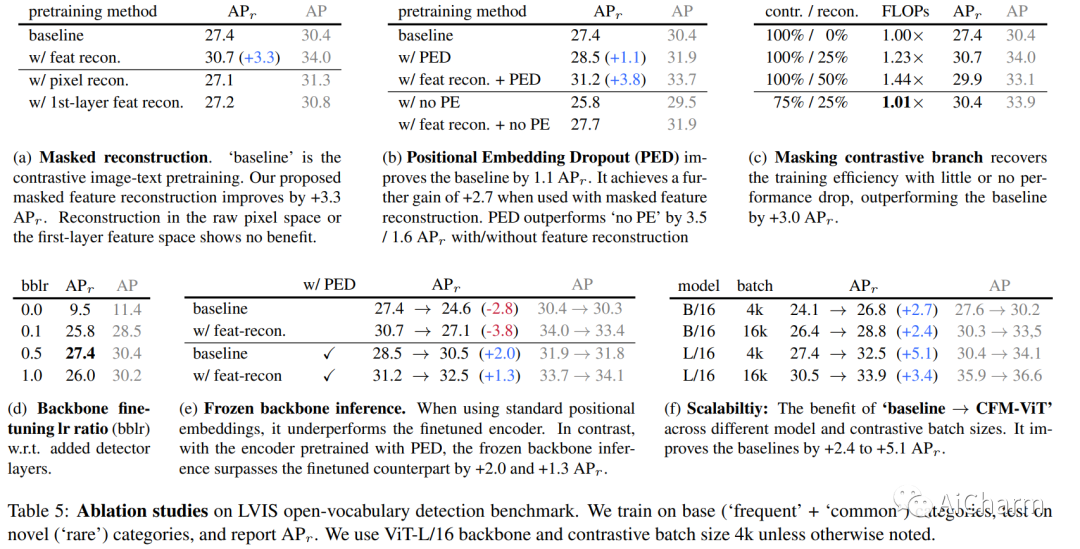
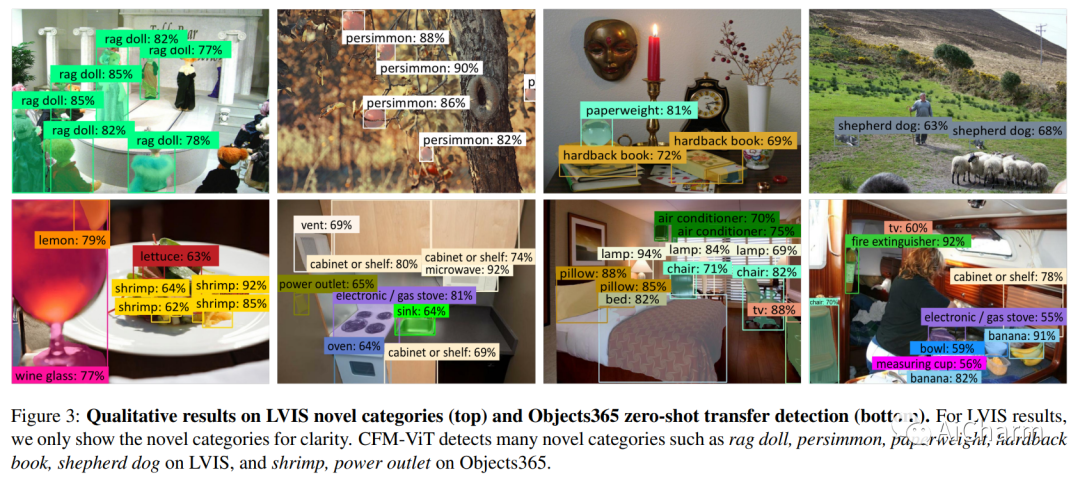
我们提出了对比特征遮蔽视觉变换器(CFM-ViT)——一种图像文本预训练方法,可实现开放词汇对象检测(OVD)的图像和区域级表示的同时学习。我们的方法将屏蔽自动编码器(MAE)目标与对比学习目标结合起来,以改进本地化任务的表示。与标准 MAE 不同,我们在联合图像文本嵌入空间中进行重建,而不是经典 MAE 方法通常在像素空间中进行的重建,这使得模型能够更好地学习区域级语义。此外,我们引入了位置嵌入丢弃(PED),通过在预训练期间随机丢弃位置嵌入来解决图像文本预训练和检测微调之间的尺度变化。PED 提高了检测性能,并允许使用冻结的 ViT 主干作为区域分类器,防止在检测微调期间忘记开放词汇知识。在 LVIS 开放词汇检测基准上,CFM-ViT 达到了最先进的 33.9 AP r ,超越最佳方法 7.6 个点,并实现了更好的零样本检测迁移。最后,CFM-ViT 获得了强大的图像级表示,在零样本图像文本检索基准的 12 个指标中的 8 个指标上优于现有技术。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2023-09-09 07:08,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号