腾讯云
开发者社区
文档
建议反馈
控制台
登录/注册
首页
学习
活动
专区
圈层
工具
MCP广场
文章/答案/技术大牛
搜索
搜索
关闭
发布
文章
问答
视频
用户
沙龙
专栏
专区
综合排序
丨
最热优先
丨
最新优先
时间不限
Prime
Agent
:一个能自我
改进
的 RLM
Agent
PrimeAgent:一个能自我
改进
的RLMAgentPrimeAgent是一个开源的
自
改进
编码
Agent
。它围绕两个核心抽象设计:RLM编程模型和ContinualHarness。 RLM把上下文当成变量、工具调用当成函数写在一个持久化的PythonREPL里;Harness让
Agent
通过/refine从运行轨迹中提取教训,持续
改进
自己的提示词、记忆和技能规格。 二、ContinualHarness:
Agent
能
改进
自己PrimeAgent有一个叫ContinualHarness的持久状态层,存储辅助提示词、记忆、技能描述、可复用的子
Agent
规格。 关键能力是/refine——它会审查当前的运行轨迹,提炼出小的、有证据支撑的
改进
,写入Harness。展开代码语言:TXTAI代码解释你:/refinePrimeAgent:审查最近几轮轨迹... -发现:每次部署都重复输入同一组k8s命令-建议:创建一个deploy技能,封装这些命令-已写入Harness,下次部署直接调用技能Harness不会改写不可变的basesystemprompt,每次
改进
都有记录快照
阿特拉斯
2026-08-09
838
0
标签:
coding
agent
腾讯云架构师技术同盟
自
改进
引擎:学习循环的五步飞轮
自
改进
引擎:学习循环的五步飞轮为什么Hermes能"越用越好用"? Hermes做完任务后,会自动复盘、自动沉淀经验、自动
改进
后续行为——你纠正一次,它永远记住。 步骤3:Skill
改进
你进一步指出"还有5个问题是测试覆盖率下降,这个我关心"。Hermes把这个偏好写入Skill,更新规则为"过滤lint警告,但关注测试覆盖率变化"。 环节三:Skill
改进
——持续优化的能力Skill不是一次创建就固定不变的。 这是Hermes区别于所有其他
Agent
的核心差异。写在最后学习循环是Hermes的"灵魂"。没有它,Hermes就是一个普通的
Agent
框架;有了它,Hermes变成了一个能持续进化的AI伙伴。
AI拉呱
2026-09-20
172
0
标签:
Hermes Agent
自
进化
Agent
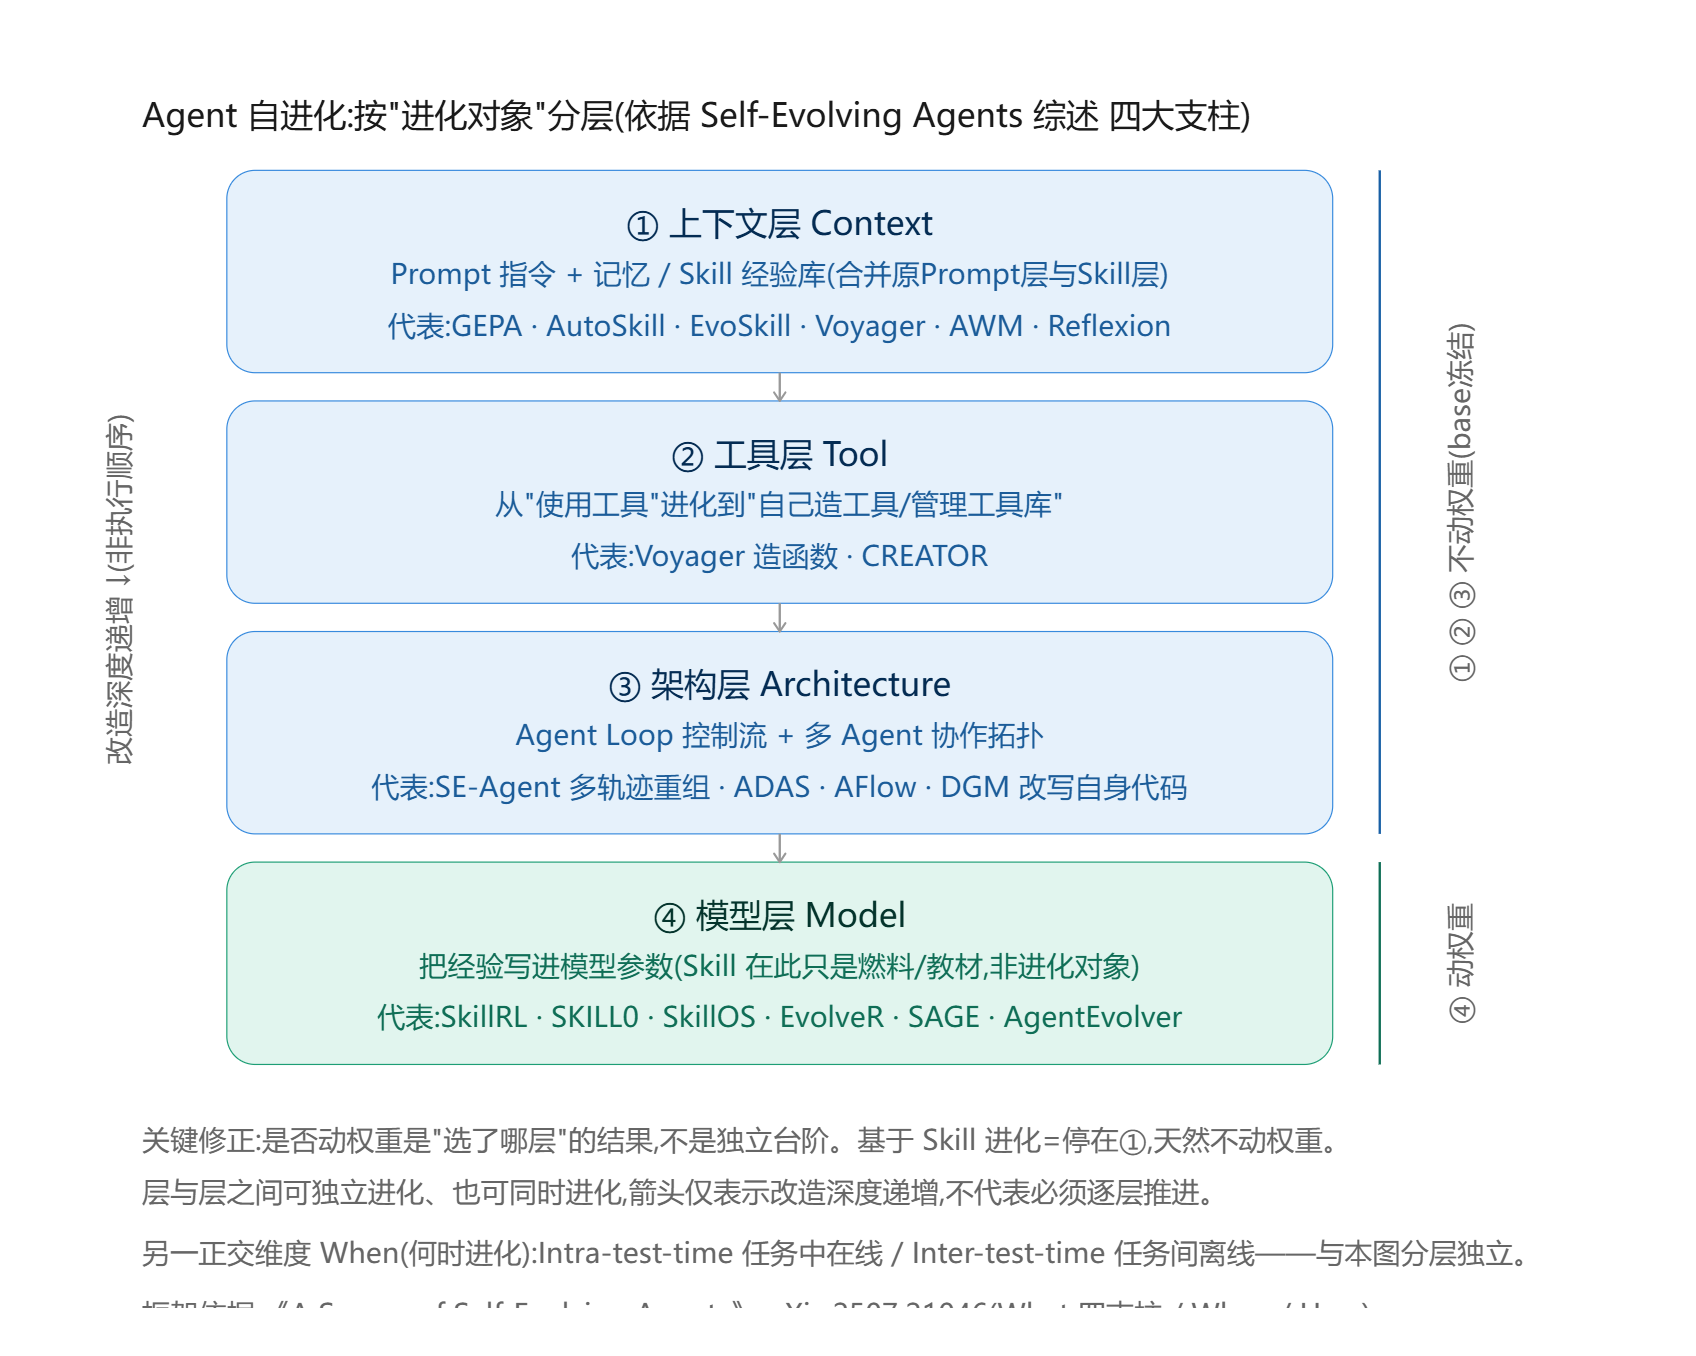
技术分层讲解
自
进化
Agent
技术分层讲解作者导言 当前AI技术的发展,记忆和
自
进化是当之无愧的两大主流方向。之前也零零散散的看了一些
自
进化的skill或算法的介绍的文章,也写过一篇介绍GEPA的文章。 双向进化循环:正向优化(优化器
Agent
分析任务
Agent
的执行轨迹,生成
改进
建议)与反向优化(任务
Agent
的执行结果同时反馈给优化器,触发优化器自身提示词的更新)形成闭环。 图3:SePO
自
参考提示优化架构——优化器与任务
Agent
的双向进化循环及
自
参考机制3.4 Reflexion — 语义梯度反馈循环3.4.1 核心论点Reflexion是一种通过”语言强化”实现自我
改进
的框架 3.4.2 技术创新语义梯度(Semantic Gradient):利用自然语言描述错误原因及
改进
方向,为模型提供比标量奖励更丰富的方向性信号。 与传统的标量奖励(如+1/-1)不同,语义梯度包含具体的错误定位信息和
改进
建议。
winstontang
2026-07-11
1.6K
0
标签:
agent
AIGC
Loop Engineering:把
Agent
做成可
改进
的系统
企业级知识问答
Agent
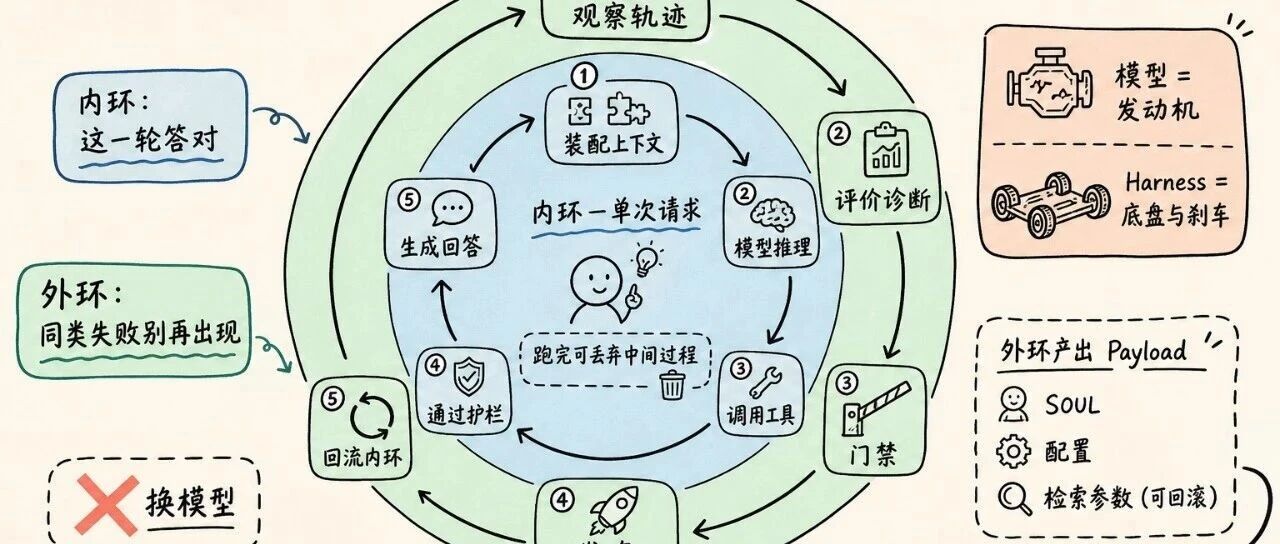
上线后,常见症状往往很像:漏依据、污染上下文、生成物不合规。模型换了一代又一代,这些问题却未必跟着消失。于是判断很容易滑向一句:“是不是模型又不行了?” Loop Engineering(闭环工程):用内环与外环组织
Agent
系统。 内环负责单次请求的可靠完成;外环依据运行轨迹
改进
系统提示(下文称 SOUL)、配置、工具策略或检索参数,经门禁发布后再回流内环。 这个类比有边界:真车的底盘不会每开一公里就改图纸;
Agent
的外环却要持续改 SOUL 与配置,而且必须可回滚。类比只说明“别只盯着模型”,不替代外环如何工程化。 外环若止于报告,
改进
进不了生产。有效产出是可回滚的 SOUL、配置或检索参数。 看不到步骤,就只能归因于模型;看见步骤,才知道该改校验、改超时,还是改提示。 结语:三个问题的答案 1.
柏拉图的美工刀
2026-07-22
310
0
标签:
系统
agent
工具
模型
配置
Agent
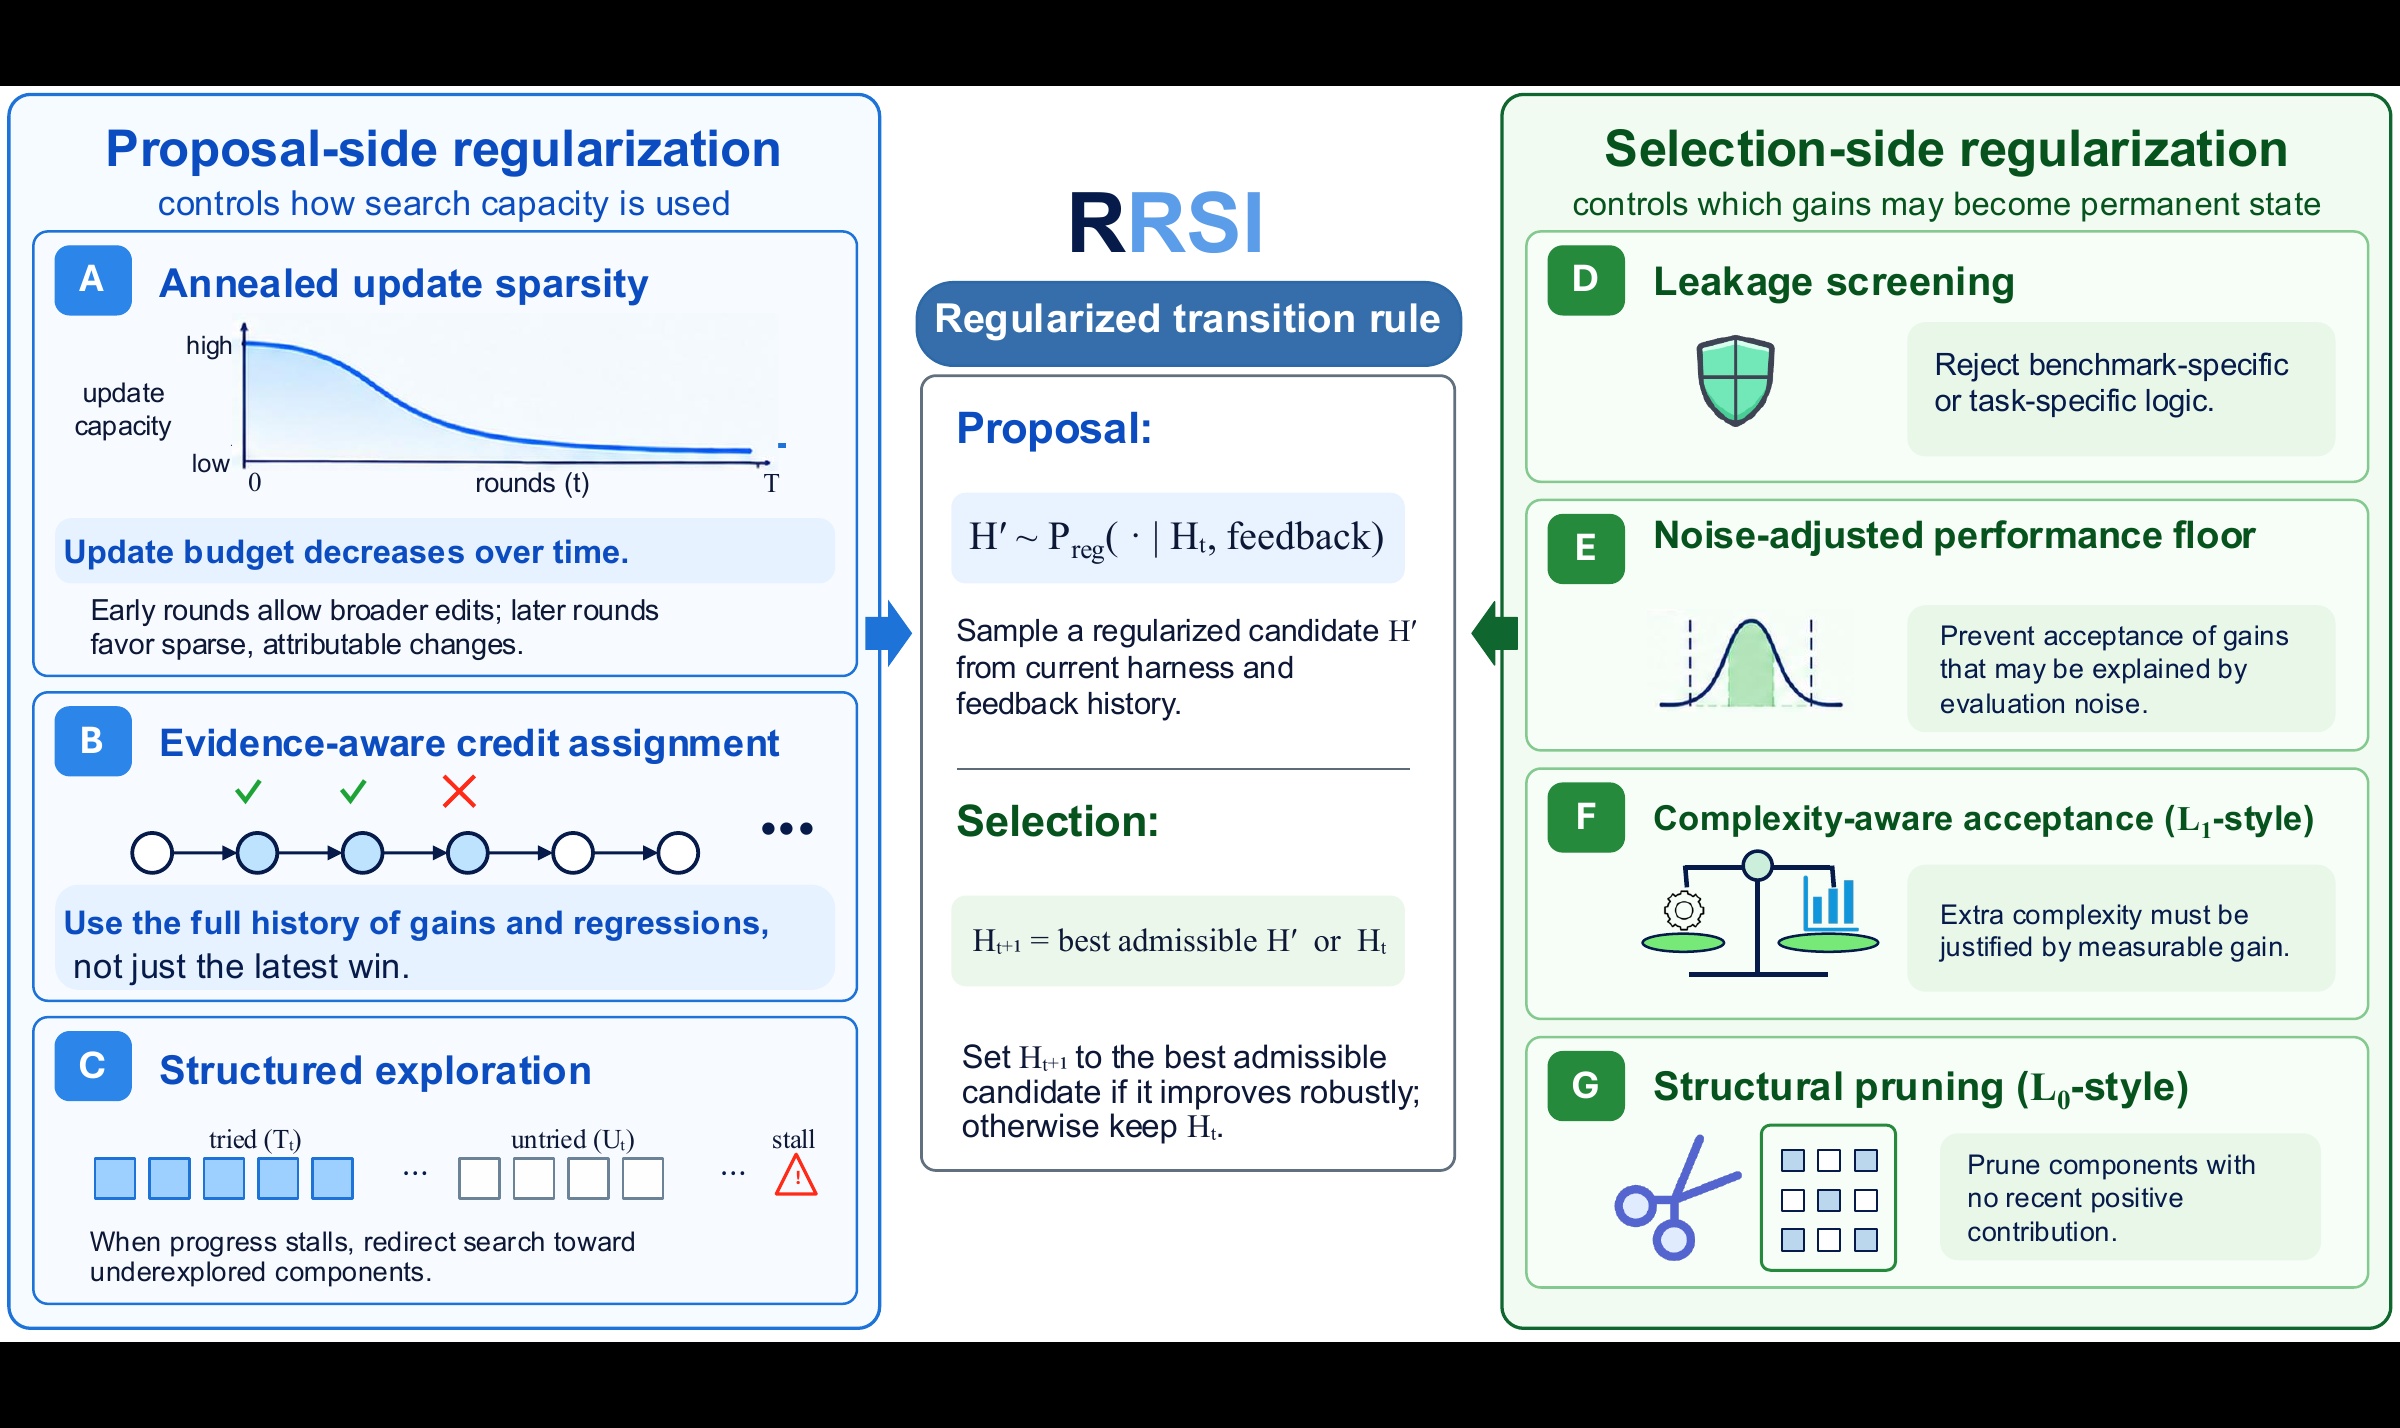
过拟合 谷歌 RRSI 的自我
改进
实验
Agent
的自我
改进
也可能遇到类似问题。反复用同一批任务评价这些配置,系统可能逐渐学会迎合某种题型、报告结构或评分方式。用一个假设的数据分析任务说明。 一项改动要求
Agent
在关联两张表之前,核对字段、数据粒度和无法匹配的记录。这种方法有机会用于后续任务。另一项改动则让
Agent
一旦看到某个特定文件名,就套用固定处理分支。 自我
改进
很容易不断做加法:多一段提示词,多一个评审
Agent
,多一轮检查。RRSI会根据历史记录提出剪枝建议,把近期缺少收益的组件交给提案者考虑删除。删除后的候选仍需重新检验。 一次
改进
如何被采用一次完整的
改进
,会先分析当前版本的失败记录,再生成候选配置。候选经过审查和基本可运行性检查后,才进入任务评估。随后,系统结合分数、成本和领域约束选择版本。 企业真正需要验证什么对于企业
Agent
平台,RRSI提供了一个务实的思路:每次持续性的配置修改,都应该留下可检查的依据。以问数
Agent
为例,
改进
时可以分别观察字段映射、查询构建、工具错误和答案校验。
Cliffhanger
2026-10-27
185
0
标签:
agent
google
为什么单
Agent
自
评总是失真
在很多实践里,一个很自然的设计是,先让
Agent
完成任务,再让它自我检查。按直觉看,这相当于多加了一道保险,结果应该更稳。但现实往往相反。 ,
自
洽就会被误认为正确 这意味着,
自
评并不是真正意义上的第二次判断,更像是第一次判断的延续。 多
Agent
如何拆解复杂问题 一旦接受自评不可靠,下一步自然是引入独立的评估者。但实践很快会发现,仅仅增加一个 Evaluator 还不够,因为输入本身往往还是模糊的。 这样做的好处是,系统不再把所有不确定性都压在一个
Agent
身上,而是把复杂度分摊到多个可管理的环节里。 这对应一个关键方法论:拆解任务,用专职
Agent
攻克子问题。 让主观问题可验证 当系统演进到多
Agent
之后,真正的瓶颈会迅速转移:不再是生成不出来,而是评估不准。很多时候,系统失败不是因为没有产出,而是因为错误产出没有被及时识别出来。
FunTester
2026-06-17
163
0
标签:
模型
系统
系统设计
优化
agent
范式转向:从 Harness 到
自
进化
Agent
范式转向:从Harness到
自
进化
Agent
为什么说Hermes不是"又一个
Agent
",而是一次范式升级?引子:一个仓库引发的认知革命2026年2月25日,GitHub上一个新仓库悄然上线。 所以Hermes做的不是"再造一个聊天入口",而是把这套环境工程产品化——而且不是静态的产品化,是动态的、
自
进化的产品化。 从"手工缰绳"到"
自
进化缰绳"传统Harness和你手工搭建的
Agent
系统有什么本质区别?传统做法:你写Prompt、建规则、设记忆——手工维护,你做主。 系统特点:有规则、有记忆、有工具问题:所有规则靠人手工维护,维护成本高,不进化Phase3:
自
进化Harness时代(2026-)代表:HermesAgent特点:自动复盘、自动沉淀经验、自动
改进
价值: 下一期,我们来拆解
Agent
的核心四件套:
Agent
是什么、FunctionCall怎么工作、MCP协议如何打通外部世界、多
Agent
怎么协作。
AI拉呱
2026-09-20
252
0
标签:
Hermes Agent
Agent
自
进化系列(三)--从反思到
自
进化:
Agent
如何把一次经历变成未来能力
上一篇,我们用“五个问题和一个验证门槛”,讨论了什么才叫
自
进化
Agent
。但
Agent
不会从“会做事”直接跃迁到“会成长”。 我觉得 Reflexion 可以算是
自
进化的重要前驱:它让
Agent
学会了失败后反思,但还没有完全解决跨任务成长。 它采用交替运行的阶段式设计:
Agent
先在线完成一批任务并积累轨迹,再进入离线
自
蒸馏阶段,提炼、去重和评价经验,随后通过强化学习更新策略,最后进入下一轮在线交互。 所以研究重点也正在从
Agent
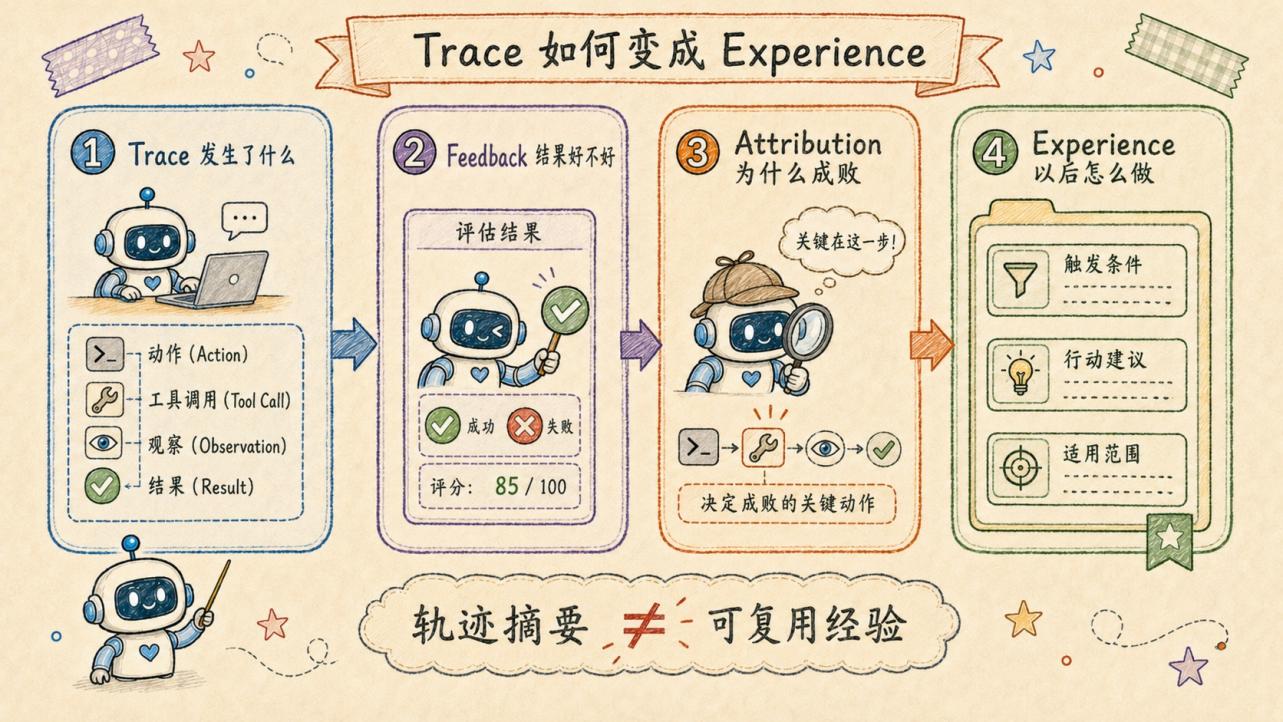
能不能生成经验,转向系统怎样判断哪条经验值得进入未来。结语一次成功或失败都可以变成反思、洞见、流程或原则,但那都不等于
自
进化。
自
进化还要这些经验被持续使用,并且让未来任务真的变好。经验被抽出来之后,还要被保存、检索、更新和遗忘。
languageX
2026-08-24
955
2
标签:
agent
Agent
自
进化系列(二)--什么才叫
自
进化
Agent
:五个问题与一个验证门槛
上篇已经聊过了,
Agent
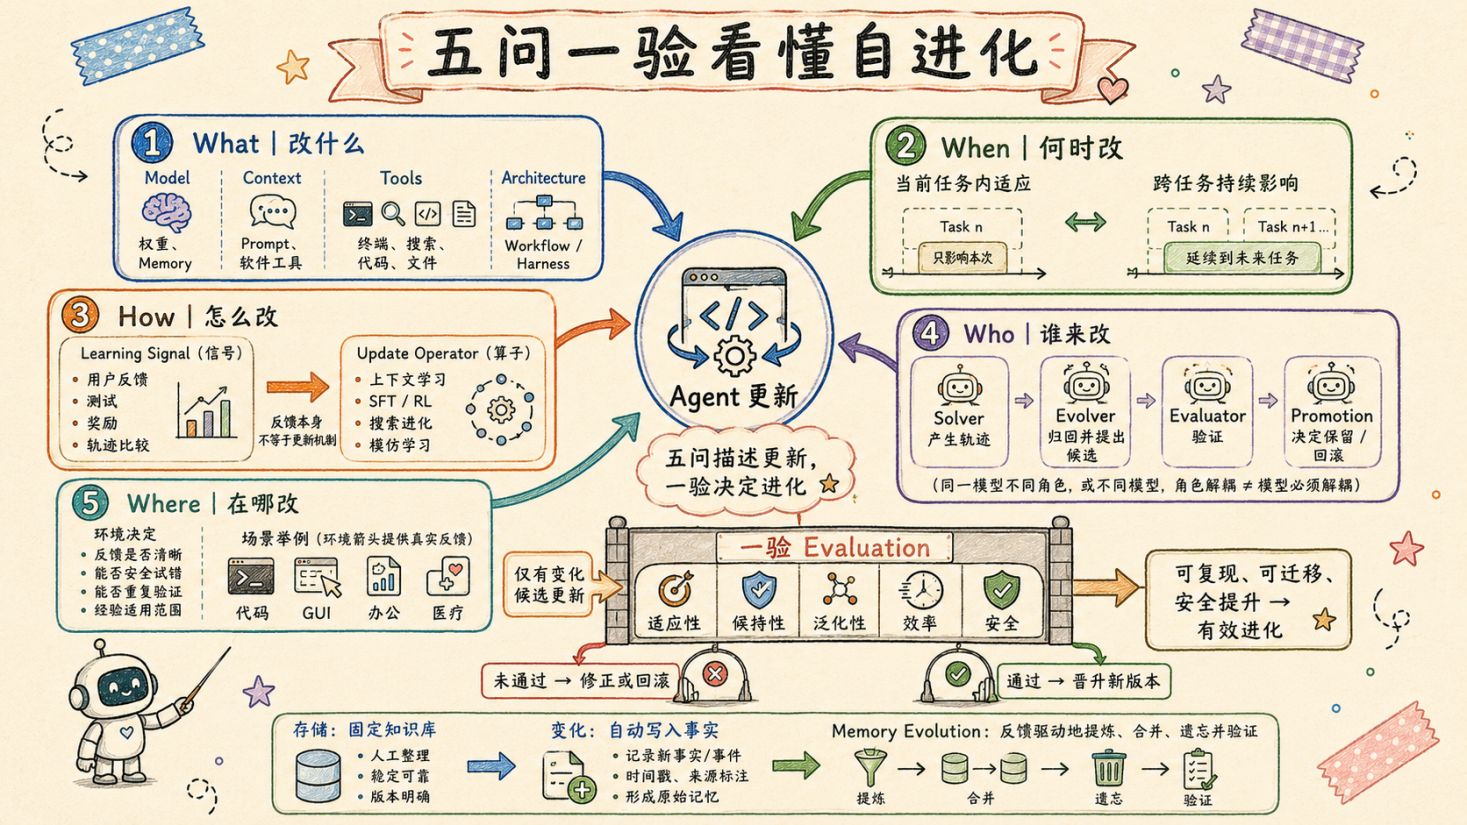
已经会做事、能工作,也有 Memory、Rules 和 Skills 可以留下经验,但“能保存”并不等于“会成长”。 本文聊什么叫成长了,怎么才叫
Agent
能
自
进化。 Task
Agent
只负责完成目标任务;Meta
Agent
负责根据结果修改 Task
Agent
,必要时连自己的
改进
机制一起改。对外它仍是一个系统,对内求解和进化已经分开。 今天很多产品和论文都会使用“反思”“学习”“持续
改进
”“自我进化”等表述,但它们描述的系统可能完全不同。 优化别人的Evolver 自己的更新机制是否也可以被
改进
? 从这个角度看,2026 年的研究对象正在从“一个会反思的
Agent
”,转向一个包含 Solver、Evolver、Evaluator 和更新晋升机制的
自
进化
Agent
系统: Self-evolving
languageX
2026-08-21
1.2K
2
标签:
agent
Agent
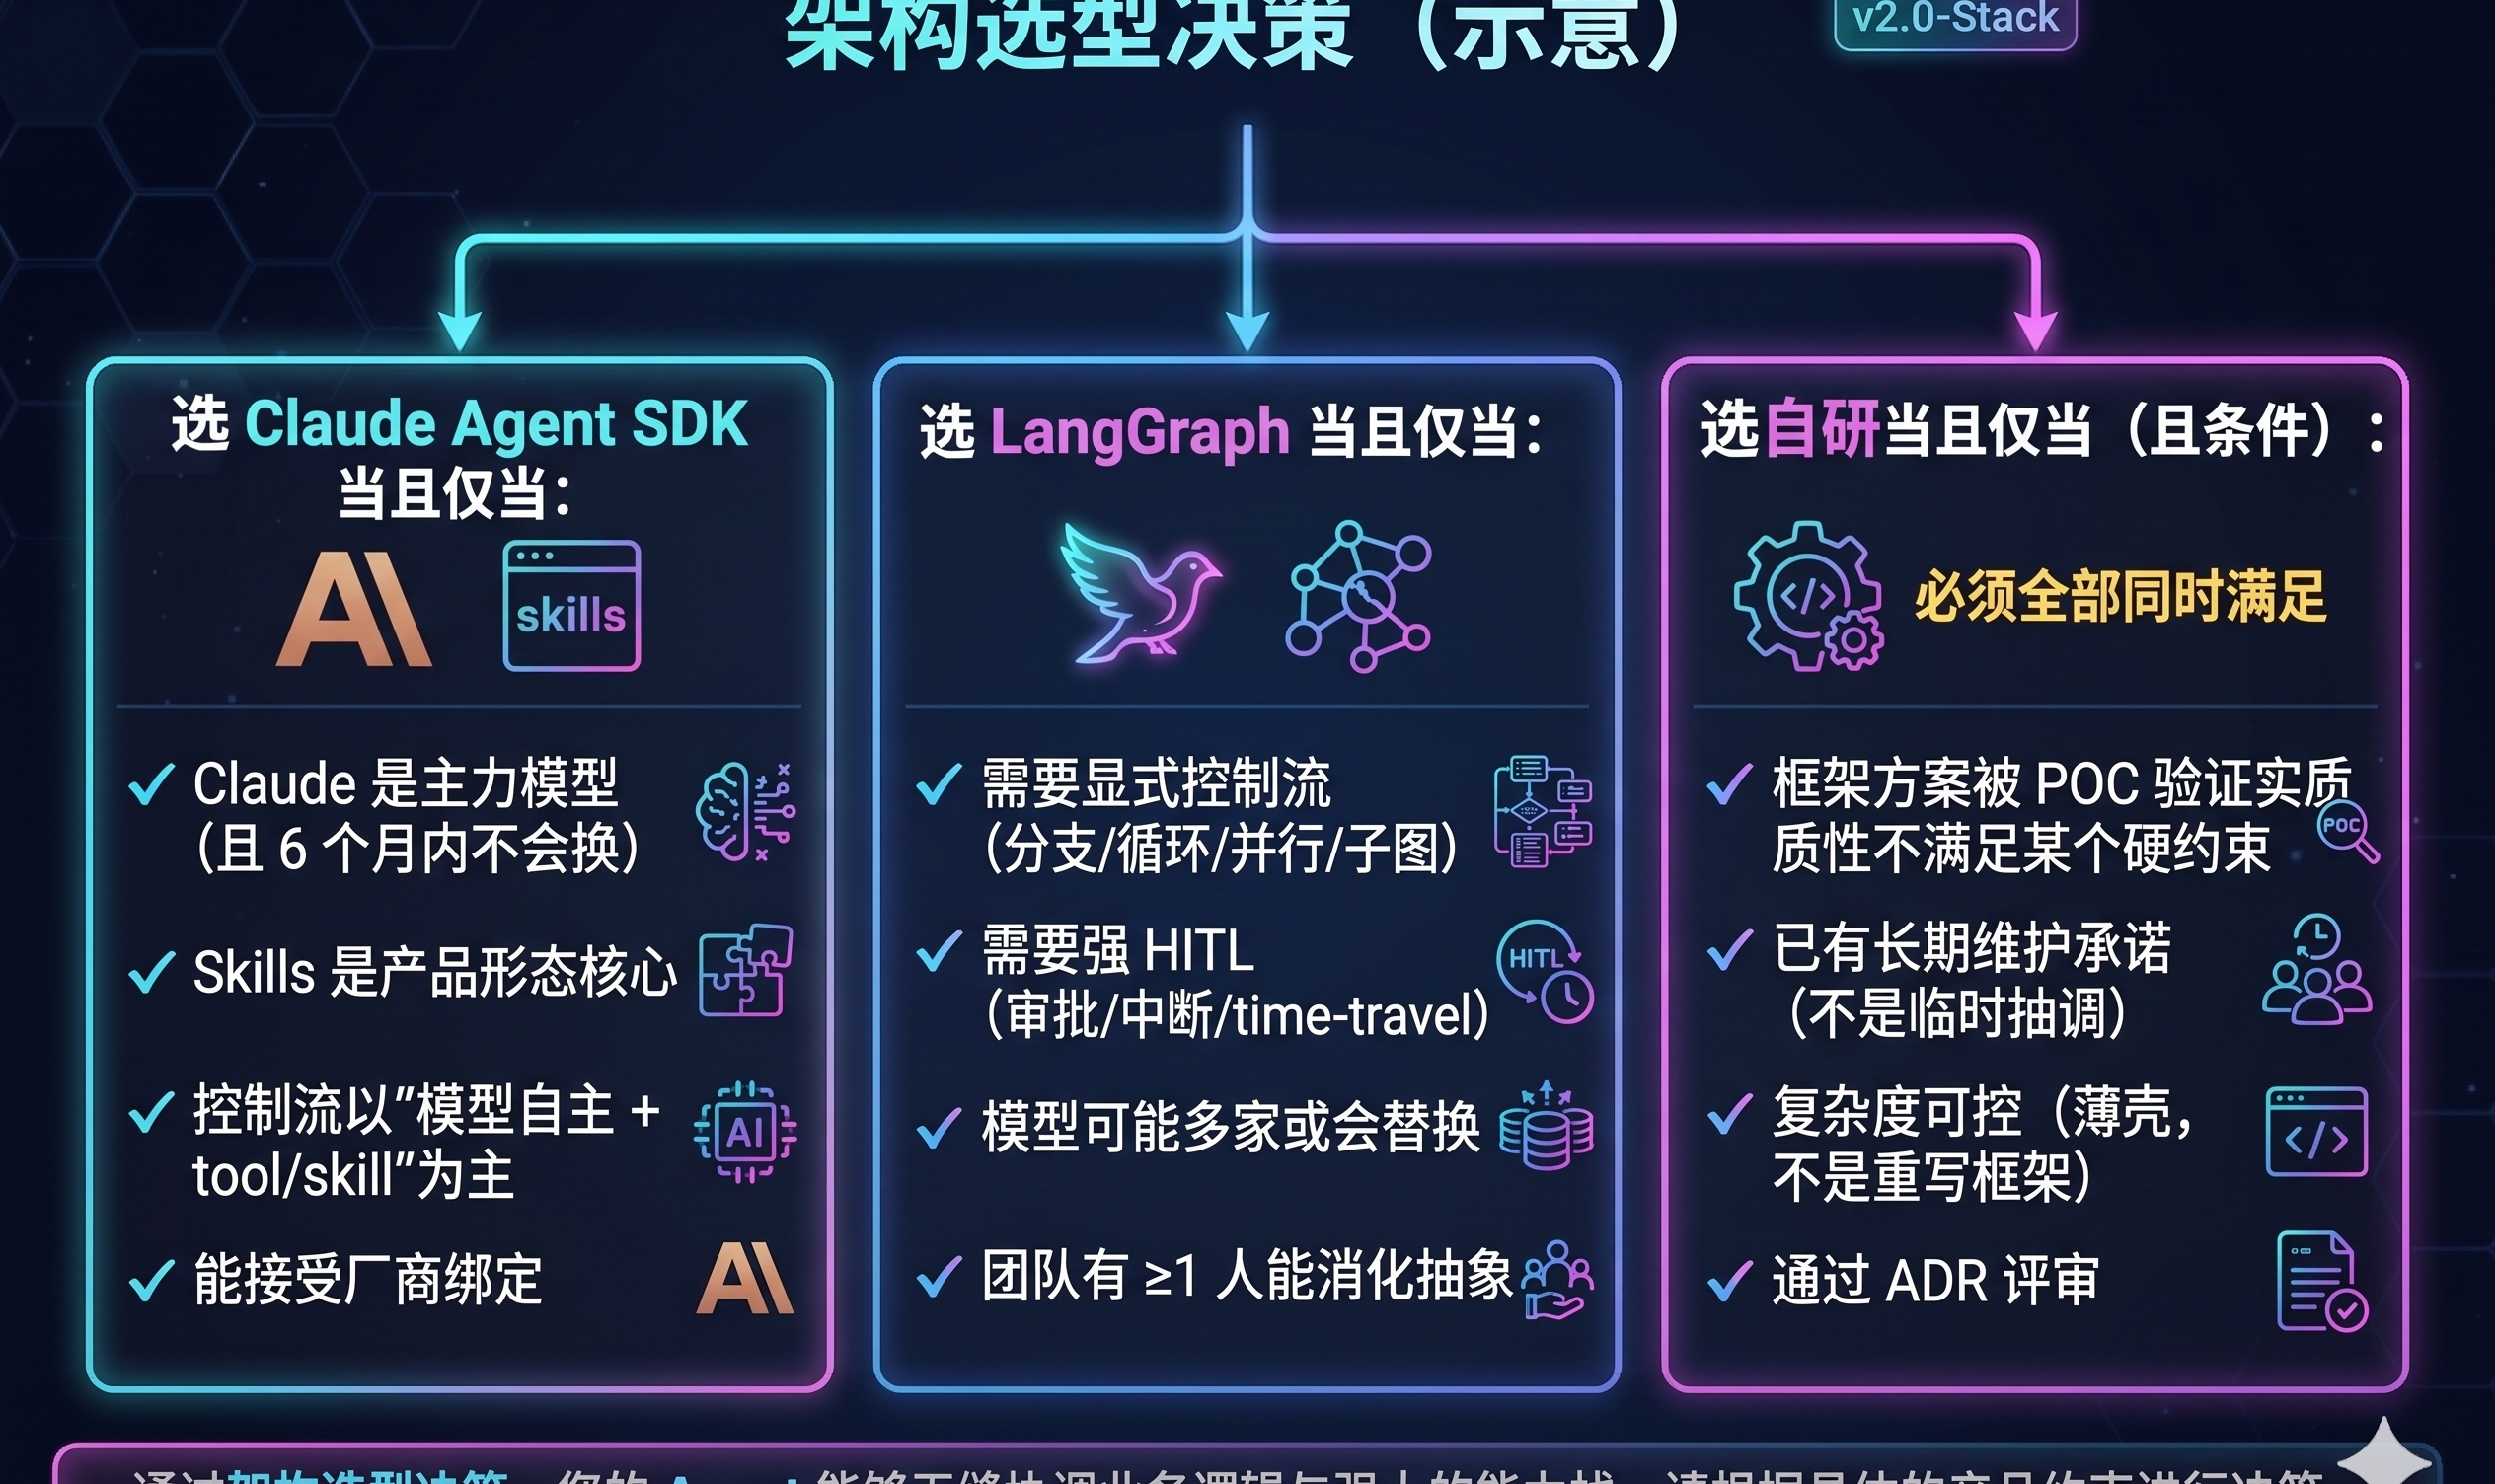
编排框架选型:LangGraph、Claude
Agent
SDK、
自
研,到底怎么选
场景3:高频实时建议
Agent
(延迟敏感)维度权重原因性能极高用户感知抽象开销极高多一层抽象就是延迟灵活性高需要做框架不支持的优化团队投入可承诺已有专人→倾向
自
研。
自
研最大的风险不是代码质量,而是"如果X离职会怎样"。如果答案是"我们就完了"——
自
研就是不可接受的选择,无论它在技术上多优雅。 评估保留多少
自
研部分:通常是性能关键路径+业务特有逻辑。不该自研的部分(通用编排、checkpoint、tool路由)迁移到框架。Adapter层成为新
自
研代码和框架之间的桥。 AP5:
自
研但没有专人长期承诺错误:抽个工程师"先做着"。正确:
自
研需要明确owner,至少1人长期负责。为什么致命:人一离职,整个codebase就成了无主之地。 AP6:把multi-
agent
当默认隐喻错误:默认招"AI同事"——产品
agent
、工程
agent
、QAagent。正确:先用singleagent+skills;多
agent
仅在职责正交时引入。
技术方舟
2026-05-16
1.8K
0
标签:
合肥同盟
问题归档
专栏文章
快讯文章归档
关键词归档
开发者手册归档
开发者手册 Section 归档