
首页
学习
活动
专区
圈层
工具
发布
综合排序丨最热优先丨最新优先
时间不限
Codex 加入实时语音了功能!可以实时语音交互,给Codex下达命令了,非常Nice
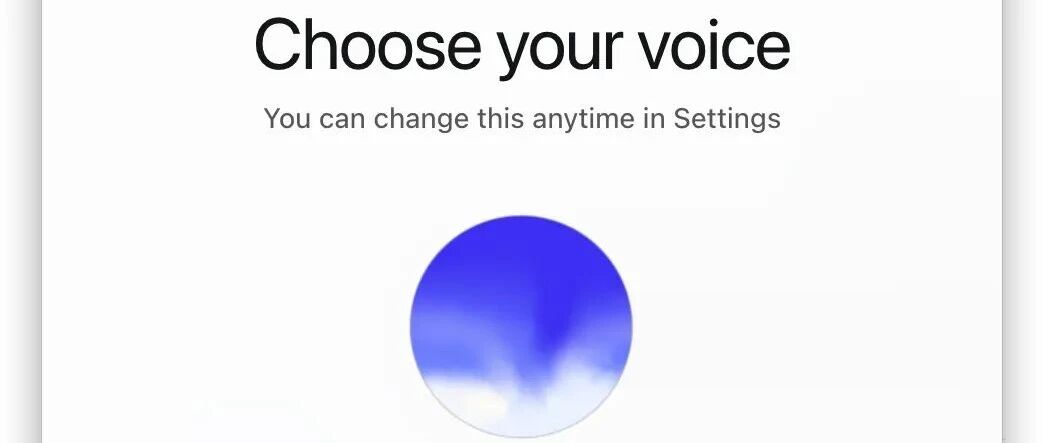
今天凌晨,OpenAI在ChatGPT/Codex的桌面应用端集成了 GPT-Live,中文翻译过来就是实时语音。 这是他们官方的宣传片: 这个实时语音功能,对所有订阅的会员都开放,Plus、Pro都可用。 实时语音,不是单纯“录音”,而是全双工实时语音对话,并且可以指导你的Codex干活。 就像你跟朋友聊天一样,问它问题,它实时给你回复,并且你可以随时打断它。 但是比豆包更牛的是,它支持调用你本地的Codex帮你干活。 如果你直接关闭了的话,其实可以在设置->语音里面找到,再更改里面的设置。 开启之后,你就会在聊天窗口的右下角这里看到一个启动实时语音的按钮。 点击之后,你发现它是黑的,此时正在启动中,并不是你卡了。 直接通过实时语音交互帮你改代码、查资料。 让Codex帮你打开你的其他APP,帮你操作...... 你的Codex已经被灰度到了吗?
卡卡罗特AI
2026-09-10
4550
标签:
【AI 语音】实时语音交互优化全解析:从 RTC 技术到双讲处理
摘要随着人工智能(AI)和实时通信(RTC)技术的快速发展,实时语音交互成为智能助手、客服机器人等应用的重要组成部分。 本文将探讨如何优化 RTC 技术,提高语音交互的稳定性,并提供可运行的示例代码,以帮助开发者快速实现高质量的实时语音交互。 实时语音交互的关键技术RTC(Real-Time Communication)技术RTC 是实现低延迟语音交互的关键技术,常见的 RTC 框架包括 WebRTC、Agora RTC 和 Twilio。 总结本文介绍了 AI 在实时语音交互中的应用,分析了 RTC 技术的优化方法,并提出了解决双讲现象的 AI 方案。通过示例代码,展示了如何集成语音识别与合成,实现高质量语音交互。 未来展望未来,随着 AI 和 RTC 技术的进步,我们可以期待:更自然的语音合成,增强用户交互体验。更强的背景噪声处理,适用于复杂环境。更智能的双讲分离,提高多人语音交互的准确性。
Swift社区
2025-02-05
6.1K0
标签:
数字人像素流送实时渲染网页手机平板用语音交互
而作为云推流实时渲染厂家,这正是我所擅长的。  实时云渲染推流是很好的解决方案,可以实现用户在网页直接就可以自定义自己的数字人形象,只要电脑可以观看1080P视频即可。  除了传统的键鼠交互,还可以支持文字、语音和数字人互动。  具体的方案和上文中基本类似,将数字人客服模型放在服务器端,通过实时渲染推流系统获得网页直接访问的网址,这样用户就可以在网站上和用户交流了。  不过这类场景下,对一些浏览量比较大的网站,如果满足每个进入网站的用户都和数字人客服独立交互,需要的服务器成本会很高。
点量小芹DolitQin520
2024-09-06
9710
标签:
交互新趋势,如何设计语音交互?
值得注意的是,最近几年针对语音交互的体验设计研究开始兴起:Android 和iOS 手机开始构建自己的语音交互生态,智能汽车为了解放双手,也开始研究语音交互的玩法。 这些都证明了企业和市场对于语音交互潜在优势的的认同。语音交互开始逐渐进入到人们的日常生活当中。 当你在专注于某一件事时,最快捷的在同一时间获取其他事物相关信息的方式就是语音交互,它不会被图像交互所打扰。 ? 怎样设计语音交互体验,才能使其发挥场景化的优势?Nielsen的启发式可用性原则依然适用于语音式的交互方案。 系统状态的视觉反馈 亚马逊的语音产品Echo,是一款场景化的语音交互智能硬件。 相比之下,语音交互的流程显得更加直接。在语音交互中,用户只能依靠有限的语音提示以及短期记忆来完成操作,这就需要设计师将流程简洁化。
BestSDK
2018-02-27
3K0
标签:
Dissonance 实时网络语音
Dissonance 低延迟、实时语音通信 高效opus编码 多个聊天室 给个人玩家的私人讯息 语音激活和一键通 定位音频 回声消除 Opus编码(知识扩充) 百科:opus是一种声音编码格式,Opus 是由IETF开发,适用于网络上的实时声音传输,标准格式为RFC 6716。 扩充:Opus编码是由silk编码和celt编码合并在一起,silk编码是由skype公司开源的一种语音编码,特别适合人声,适合于Voip语音通信。 PLC) 浮点和定点实现 注意: 采样率 Opus支持8000,12000,16000,24000,48000 声道数 stereo=1代表双声道(音乐),stereo=0代表单声道kVoip适合于语音通话 码流 接收方能接受的最大码流 64000代表码流为64kbps DTX Discontinuous Transmission的简称,不说话时不传输语音 兼容性和维护性: unity 2019.3.0
x-Alex
2020-08-18
5.5K0
标签:
再看语音交互设计
赋能是人工智能对人类最重要的事情,而智能语音(例如DuerOS)正在为人机交互的方式赋能。声音一直是人与人沟通的核心,而今也成为了人机交互的核心——智能语音交互。 从IVR 系统看起 交互式语音问答(interactive vocie response,IVR)系统的出现,代表了语音交互设计的第一个重要时期。它可以通过电话线路来理解人们的话,并执行相应的任务。 这些方法对于如今的智能语音交互同样有着借鉴的意义。 ? 关于可视化反馈 交互方式正在从单纯的视觉、硬件交互转化为多感官综合的交互,这种交互模式的本质是“关系”。VUI无疑是最重要也是最自然的交互通道之一,但不要为了使用语音交互而使用语音交互。 允许用户同时使用语音和屏幕进行交互,是一种多模态界面(multimodal interface)。可视化组件可以让用户更从容地进行交互,视觉和语音的协同设计非常重要。 ?
半吊子全栈工匠
2019-08-23
2.4K0
标签:
Python语音交互的实现
已经注册并添加了百度的'’语音识别'和'语音合成'应用。 已经注册并创建了图灵机器人的'机器人'。 整体的实现流程 语音输入。 语音翻译成文字。 聊天回应文字。 将文字合成语音。 输出语音。 实现方式 pyaudio模块识别麦克风 在线百度语音识别,把录音文件转换成文字 在线图灵机器人,对文字进行回答 使用百度的语音合成技术,把文字转为音频文件 通过pygame识别音频(只能是MP3格式), 输出语音 外部包 pip install pyaudio==0.2.11 pip install baidu-aip==2.2.5.2 pip install pygame==1.9.4 项目在github ---- 可以结合语音唤醒,自己制作一个智能音箱了。 语音唤醒内容:[https://blog.51cto.com/feature09/2300352]
py3study
2020-01-07
3.1K0
标签:
实时交互型钓鱼套件驱动的语音钓鱼攻击机制与防御研究
近期,身份管理厂商Okta披露了一种新型网络威胁态势:攻击者利用高度可定制的实时交互型钓鱼套件,将语音钓鱼(Vishing)与传统网络钓鱼深度融合,构建了“人机协同”的混合攻击模型。 关键词:语音钓鱼;实时交互钓鱼套件;多因素认证绕过;会话劫持;FIDO2;零信任1 引言在网络安全防御体系不断演进的当下,多因素认证(MFA)已成为保护企业核心资产和用户身份的标准配置。 2 实时交互型钓鱼套件的技术架构与运作机理2.1 双通道协同攻击模型新型Vishing攻击的本质是建立了一个“语音 - 网络”双通道协同的攻击闭环。 然而,实时交互型钓鱼套件通过多种手段轻松绕过了这些防御。 面对这种结合了实时语音互动、动态页面变化和高度定制化场景的新型攻击,员工的防御能力明显不足。在高压的电话沟通和看似正常的网页交互双重作用下,即使是受过培训的员工也可能瞬间丧失警惕。
芦笛
2026-02-28
5250
标签:
TRTC实时对话式AI解决方案,助力人机语音交互极致体验
同时,借助 RTC 的超低延迟通信能力,GPT-4o输入到输出平均延迟在 500 毫秒以内,实现了人与AI实时对话,堪称一次革命性的交互体验升级。 GPT-4o 演示的多模态交互是未来的发展方向,但目前国内多模态技术尚未成熟,短期内还是以单模态为主,需借助 ASR(自动语音识别)和 TTS(文本转语音)等产品串联整个流程。 通过结合第三方大模型以及TTS(文本转语音)技术,可以帮助客户轻松创建出一个媲美GPT-4o所演示的AI实时交互体验,并将其应用于实际业务场景中。 02、打造实时交互新体验,TRTC推出实时对话式AI解决方案 TRTC对话式AI解决方案一站式提供从音视频采集、处理、传输到云端AI处理服务的全链路能力。 之前用户与AI的交互基本限于文字,类似使用微信、QQ交流,而接入TRTC对话式AI方案后,用户可以与AI进行实时语音通话,就像打电话,交流更为便捷,可以获取更多情绪价值。
腾讯云音视频
2024-11-11
2.2K0
标签:
语音交互·认知对话:智能语音互动查询系统重塑人机交互新范式
语音查询迈入认知交互时代在移动优先与万物互联的产业背景下,传统语音查询系统面临语义理解浅层、场景适配僵化、多轮交互断裂等核心挑战。 智能语音互动查询系统通过融合语音识别、自然语言理解与对话管理技术,构建了从语音感知到认知决策的完整交互链条,实现了从"指令响应"到"智能对话"的体验升级。 传统系统对口语化表达、专业术语理解准确率不足 75%场景迁移困难:单一场景训练的模型难以适应跨领域业务查询多轮对话断裂:缺乏对话状态跟踪,上下文信息流失严重个性化体验缺失:无法识别用户偏好,提供千人一面的标准回复实时响应延迟 :复杂查询处理延迟超过 3 秒,影响交互体验智能语音交互架构系统构建"感知-理解-决策-执行"四层技术架构:多模态语音处理引擎支持噪声环境下的高精度识别;深度语义理解模型实现多维度意图识别;对话状态跟踪器维持跨轮次对话一致性 持续进化路径未来技术演进聚焦情感交互与跨模态融合:通过语音情感识别实现更具温度的交互体验;融合视觉、文本等多模态信息提升理解准确率;发展个性化自适应能力,使系统越用越智能;最终构建具备情感认知和深度推理能力的新一代语音交互系统
上海拔俗网络
2025-10-30
6500
标签:
问题归档专栏文章快讯文章归档关键词归档开发者手册归档开发者手册 Section 归档