腾讯云
开发者社区
文档
建议反馈
控制台
登录/注册
首页
学习
活动
专区
圈层
工具
MCP广场
文章/答案/技术大牛
搜索
搜索
关闭
发布
文章
问答
视频
用户
沙龙
专栏
专区
综合排序
丨
最热优先
丨
最新优先
时间不限
MinerU
如何整理
文档
进RAG流程
先给结论:
MinerU
要解决的是
文档
进模型前的结构损耗
MinerU
是opendatalab/
MinerU
仓库中的Python
文档
解析工具,项目描述明确写到可将PDF、images、DOCX、PPTX、XLSX 工作流拆解:
MinerU
应该站在RAG管线最前面从能力边界看,
MinerU
处理的是“
文档
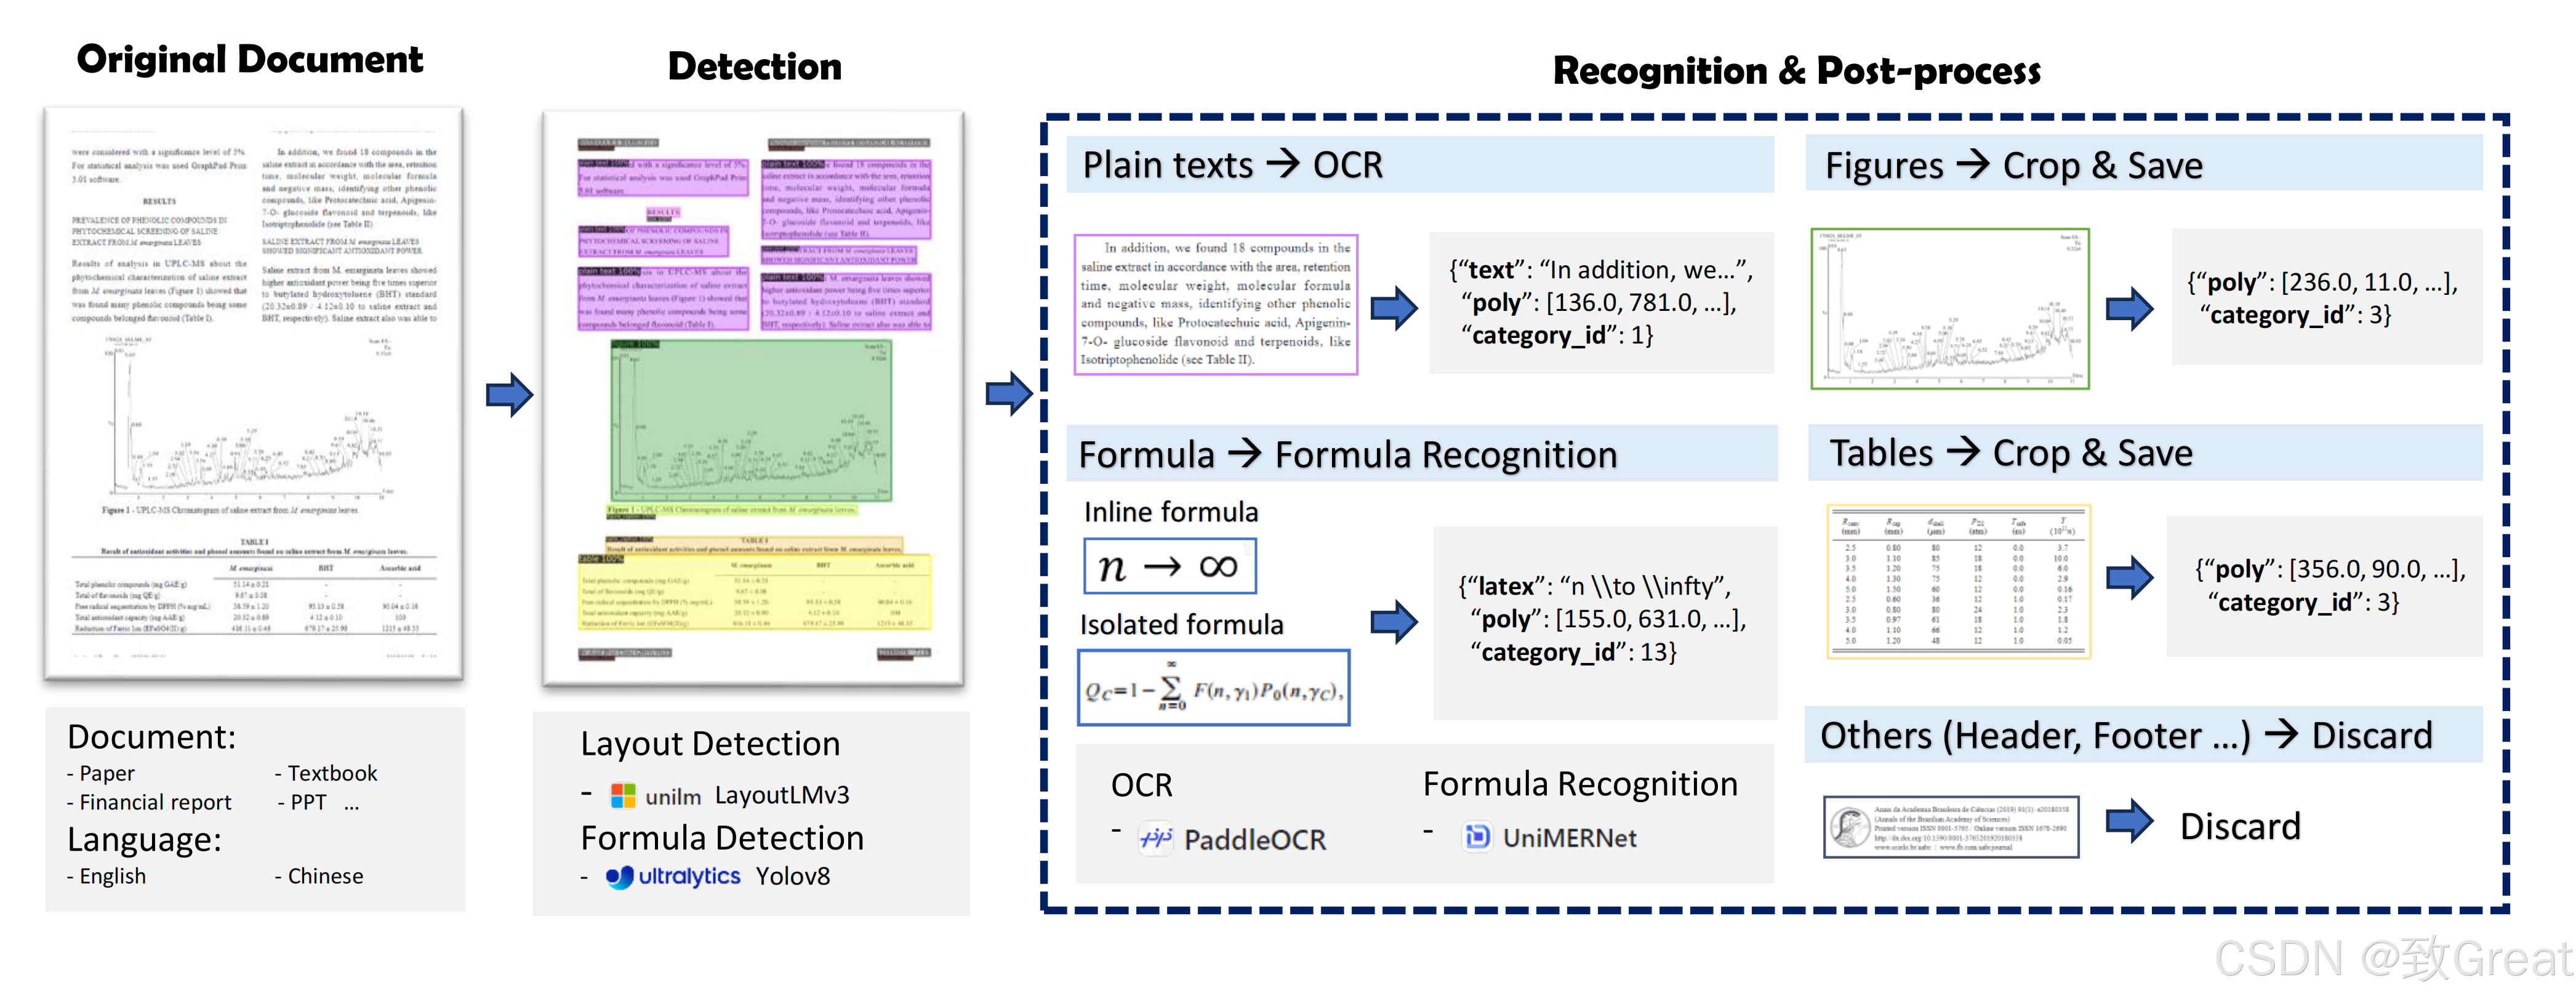
到结构化文本”的转换。它的输出不是最终答案,而是后续系统的输入。 是否值得放进日常:先做入口层替换,不要急着重构系统
MinerU
短期更适合三类人先试:正在搭RAG知识库的开发者,手里有大量PDF/Office
文档
的内容或研究团队,以及想给Agent增加
文档
读取能力但经常遇到引用不准的人 素材没有给出
部署
架构、评测集、生产指标或真实客户案例,所以文章也不应该编造这些背景。 今天可以试的是正在做RAG、
文档
问答、批量摘要或Agent
文档
读取流程的开发者,下一步就是cloneopendatalab/
MinerU
,安装
mineru
[core],用
mineru
-gradio和
mineru
-api
用户3825620
2026-06-30
469
0
标签:
人工智能
国产开源的
文档
转换器:
MinerU
简介
MinerU
是由OpenDataLab团队打造的大模型时代的
文档
提取/转换神器 支持PDF、Word、PPT等多种
文档
的智能解析,可用于机器学习、大模型语料生产、RAG等场景 特点 多语种支持 多类型支持 导出格式为json markdown 客户端无需登录 开源免费 真国产(上海人工智能实验室) 使用效果 我用了一个很长的pdf
文档
来试了一下,解析的效果很好 渲染出来的markdown效果很好,但是某些公式识别的不够准确 ,导致我尝试在web渲染markdown时锚点全是h1,seo优化极差 : ( 总结 总体来说效果还是不错的,未来应该会推出更多的格式转换 推荐大家试一试,有硬件条件的可以本地
部署
一个玩玩
姓王者
2025-03-28
1.4K
0
标签:
登录
模型
人工智能
渲染
开源
字节跳动 Dolphin vs
Mineru
:哪个才是你的
文档
解析最优解?
一句话总结 Dolphin 更适合研究和多模态
文档
解析,
Mineru
更适合实际生产和多类型
文档
处理。 种语言; 模块化设计:从解析、校对到导出全流程打通; 输出灵活:支持 Markdown、结构化 JSON,多种中间格式方便二次处理;
部署
简单:支持 Windows、Mac、Linux,兼容 CPU/GPU
MinerU
使用
文档
:
MinerU
文档
中心 适用场景 各类生产环境
文档
自动化处理 OCR
文档
、合同扫描件、旧档案清洗 NLP 项目数据预处理和知识库构建 性能实测亮点 Dolphin 页面级 、元素级解析准确率高 采用 HAP 技术,多个元素并行处理,效率高于传统 pipeline 更适合 GPU 高性能
部署
场景 ⚙️
Mineru
在 Docling 测试中表现优异(GPU 上 0.21 是研究人员 / 算法工程师 主要
文档
是学术论文、技术
文档
对效率和多模态理解有强需求 ️ 你适合
Mineru
吗?
井九
2025-09-08
5K
0
标签:
工作
论文
图表
效率
性能
MinerU
Docker
部署
指南:PDF 结构化解析服务实践
以下分别介绍这三种服务的
部署
方法。1.vLLM后端服务
部署
vLLM后端服务是
MinerU
的核心组件,提供高性能的
文档
解析与处理能力。 接口,方便其他应用程序集成
MinerU
的
文档
处理能力。 您可以上传测试
文档
并尝试解析功能,验证系统是否正常工作。生产环境建议硬件资源配置
MinerU
的性能很大程度上取决于硬件配置,特别是在处理大型
文档
或启用AI增强功能时。 ,可参考
MinerU
镜像
文档
(轩辕)https://xuanyuan.cloud/r/alexsuntop/
mineru
获取更多信息。 https://docs.vllm.aiGradio相关资源Gradio官方
文档
https://www.gradio.app/docs总结本文详细介绍了
MinerU
的Docker容器化
部署
方案,包括环境准备
轩辕镜像
2025-12-31
5K
0
标签:
容器服务
docker-compose
docker-images
pdf
pdfbox
MinerU
-Popo来了:让
文档
解析从“看懂每页”走向“读懂整篇”
MinerU
-Popo支持本地私有化
部署
,模型轻量高效,适合大规模
文档
处理场景,欢迎使用。 二、
MinerU
-Popo技术框架
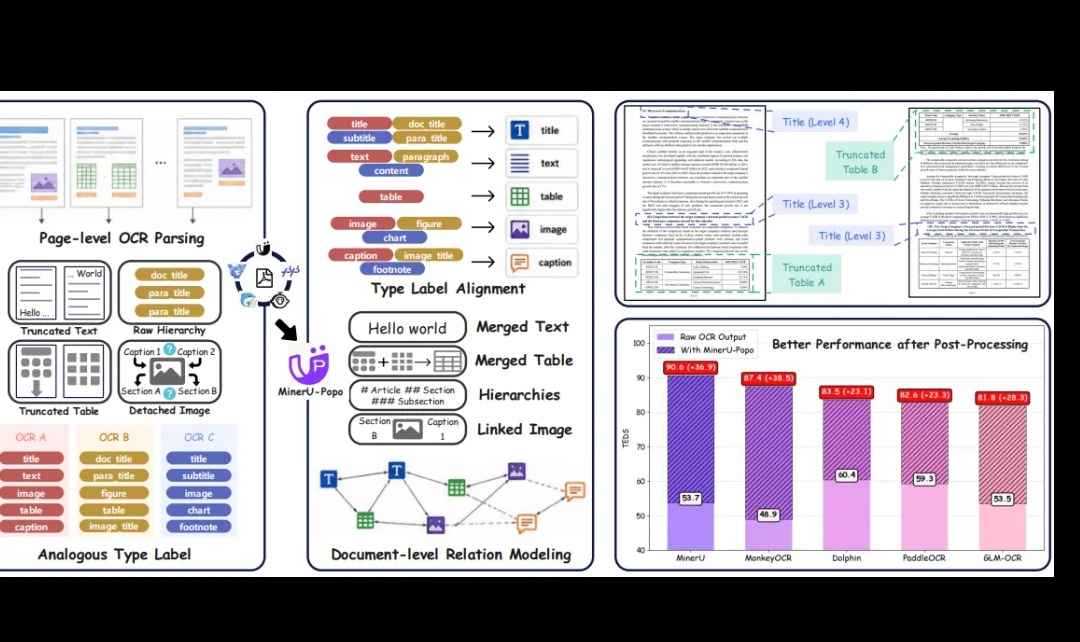
MinerU
-Popo将
文档
后处理拆解为四个核心任务:文本截断恢复、表格截断恢复、标题层级重建和图文关联。 围绕这些任务,
MinerU
-Popo设计了面向任务的数据引擎、动态分块与同步、
文档
丰富化三大模块:先筛掉无关元素,再处理长
文档
分块边界,最后生成
文档
树和节点摘要,让输出更适合检索、问答和分析。
MinerU
-Popo会先从大规模真实OCR
文档
中,利用VLM按视觉外观、版面特征、
文档
格式、内容领域和页面长度等维度进行筛选,并按领域和长度分组采样,确保数据覆盖金融、学术、政务、医疗等多种
文档
类型。 四、写在最后从
MinerU
2.5到
MinerU
-Popo,
文档
解析正在从单页精度竞争,进一步走向
文档
级语义结构恢复。前者让模型更准确地看懂页面,后者让系统更完整地读懂整篇
文档
。
硅基大脑
2026-06-02
1.5K
0
标签:
人工智能
轻量服务器
部署
MinerU
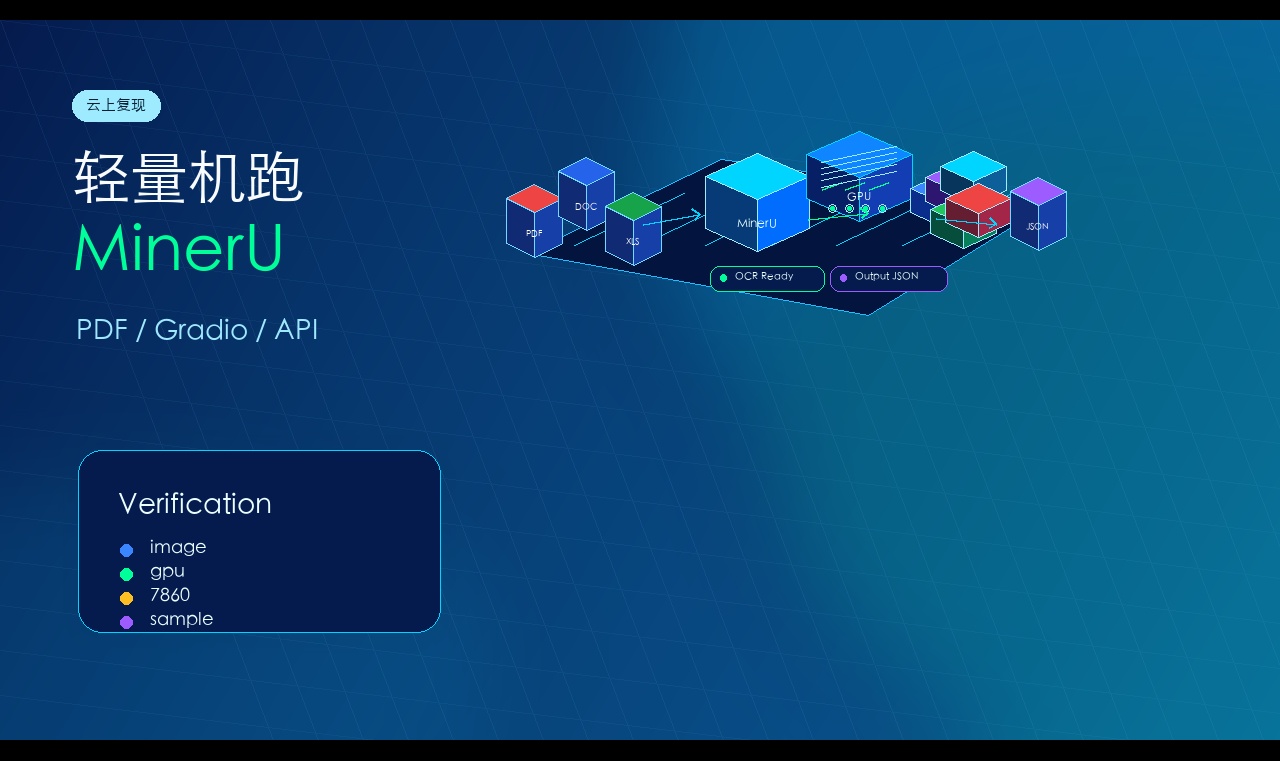
:PDF 解析服务复现记录
这次记录一个MinerUDocker
部署
复现。目标不是搭一个完整知识库,而是先验证PDF、Office
文档
能不能解析成Markdown/JSON,再决定要不要接后面的RAG流程。 展开代码语言:BashAI代码解释dockerrun--rm--gpusalldocker.1ms.run/vllm/vllm-openai:v0.21.0nvidia-smi这一步能过,再继续构建或启动
MinerU
表格密集
文档
。带公式的
文档
。PPTX或XLSX。重点看解析后的Markdown/JSON,而不是只看页面能不能打开。小结这次复现的关键点是:
MinerU
适合作为RAG前面的
文档
解析层。
部署
时先排镜像、GPU、端口和模型缓存,再看解析产物质量。如果Markdown/JSON已经乱了,后面接什么向量库和模型都很难稳定。
goodgood_live
2026-06-23
431
0
标签:
pdf
MinerU
JSTS SDK 深度指南:JavaScriptTypeScript 开发者的 PDF
文档
解析利器
MinerU
是什么
MinerU
是上海人工智能实验室开源的一站式
文档
解析工具,基于视觉语言模型(VLM)架构,能够将 PDF、图片、Word、PPT、Excel 等任意格式的
文档
转换为结构化的 Markdown ,稳居当前
文档
解析榜首。 本文聚焦 JavaScript/TypeScript SDK(包名
mineru
-open-sdk),面向需要在前端工程、Node.js 后端服务或 AI Agent 中集成
文档
解析能力的开发者。 /output/");}相关链接官方网站:https://
mineru
.netSDK 源码:https://github.com/opendatalab/
MinerU
-EcosystemAPI
文档
:https :只需一行代码,
mineru
-open-sdk 即可将任意
文档
转换为结构化的 Markdown,配合 Precision Extract 的多格式输出和 AI Agent 状态跟踪能力,是构建
文档
处理流水线
用户12386590
2026-04-14
1.6K
0
标签:
javascript
typescript
pdf
MinerU
:把复杂
文档
驯服成 Markdown 与 JSON 的开源“采矿师”
你也可以把它作为离线私有
部署
能力的一部分,放在企业内网里处理敏感材料。它的角色很像一个稳健的中间层:站在原始
文档
和智能系统之间,把混乱翻译成秩序。 因为现实世界里的
部署
环境,从来都不是理想实验室。 这种后端分层能力,意味着
MinerU
不只是一个模型壳子,而是一个认真考虑
部署
现实的工程系统。 它最近在进化什么从README的changelog可以看出,
MinerU
更新节奏相当积极,而且方向很明确:围绕解析能力、系统工程能力和
部署
体验持续打磨。 3.0.0版本这是一次系统性升级,涉及:原生DOCX解析pipeline后端能力提升APICLIRouter升级
部署
与可用性优化更好的长
文档
支持更好的多线程并发推理更方便的一站式多GPU
部署
思路读这些更新记录时
阿超
2026-06-29
895
0
标签:
人工智能
基于
MinerU
的PDF解析API
基于
MinerU
的PDF解析A -
MinerU
的GPU镜像构建 - 基于FastAPI的PDF解析接口 支持一键启动,已经打包到镜像中,自带模型权重,支持GPU推理加速,GPU速度相比CPU每页解析要快几十倍不等 主要功能 删除页眉、页脚、脚注、页码等元素,保持语义连贯 对多栏输出符合人类阅读顺序的文本 保留原
文档
的结构,包括标题、段落、列表等 提取图像、图片标题、表格、表格标题 自动识别
文档
中的公式并将公式转换成 latex 自动识别
文档
中的表格并将表格转换成latex 乱码PDF自动检测并启用OCR 支持CPU和GPU环境 支持windows/linux/mac平台 具体原理 请见PDF-Extract-Kit PDF
文档
中包含大量知识信息,然而提取高质量的PDF内容并非易事。 :0.2-models dockerhub地址:docker pull quincyqiang/
mineru
:0.2-models 启动命令: docker run -itd --name=
mineru
_server
致Great
2025-06-25
3.5K
1
标签:
api
pdf
表格
镜像
模型
MetaQ安装
部署
文档
一.MetaQ安装
部署
情况: 地点 IP Broker ID Master/Slave Slave ID:Group 合肥 192.168.52.23 1 Slave 1:meta-slave-group-hf
部署
解压tar zxvfmetaq-server-1.4.6.2.tar.gz,将解压出来的taobao/metamorphosis-server-wrapper文件夹移动到/usr/lib下,并重命名为
星哥玩云
2022-06-28
942
0
标签:
html
zookeeper
https
node.js
网络安全
问题归档
专栏文章
快讯文章归档
关键词归档
开发者手册归档
开发者手册 Section 归档