腾讯云
开发者社区
文档
建议反馈
控制台
登录/注册
首页
学习
活动
专区
圈层
工具
MCP广场
文章/答案/技术大牛
搜索
搜索
关闭
发布
文章
问答
视频
用户
沙龙
专栏
专区
综合排序
丨
最热优先
丨
最新优先
时间不限
如何批量
识别
图片
文字并重命名,批量区域
识别
图片
内容
对
图片
改名
,基于WPF和腾讯OCR的解决方案
为了解决这一问题,本项目旨在开发一个基于WPF(Windows Presentation Foundation)的桌面应用程序,结合腾讯OCR(光学字符
识别
)技术,实现批量
识别
图片
中的文字并根据
识别
结果对
图片
进行重命名或区域
内容
识别
后处理 通过本项目,用户可以:批量上传
图片
文件。使用腾讯OCR API
识别
图片
中的文字。根据
识别
的文字
内容
对
图片
进行重命名。支持选择特定区域进行
内容
识别
,并基于区域
内容
进行处理。 主窗口布局菜单栏:文件:打开
图片
文件夹、退出应用帮助:关于、帮助文档工具栏:选择
图片
文件夹按钮开始
识别
按钮设置按钮(用于配置OCR参数)主
内容
区:
图片
列表展示:显示已选择的
图片
缩略图, 功能实现
图片
加载与展示:用户可以通过界面选择包含
图片
的文件夹,程序加载并展示
图片
的缩略图、文件名及
识别
状态。OCR文字
识别
:利用腾讯OCR API对每张
图片
进行文字
识别
,提取
图片
中的文本
内容
。 结果处理与文件重命名:根据
识别
到的文字
内容
,自动重命名
图片
文件,确保文件名的唯一性和可读性。进度与日志显示:实时显示处理进度和操作日志,提升用户体验。2.
不负众望
2025-03-26
3.6K
0
标签:
玩转腾讯云OCR
文字识别
图片处理
TI-OCR 训练平台
【
图片
区域
识别
教程】如何批量区域
识别
图片
文字,并用文字
内容
来批量
改名
,基于WPF和腾讯OCR的详细步骤教程
通过批量区域
识别
图片
文字,提取关键信息用于
图片
重命名,能使商品
图片
管理更加规范有序,方便运营人员快速查找和使用,提升商品信息管理效率。 咕嘎批量OCR
识别
图片
PDF多区域
内容
重命名导出表格系统(windows版本)
图片
二、基于 WPF 和腾讯云 OCR 的详细步骤 (一)准备工作 确认环境配置: 已安装并配置好 Visual Studio : 在StartProcessing_Click方法中,遍历
图片
文件列表,调用修改后的
识别
方法进行区域
识别
。 ImageInfo{ public string FilePath { get; set; } public string RecognizedText { get; set; }} (四)用
识别
文字
内容
批量
改名
批量重命名
图片
: 在StartProcessing_Click方法中,遍历imageInfos列表,调用重命名方法对
图片
进行
改名
。
不负众望
2026-07-03
3.7K
0
标签:
ocr
玩转腾讯云OCR
文字识别
TI-OCR 训练平台
【
图片
区域
识别
】OCR指定区域
图片
自动
识别
内容
重命名,指定
图片
多个
识别
区域,
识别
文字并批量对
图片
文件
改名
,基于WPF和腾讯OCR的完整实现方案
在上架商品时,运营人员需要逐一查看
图片
内容
,确认商品款式、颜色、尺码等信息,然后手动将
图片
重命名为有意义的格式,例如 “商品名称_颜色_尺码_展示角度.jpg”,以便后续在商品详情页精准调用。 这个过程耗时费力,一旦
图片
数量众多,还容易出现信息匹配错误。运用 OCR 指定区域
图片
自动
识别
内容
重命名技术后,情况大为改观。 以下是使用 WPF 和腾讯 OCR 实现指定区域
图片
自动
识别
内容
重命名的详细步骤和完整代码: 咕嘎批量OCR
识别
图片
PDF多区域
内容
重命名导出表格系统(windows版本) 找到Timor君发消息【
图片
识别
改名
实现 OCR
识别
和文件重命名逻辑:编写代码实现
图片
指定区域的 OCR
识别
,并根据
识别
结果对
图片
文件进行重命名。 详细步骤和代码 1.
识别
区域的格式为X,Y,Width,Height,多个区域用分号分隔。 通过以上步骤和代码,你可以实现使用 WPF 和腾讯 OCR 对指定区域
图片
进行自动
识别
内容
重命名的功能。
不负众望
2026-06-22
6.3K
0
标签:
玩转腾讯云OCR
文字识别
通用文字识别
pdf
wpf-controls
【PDF
识别
重命名】如何
识别
PDF区域
内容
对文件进行
改名
处理或将
内容
导出表格
咕嘎批量OCR
识别
图片
PDF多区域
内容
重命名导出表格系统(windows版本) 找到【Timor君】发消息【PDF
识别
改名
】
图片
要实现
识别
PDF 区域
内容
并对文件进行
改名
处理,或者将
内容
导出到表格 这里以Poppler库进行 PDF
内容
提取,LibXL库进行表格数据导出为例,下面是详细的解决方案。 环境准备 Poppler:用于解析和提取 PDF 文件
内容
。
识别
PDF 区域
内容
使用Poppler库打开 PDF 文件,提取指定区域的文本
内容
。 2. 文件
改名
处理 根据提取的
内容
对 PDF 文件进行重命名。 3.
内容
导出表格 使用LibXL库将提取的
内容
导出到 Excel 表格。 main:调用上述函数,完成 PDF
内容
提取、文件重命名和
内容
导出到 Excel 的操作。
不负众望
2026-06-22
3.1K
0
标签:
文字识别
pdf
通过
图片
识别
文字工具快速获取
内容
最近开发过程中,处理一些信息是需要通过打开
图片
再去一行一行去敲,非常耗时和繁琐,有时候还会出现一些错误,比如获取
图片
中的订单号、用户ID等这些信息,很繁琐,又长又很恶心。 通过
图片
识别
文字工具可以快速解决该问题,直接从电子书、
图片
等中直接获取需要的数据。 使用方法 默认快捷键 F4 ? ? 工具设置 打开该工具后,会自动隐藏,需要到电脑右下角查看。 ? 右键→设置 ?
逍遥壮士
2020-09-18
5.6K
0
标签:
工具
公众号
开发
快捷键
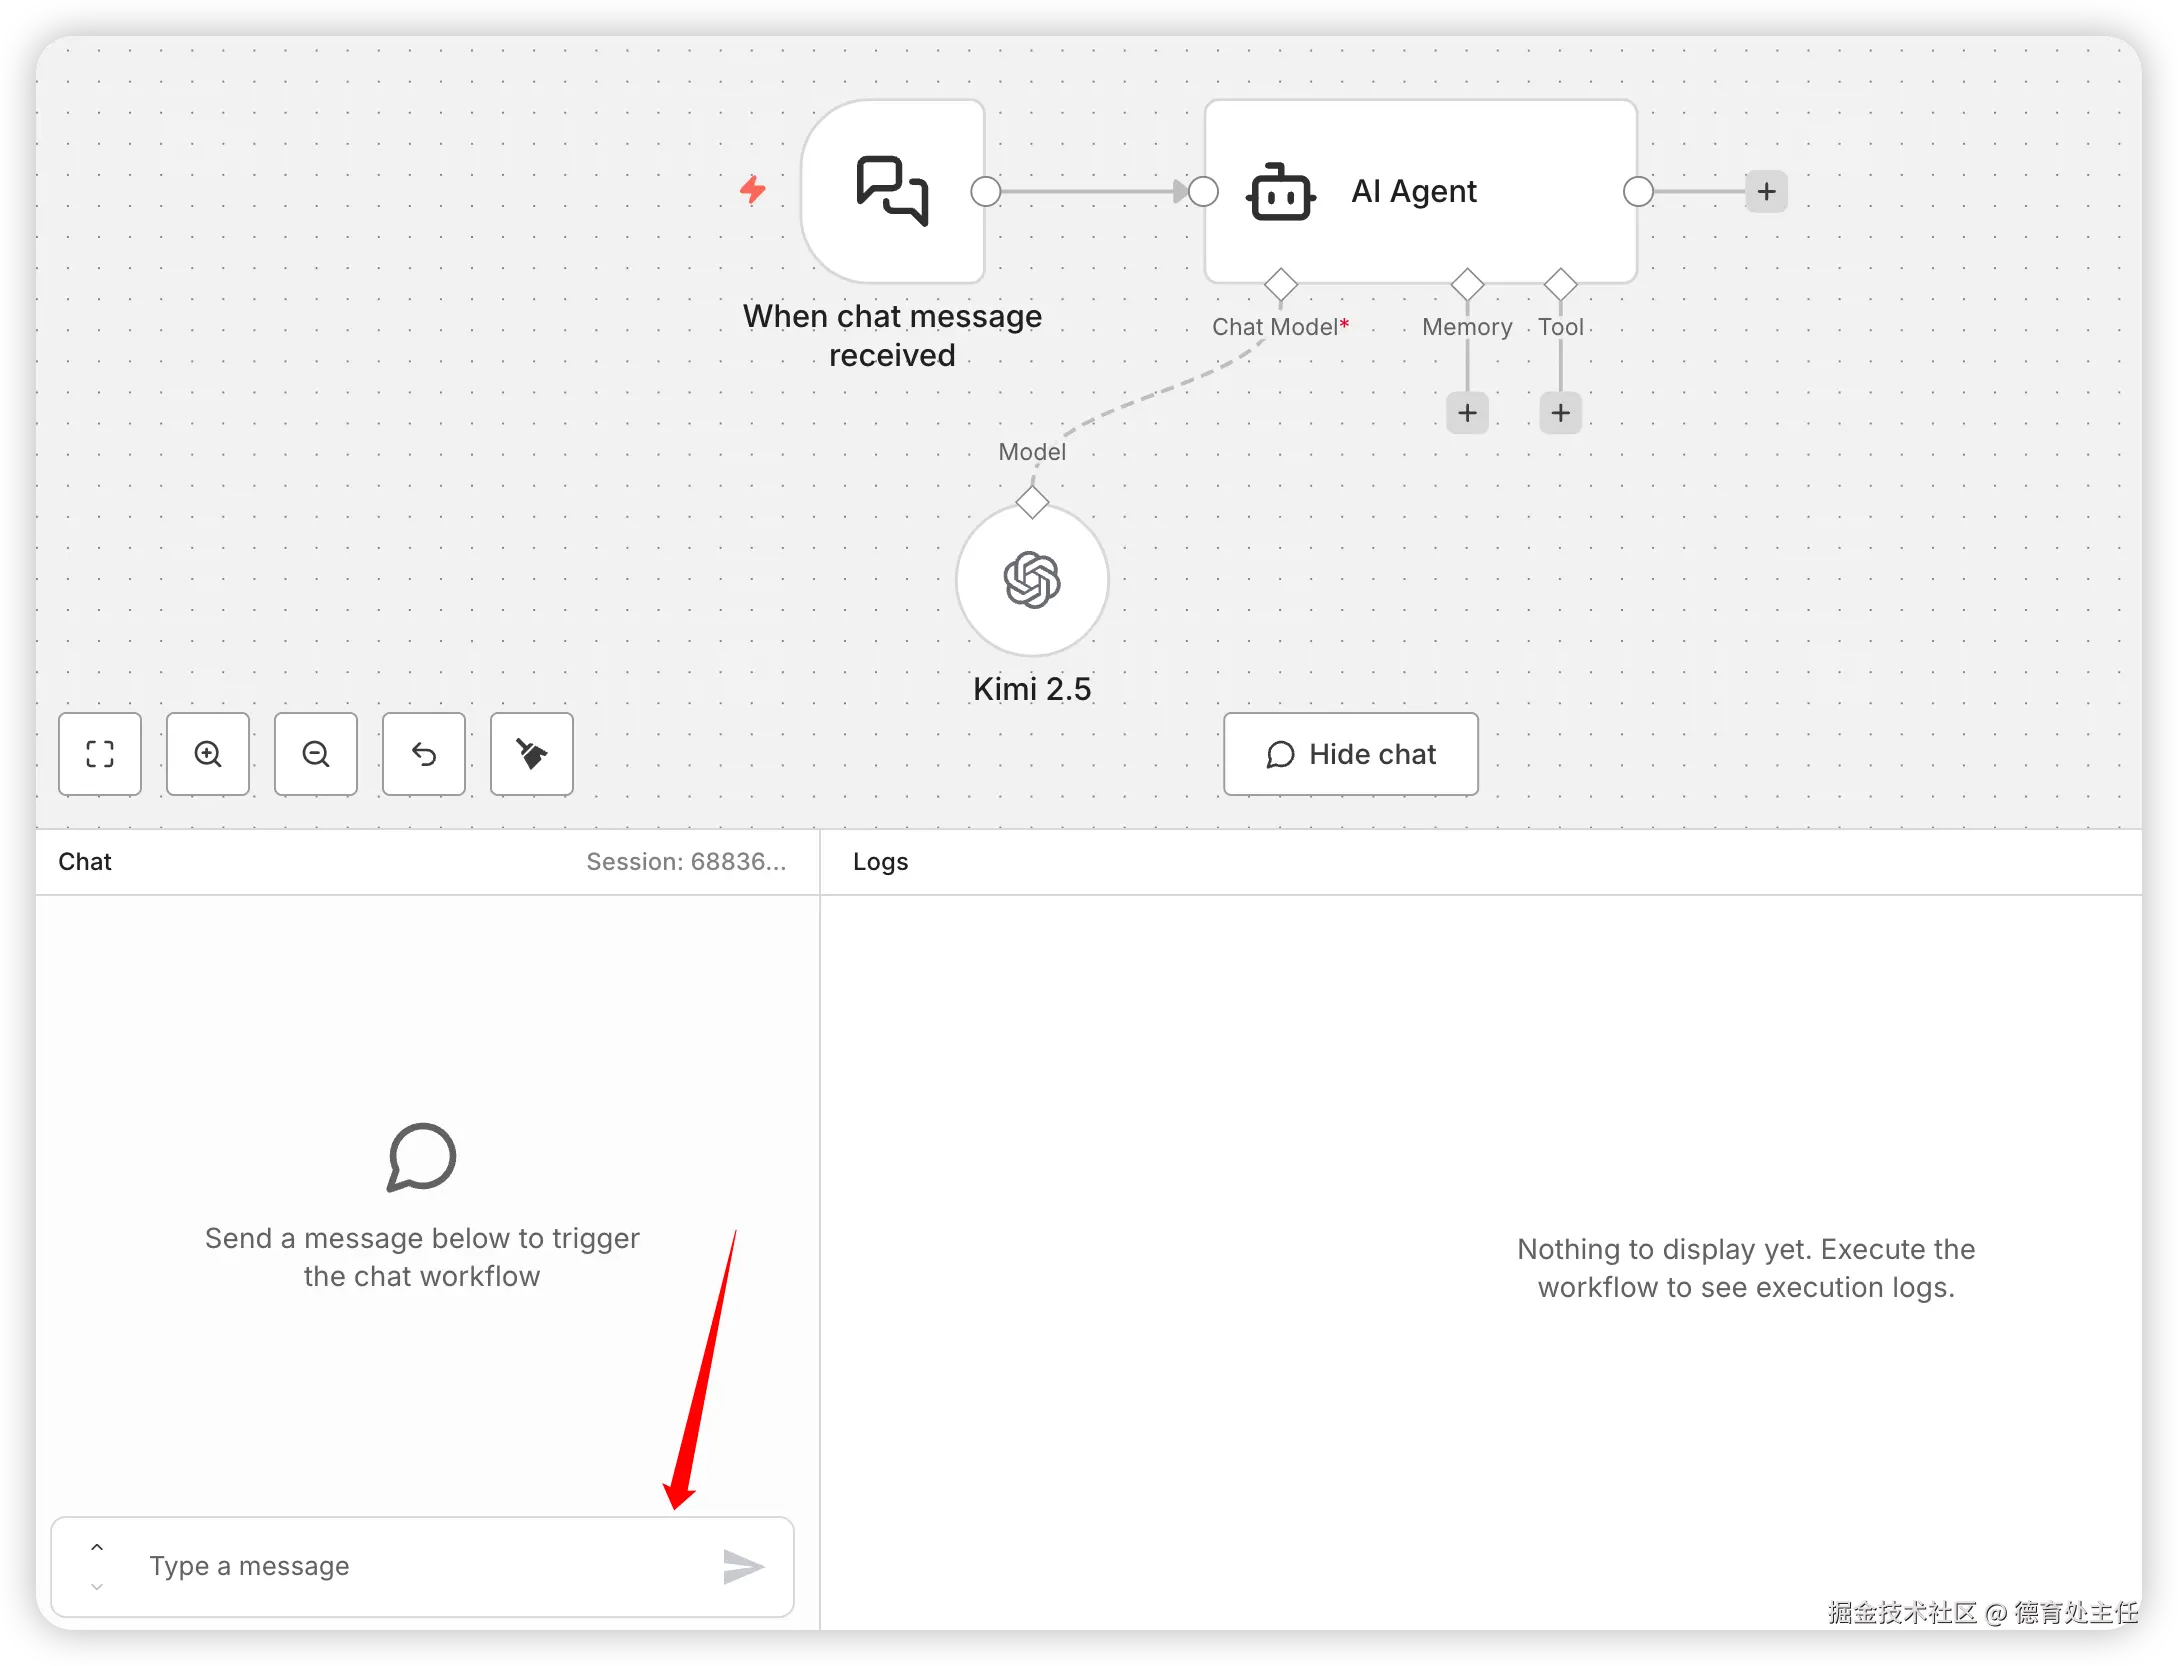
『n8n』让大模型
识别
图片
内容
但需要你用多模态大模型,才能
识别
图片
内容
。我用 Kimi-k2.5 演示一下。 上传一张小恐龙
图片
。 问它“这张图里的动物是什么?”。 Kimi-k2.5 很快就
识别
出来了。 以上就是本文的全部
内容
啦,想了解更多n8n玩法欢迎关注《n8n修炼手册》 如果你有 NAS,我非常建议你在 NAS 上部署一套 n8n,搞搞副业也好,帮你完成工作任务也好 《『NAS』不止娱乐,NAS也是生产力
德育处主任
2026-10-10
179
0
标签:
工具
工作
工作流
模型
部署
【图像区域
识别
改名
】JPG的
图片
和扫描件如何区域
识别
重命名,并将区域
内容
保存为表格,基于QT和腾讯API的实现方案
这些文件的关键信息(如文件编号、日期、主题等)可能分布在
图片
的特定区域。通过区域
识别
重命名,可以将
图片
文件按照关键信息命名,同时将这些信息保存到表格中,方便后续的检索和管理。 咕嘎批量OCR
识别
图片
PDF多区域
内容
重命名导出表格系统(windows电脑版本)
图片
以下是一个基于 QT 和腾讯云 OCR API 实现对 JPG
图片
和扫描件进行区域
识别
重命名,并将区域
内容
保存为表格的详细方案 ".jpg"; QFile::rename(imagePath, QFileInfo(imagePath).absolutePath() + "/" + newName); // 将
识别
结果保存到表格 UI 设计 在 QT Designer 中设计界面,添加一个按钮用于选择
图片
,一个表格用于显示
识别
结果,另一个按钮用于保存表格数据到文件。 6. 通过以上步骤,你可以实现对 JPG
图片
和扫描件的区域
识别
重命名,并将
识别
结果保存为表格。
不负众望
2026-02-22
1.7K
0
标签:
文字识别
云 API
【全自动
识别
改名
】批量
图片
文字
识别
与自动重命名实战指南,实现
图片
文字
识别
区域文字并自动重命名,用腾讯OCR教你实现
项目背景 在医院中,有大量的X光、CT等医学影像
图片
。
识别
影像中的病变特征、人体器官等信息进行
改名
,将患者的病情诊断摘要、检查日期等信息导出到表格,可以提高医疗影像资料的管理效率,方便医生快速查阅和对比患者的影像资料。 咕嘎批量OCR
识别
图片
PDF多区域
内容
重命名导出表格系统(Windows版本)
图片
要实现批量
图片
文字
识别
并根据
识别
结果自动重命名
图片
的功能,你可以使用腾讯云的 OCR(光学字符
识别
)API。 登录控制台,开通文字
识别
服务,并创建一个 API 密钥(SecretId 和 SecretKey)。 2. 文件路径:确保
图片
所在目录和代码中的路径一致。 通过以上步骤,你可以实现批量
图片
文字
识别
并根据
识别
结果自动重命名
图片
的功能。
不负众望
2026-06-22
3K
0
标签:
玩转腾讯云OCR
c++
图片标签
图片处理
pdf
TensorFlow从1到2(五)
图片
内容
识别
和自然语言语义
识别
在《从锅炉工到AI专家(8)》文中,我们演示了一个使用vgg19神经网络
识别
图片
内容
的例子。那段代码并不难,但是使用TensorFlow 1.x的API构建vgg19这种复杂的神经网络可说费劲不小。 (1,224,224,3)这样的形式 # 相当于建立一个预测队列,但其中只有一张
图片
img = np.expand_dims(img, axis=0) # 使用模型预测(
识别
) predict_class = model.predict(img) # 获取
图片
识别
可能性最高的3个结果 desc = vgg19.decode_predictions(predict_class 仍然使用原文中的
图片
尝试
识别
: $ . 使用这种方式,在
图片
识别
中,换用其他网络模型非常轻松,只需要替换程序中的三条语句,比如我们将模型换为resnet50: 模型引入,由: from tensorflow.keras.applications
俺踏月色而来
2019-04-25
3.6K
0
标签:
keras
tensorflow
神经网络
机器学习
深度学习
语音
识别
内容
PAAS层 语音
识别
的技术原理 产品功能 采样率 语种 行业 自服务 效果自调优 VAD静音检测 录音文件
识别
,一句话
识别
,在ASR服务端处理。 VAD是减小系统功耗的,实时音频流。 接口要求 集成实时语音
识别
API 时,需按照以下要求。
内容
说明 支持语言 中文普通话、英文、粤语、韩语 支持行业 通用、金融 音频属性 采样率:16000Hz或8000Hz、采样精度:16bits、声道:单声道 音频格式 wav、pcm、opus、speex Q2:实时语音
识别
的分片是200毫秒吗? A2:IOS的SDK. 200ms对应的 3. 输出参数 参数名称 类型 描述 Data Task 录音文件
识别
的请求返回结果,包含结果查询需要的TaskId RequestId String 唯一请求 ID,每次请求都会返回。
算法发
2020-07-30
12.3K
0
标签:
语音识别
问题归档
专栏文章
快讯文章归档
关键词归档
开发者手册归档
开发者手册 Section 归档
