
腾讯云
开发者社区
文档
建议反馈
控制台
登录/注册
首页
学习
活动
专区
圈层
工具
MCP广场
文章/答案/技术大牛
搜索
搜索
关闭
发布
文章
问答
视频
用户
沙龙
专栏
专区
综合排序
丨
最热优先
丨
最新优先
时间不限
【
翻译
】2025年:
大
语言
模型
年度回顾
关于这项技术重要性的最佳解释,我首选 Andrej Karpathy 的阐述:通过在许多环境中(例如考虑数学/代码谜题)针对自动可验证的奖励来训练
大
语言
模型
,
大
语言
模型
会自发形成在人类看来类似“推理”的策略 因此,2025 年大部分的能力进步来自于
大
语言
模型
实验室消化这一新阶段带来的积压需求,总体而言,我们看到
大
语言
模型
的规模大致相同,但 RL 运行时间要长得多。 命令行中的
大
语言
模型
之年2024 年,我花了很多时间折腾我的 LLM 命令行工具,以便从终端访问
大
语言
模型
,我一直觉得奇怪的是,几乎没人认真对待通过 CLI 访问
模型
的方式——它们感觉非常符合 Unix 也许终端太怪异、太小众,永远无法成为访问
大
语言
模型
的主流工具?Claude Code 及其伙伴们已经确凿地证明,只要有足够强大的
模型
和合适的工具,开发者会拥抱命令行上的
大
语言
模型
。 长任务之年最近关于
大
语言
模型
最有趣的图表之一来自 METR 的《不同
大
语言
模型
能完成 50% 的软件工程任务的时间范围》:该图表显示了人类需要长达 5 小时完成的任务,并绘制了能够独立实现相同目标的
模型
的演进过程
于顾而言SASE
2026-01-09
1.7K
0
标签:
大模型部署
AI
大
模型
测评
:GPT-5.5翻车、Claude封神
一、GPT-5.5翻车、Claude封神——
大
模型
选型的残酷真相(一)颠覆认知:GPT-5.5惨败,Claude封神,这份
大
模型
实战榜单撕开了谁的遮羞布? 当“OpenAI”三个字几乎成为人工智能代名词的今天,你敢相信GPT-5.5在一场覆盖1380次标准化测试的实战
测评
中,成功率竟然只有59.4%,不仅被Claude系列甩开30个百分点以上,甚至被国产
模型
这不是某个“野榜”的哗众取宠,而是AiPy在7月8日发布的《第八期
大
模型
适配度
测评
报告》中呈现的残酷真相。 这份报告用90小时的实际交互、3800万Tokens的真实消耗,在18
大
核心应用场景中完成了对20款主流
大
模型
的“压力测试”。 AiPy的
测评
覆盖了18
大
核心应用场景,包括视觉理解、音频生成、HTML制作、UI设计、软件控制、编程开发等。
天青色等烟雨111
2026-07-13
461
0
标签:
LLM
prompt
自然语言处理
AIGC
测评
国内多模态
大
模型
,到底哪个更省事?
现在,大家对基础
模型
能力诉求越来越高了,不再满足文本输入,而是混合输入。
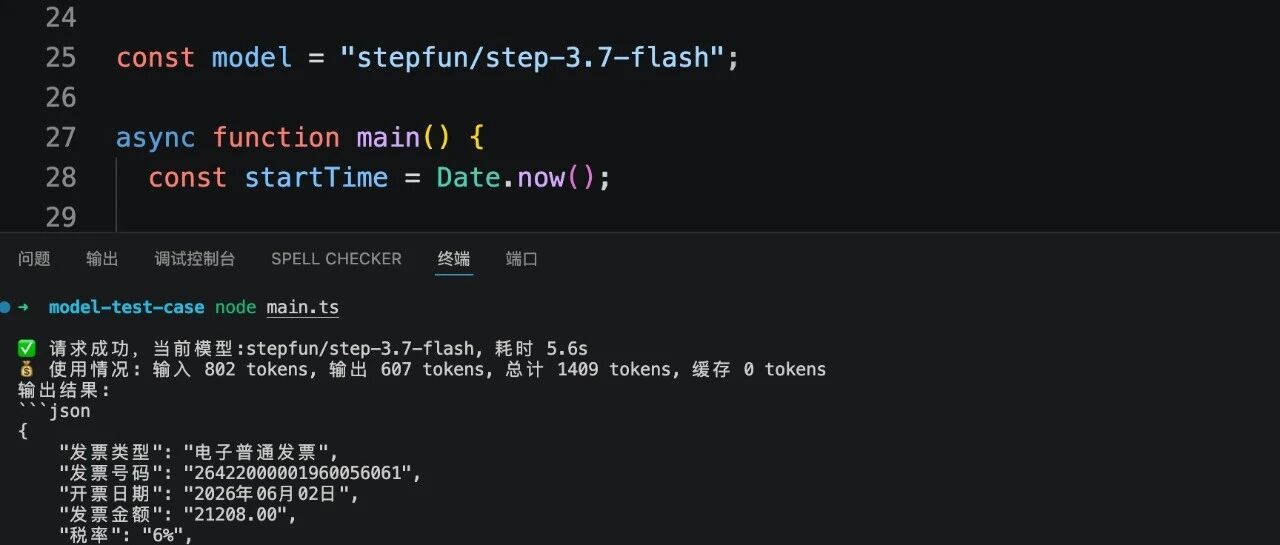
测评
说明 为了测试保证公平性,这里我把
测评
方式和
测评
标准先摆出来,不偏袒任何一家
模型
,行就是行,不行就不行,只用事实和数据说话。 成本:
模型
单价和token消耗,还看后续要不要人工投入。 因为评价一个
模型
能不能在生产环境使用,核心就看这三个关键维度。 下面我们再看一个在业务系统中使用多模态
模型
的案例。 好了,以上
测评
仅代表个人实际
测评
,大家也可用类似的任务去感受一下Step 3.7 Flash的多模态理解和执行的整体表现。
苏三说技术
2026-07-02
524
0
标签:
测试
脚本
模型
数据
系统
【AI绘图
大
模型
测评
】Stable Diffusion
模型
分享:Beautiful Realistic Asians——亚洲人脸生成必备
大
模型
!
【AI绘图
大
模型
测评
】Stable Diffusion
模型
分享:Beautiful Realistic Asians——亚洲人脸生成必备
大
模型
! beautifulRealistic_v60.safetensors beautifulRealistic_v7.safetensors 最近这段时间,我在研究一批 Stable Diffusion 写真类
大
模型
它几乎可以说是 生成亚洲人脸的必备
模型
,光影感、皮肤质感、服饰细节都接近摄影级水准。 本次我就来详细
测评
一下这款
模型
的真实表现。 我已将
模型
上传到国内网盘,大家可以前往下载体验: https://uwtxfkm78ne.feishu.cn/wiki/MPqdwVcjdij8I3kxXgOc4g4enge 该系列
模型
的官方简称是 二、
模型
版本亮点:v40带来的惊艳提升 在今年4月份,BeautifulRealistic
模型
迎来了 v40版本更新。
代码简单说
2026-06-16
941
0
标签:
prompt
模型
LoRa
告别语义不准,拥抱智能
翻译
——8 款网页
翻译
插件深度
测评
网页
翻译
常遇漏译错译,视频无字幕难理解,学术文献、外语课程等场景的语言障碍亟待解决。本次精选 8 款主流网页
翻译
插件深度
测评
,从功能覆盖、
翻译
精准度等多维度对比,重点推荐会译 AI
翻译
插件。 54 种语言互译,生僻词也能精准识别图片
翻译
:OCR+AI 识别海报、截图里的外文,一步出结果学习模式:内置四六级、雅思词库,生词自动高亮还能加生词本多 AI
模型
加持:自动匹配最优
翻译
模型
,专业术语比其他工具准太多适用人群 【谷歌
翻译
】推荐指数:★★★★功能亮点:支持多语言网页
翻译
,提供离线
翻译
选项,相机实时
翻译
所见内容,支持语音对话
翻译
。适用人群:跨境出行者、多语言日常使用者总结:覆盖场景广泛,基础
翻译
需求均可满足。 【沉浸式
翻译
】推荐指数:★★★★功能亮点:支持网页、PDF
翻译
,提供视频字幕
翻译
,可切换多种
翻译
引擎,保留原文排版。适用人群:深度阅读者、视频学习者总结:
翻译
侵入性低,阅读体验流畅。 综合来看,会译 AI
翻译
插件凭借智能 AI
模型
与独特双语对照
翻译
成为最佳推荐。其全面覆盖网页、文档、视频等场景,精准度与效率优势显著,为各类外语接触者提供一站式
翻译
解决方案。
用户11757497
2025-08-29
4.6K
0
标签:
翻译
使用智谱AI
大
模型
翻译
视频字幕
不久前,国内的头部
大
模型
厂商智谱 AI ,刚刚推出了 glm-4-0520
模型
,该
模型
被认为是当前平台最先进的
模型
,具备 128k 的上下文长度,并且相较于前一代
模型
,指令遵从能力大幅提升 18.6% 可以看出,智谱AI对于该
模型
寄予厚望。 为了验证这个大
模型
的性能,我们尝试用它来实现【视频字幕
翻译
】功能。 因此,我们决定利用
大
模型
,将视频的字幕
翻译
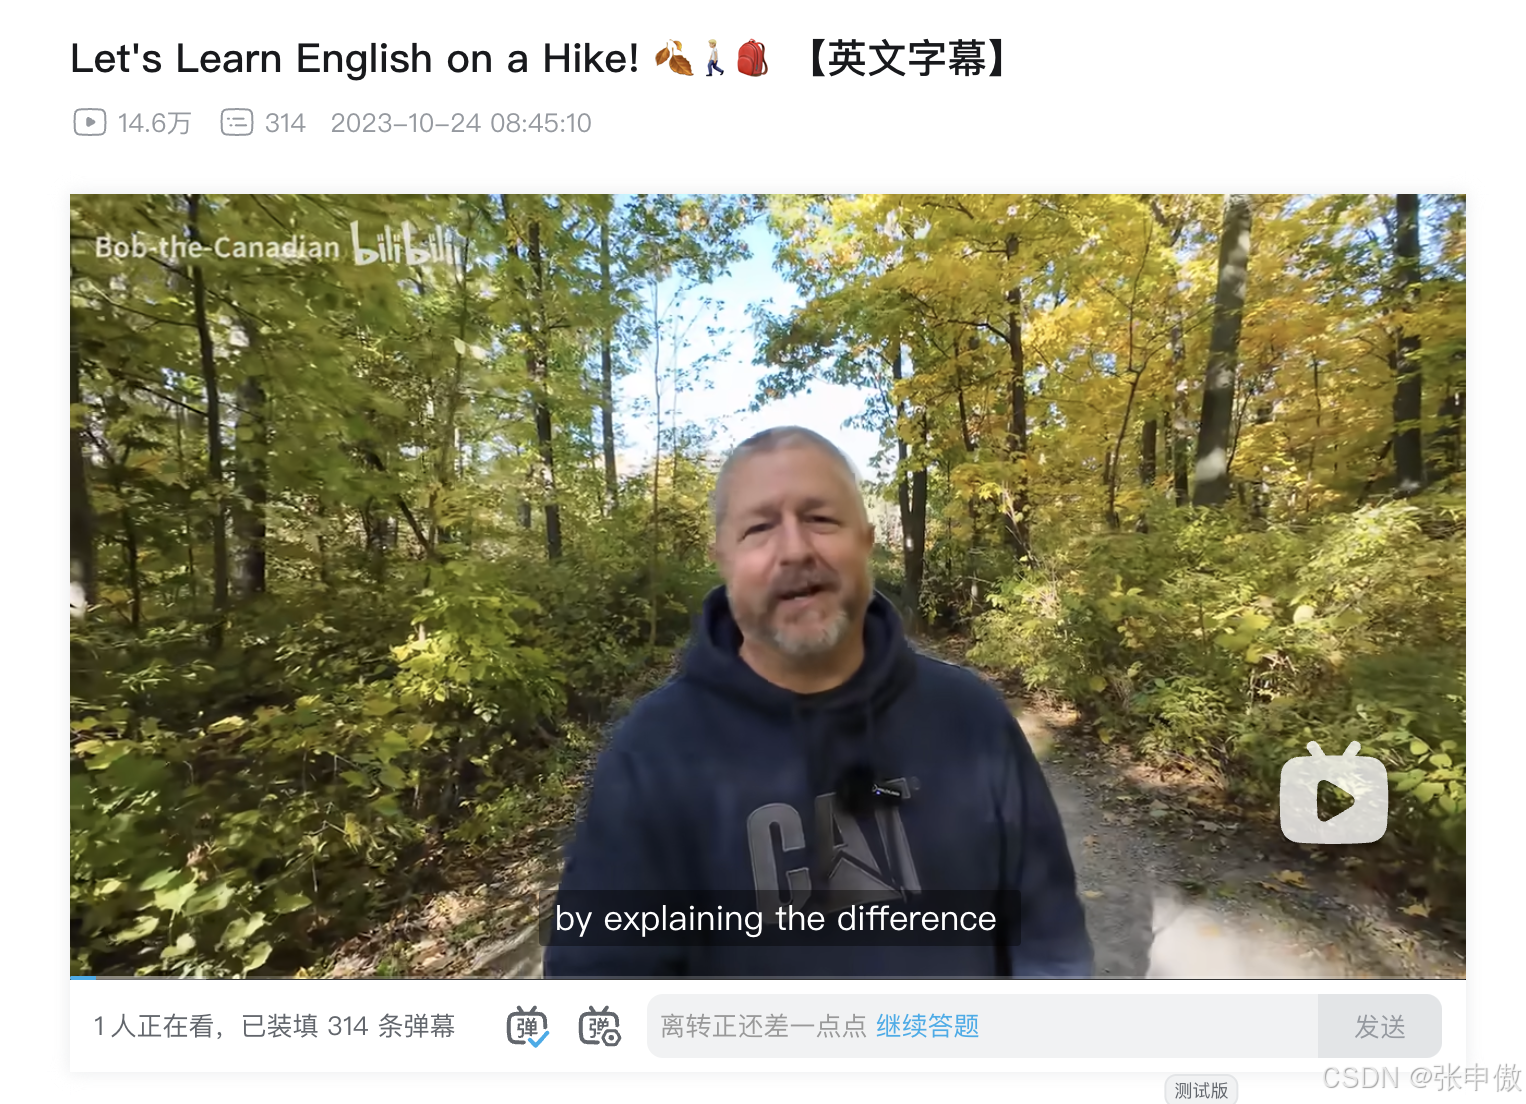
成中文,这样就可以快速理解视频的大致内容,大幅提升工作与学习效率。 下面,我们以 B站 上的视频为例,来实现这个功能。 下面,我们就可以利用智谱AI的 glm-4-0520
大
模型
,将原版的英文字幕
翻译
成中文: # 构造Chain,将原版的英文字幕
翻译
成中文 llm = ChatZhipuAI(model="glm-4- 还是有的,我们可以利用
大
模型
的 Embedding 能力,计算下原版的英文字幕和
翻译
后的中文字幕在语言上的相似性,如果二者的相似度很高,则大概率可以说明
翻译
基本复现了原始的内容。
张申傲
2024-09-06
2K
0
标签:
翻译
浏览器
模型
视频
网站
腾讯
翻译
大
模型
,手机可运行,本地部署
大家好,我是 Ai 学习的老章 2025 年最后一天,腾讯开源了 HY-MT1.5
翻译
大
模型
! 简介 HY-MT1.5(Hunyuan Translation Model Version 1.5)是腾讯混元团队推出的专业
翻译
大
模型
,包含两个版本: HY-MT1.5-1.8B:18 亿参数的轻量级版本 最牛的是,1.8B 的小
模型
翻译
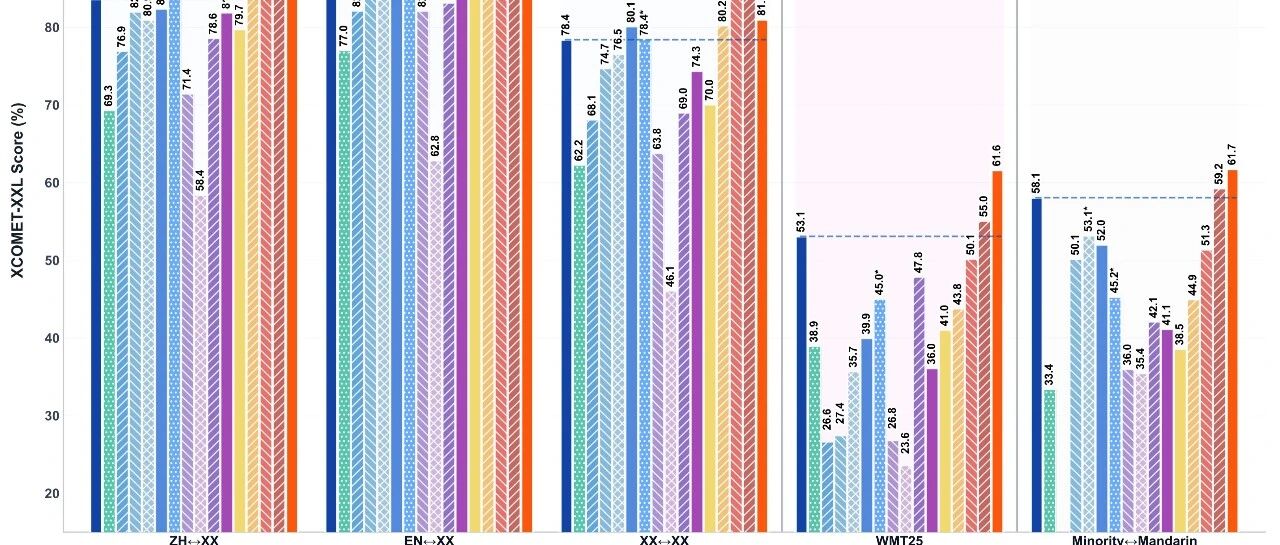
质量居然能逼近 7B
大
模型
,"小钢炮"属性拉满。 from=modelSquare&modelId=hunyuan-mt-1.8b 7B 也不咋地 这是我之前我写好但是没有发布的一篇文章中的
翻译
挑战题,感觉纯
翻译
大
模型
在这种难度的题目中,还是不如通用、 推理
大
模型
它最大的价值:量化后的 1.8B
模型
可以轻松部署在消费级显卡甚至边缘设备上,实时
翻译
场景完全 hold 住。
Ai学习的老章
2026-01-05
4.3K
0
标签:
手机
腾讯
部署
翻译
模型
「LongCat
大
模型
」赋能「沉浸式
翻译
」
点赞 + 关注 + 收藏 = 学会了 「沉浸式
翻译
」是一款免费 AI 驱动的浏览器插件,以双语对照为核心特色,智能识别网页主内容区域提供低干扰
翻译
体验,同时支持 PDF 文档、视频双语字幕(Youtube 「沉浸式
翻译
」免费提供了谷歌、微软等机翻功能,还有硅基流动、GLM等AI
翻译
能力。 但是免费的AI
翻译
用的都是几B的小
模型
。 想用大点的
模型
默认只能充值变强。 虽然几B
模型
也够用,但如果有免费的更强的
模型
,为什么不用呢? 好在「沉浸式
翻译
」没有锁死用户的选择权,我们可以“添加自定义
翻译
服务”。 我推荐过几次的「LongCat」又派上用场了。 每天免费刷新5500万token用量,问你怕未~ 点击「沉浸式
翻译
」的“添加自定义
翻译
服务”,然后选择“自定义AI”。 /ap…
模型
:写本文时 LongCat 提供了5款
模型
免费使用,按需选择即可 LongCat-Flash-Chat LongCat-Flash-Thinking LongCat-Flash-Thinking
德育处主任
2026-07-06
1.2K
0
标签:
配置
翻译
服务
浏览器
模型
测评
混元
大
模型
并且基于混元实战开发
腾讯混元
大
模型
现在正式全部开发,发起申请即可,在混元
大
模型
内测阶段我就已经在使用接下来我们迎接代码能力全面升级的混元
大
模型
! (腾讯混元
大
模型
「文生图」能力重磅上新! 目前官方内置了灵感模块(绘画)其中有: 赛博朋克、日漫动画、梵高、扁平插画、像素插画、马赛克等 11 种风格非常不错,我相信你看完这篇
测评
你会对混元
大
模型
有着强烈的喜欢功能的强大你们说的算,往下看! 混元
大
模型
对话页面 体验代码能力 我这里列举了不同的代码需求看看混元
大
模型
提升了百分之二十的强悍之处!!!! 那么我的
测评
就到这里啦感谢大家的观看谢谢!
杨不易呀
2024-01-30
3.8K
40
标签:
腾讯混元大模型
玩转腾讯混元大模型
DeepSeek V4 领衔实测:国产 AI
大
模型
工程代码能力
大
测评
!
随着 vibe coding 相关技术日趋成熟,
大
模型
辅助编程已经逐渐成为主流的开发方式。各大
模型
也在持续发力工程级代码能力,竞争愈发激烈。 在这个背景下,一个自然而然的问题出现了:对于 DolphinDB 这类深耕专业细分领域、自带编程语言的产品,
大
模型
的辅助效果到底如何?不同
模型
之间的差距有多大? 于是,我们跑了一轮系统性评测,覆盖当前主流的国产
大
模型
,并引入 gpt-5.4 作为能力基准线,看看国产
模型
的真实水位在哪里!测试框架和常见的问答式评测不同,这次我们刻意把测试环境做得更接近真实开发。 在这个层面,deepseek-v4-pro 和 deepseek-v4-flash 在国产
模型
里表现最佳,为第一梯队,其余
模型
都有一定差距。 后续,我们也会持续跟进的
模型
的迭代,并增加更多测试样本。希望了解更多测试细节?点击国产
大
模型
在 DolphinDB 代码生成任务上的
测评
- DolphinDB Blogs,进行跳转。
DolphinDB
2026-05-06
5.4K
0
标签:
dolphindb
问题归档
专栏文章
快讯文章归档
关键词归档
开发者手册归档
开发者手册 Section 归档