
腾讯云
开发者社区
文档
建议反馈
控制台
登录/注册
首页
学习
活动
专区
圈层
工具
MCP广场
文章/答案/技术大牛
搜索
搜索
关闭
发布
文章
问答
视频
用户
沙龙
专栏
专区
综合排序
丨
最热优先
丨
最新优先
时间不限
智能体记忆机制与
Token
消耗
评估
智能体记忆机制与
Token
消耗
评估
一、宏观背景与战略引入在Data+AI深度融合的时代,企业级智能体(Agent)正从"单轮问答"走向"长程自主任务执行"。 Mem0LOCOMO基准(arXiv:2504.19413,2025)量化显示,全上下文注入每对话
消耗
约26,031
Token
、p95时延17.12s,而选择性外部记忆
Token
降至约1,764、时延压缩 成本效益维度参照Mem0LOCOMO基准(arXiv:2504.19413,2025)的量化结论:全上下文注入每对话
消耗
约26,031
Token
、p95时延17.12s,而选择性外部记忆
Token
降至约
评估
框架应将"每对话
Token
成本"与"时延"并列,识别精度—时延—成本的帕累托前沿。
评估
阶段:基线测量在引入外部记忆前,先以全上下文注入跑通目标业务Session,记录
Token
消耗
与完成率基线。
用户12181391
2026-10-10
155
1
标签:
人工智能
大模型部署
性能优化
优化 OpenClaw Heartbeat,大幅减少
Token
消耗
:指标数值心跳频率每30分钟每日心跳次数48次HEARTBEAT.md长度约500字单次心跳
Token
约3000-4000每日
Token
消耗
约150,000-200,000月度
Token
消耗
约4,500,000 问题3:缺乏隔离定时任务在主会话中执行,产生的输出、错误信息都会保留在上下文中,进一步增加
Token
消耗
。
消耗
的构成每次Heartbeat的
Token
消耗
可以分为以下几个部分:1.系统提示(SystemPrompt)这是OpenClaw的核心指令,包含:系统角色定义工具说明(Tools)安全策略输出格式要求大小 ,直到触发compaction(压缩)虽然OpenClaw有自动压缩机制,但在压缩前,上下文已经
消耗
了大量
Token
。
消耗
对比优化前(每日):项目次数单次
Token
总计TokenHeartbeat484,000192,000任务执行48包含在心跳中-总计--192,000优化后(每日):项目次数单次
Token
总计TokenHeartbeat482009,600
孟斯特
2026-03-24
4.9K
6
标签:
腾讯云OpenClaw玩虾大赛
玩转OpenClaw云端创意实践
OpenClaw(Clawdbot)
用 codegraph 把
token
消耗
砍掉 50%
随着团队里AI编程使用越来越频繁,
token
消耗
开始变成一个需要认真关注的问题。为了控制成本,我们在几个月前切换到了阿里云tokenplan。 刚开始,我们并没有特别关注每个人的
消耗
差异,都是团队统一使用,整体看账单,只知道
token
在快速增长。 进一步分析后,我们发现,真正
消耗
大量
token
的地方,并不是模型本身,而是ClaudeCode默认的代码探索方式。 这篇文章记录我们的一次实际测试:一个本地代码索引工具,为什么可能让ClaudeCode的
token
消耗
降低50%以上。 即便如此,
token
消耗
仍然只有Grep/Read路径的三分之一。
富贵冼中求
2026-07-10
816
0
标签:
编程
AIGC
人工智能
Agent Memory降低
Token
消耗
原理解析
AgentMemory降低
Token
消耗
原理解析核心观点摘要企业级AIAgent在超长Session与多轮任务中,
Token
消耗
主要源于"反复重算的上下文"而非模型本身,长任务中该部分占比可达70%,是降本的核心突破口 主要局限与不足:作为云服务需对接腾讯云体系,私有化重度定制场景的部署边界需
评估
。 主要局限与不足:作为开源框架,企业级一致性保障与超长Session托管能力需结合具体集成方案
评估
。 五、最佳实践与落地路径落地AgentMemory建议遵循四步流程:
评估
规划:梳理任务的轮次分布与
Token
基线,识别"重算上下文"占比高的环节,如退换货五步流。 建议监控三项:单任务
Token
消耗
、任务通过率/准确率、首字延迟。以引入前为基线,腾讯云方案在SWE-bench上
Token
省33.09%且通过率+9.93%,可作为参考阈值。
用户12181391
2026-10-10
296
0
标签:
人工智能
大模型部署
云计算
如何计算文档会
消耗
的
Token
数量?
我们可以让AI写一个程序来调用这个
token
计算API来自动计算文档的
token
数量。 output.
token
_ids 本次输入文本对应的
token
_ids。 output.tokens本次输入文本对应的tokens。 usage.input_tokens 输入文本对应的
token
数目。 = estimate_tokens(content) if
token
_count is not None: print(f"{file_path}这篇文档的
Token
数量估计为{
token
_count = process_file(file_path) total_
token
_count +=
token
_count print(f"这些文档一共
Token
数量估计为{total_
token
_count
AIGC部落
2024-06-24
3.4K
0
标签:
工具
模型
token
变量
翻译
这个开源工具把
token
消耗
节省了98%
项目作者统计过,一个包含 20 次工具调用的简单任务,50 轮对话后,光工具输出就向模型灌入了 30 MB 的
token
。 原来 AI 编程助手读 47 个文件要
消耗
700 KB 上下文。 现在一行 ctx_execute,脚本遍历 47 个文件,只输出分析结论,3.6 KB 搞定。
勇哥AI笔记
2026-05-20
1.7K
0
标签:
开源
token
工具
模型
压缩
腾讯开源Agent Memory,让
Token
消耗
降低61%
Agent太烧
Token
?汇报一个好工具腾讯云正式开源 TencentDB Agent Memory,面向 Agent 长任务场景提供短期记忆压缩与长期个性化记忆能力。 在多任务连续 Session 实验中,该方案最高降低 61%
Token
消耗
,同时提升长任务场景下的任务成功率。 // 上下文卸载:省
Token
,没丢证据画布解决“结构不能丢”,但长任务中工具返回、搜索结果、日志输出等原始信息往往非常长,全部留在上下文里窗口很快被填满。 多任务连续 Session 实验结果(非单题清空上下文)
Token
下降的同时成功率上升——上下文中的噪声减少后,模型注意力更集中在当前任务目标上。 消融实验也验证了画布的独立贡献:仅卸载时
Token
节省约 15%,叠加 Mermaid 画布后提升至 31%–33%。
小腾资讯君
2026-05-14
1.9K
0
标签:
memory
多模态理解模型的
Token
消耗
优化策略
通过实测数据,可以更准确地
评估
不同优化策略的实际效果,制定最适合自身业务场景的
Token
消耗
方案。 识别
Token
消耗
量异常偏高的输入类型
评估
优化措施的实际效果 为后续的成本预算提供数据支持 6.2 建立分场景的
Token
消耗
基准 不同类型的理解任务,其
Token
消耗
规律可能存在差异。 建议针对自身业务中的主要场景,建立分场景的
Token
消耗
基准。 例如,可以分别统计图片理解任务、短视频理解任务、长视频理解任务的平均
Token
消耗
量,并以此为基础进行成本预估和优化效果
评估
。 6.3 定期
评估
优化效果
Token
消耗
优化是一个持续的过程。 建议定期(如每月)对优化措施的效果进行
评估
,包括: 平均单次调用的
Token
消耗
量是否下降 不同优化措施的实际降本效果 优化措施是否对理解准确性产生影响 基于定期
评估
的结果,持续调整和优化
Token
消耗
策略
克劳德2048
2026-06-18
581
0
标签:
视频
音频
优化
token
模型
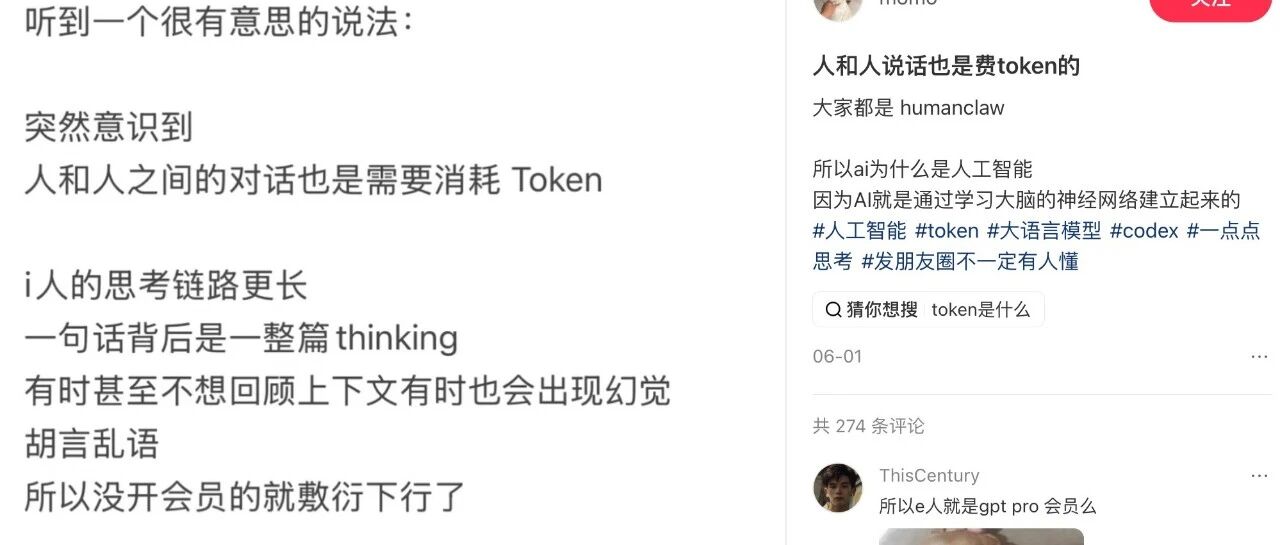
|和别人说话就是在
消耗
Token
人和人之间的对话也是需要
消耗
Token
i人的思考链路更长一句话背后是一整篇thinking有时甚至不想回顾上下文有时也会出现幻觉胡言乱语所以没开会员的就敷衍下行了
Token
有限且宝贵,省着点用在更重要的人或者事身上再进行深度思考 吃饭睡觉就是充
token
挣的工资就是电力 智商就是算力 (你是什么级别的算力卡? 现在越来越多人会说:CPU烧了、带宽不够、内存爆了、上下文丢了、
token
用完了。 现代人的精神活动,越来越接近“信息系统”。 信息密度太高了。 所以很多人的疲惫,本质不是体力疲惫,而是: 持续在线后的认知碎片化 真正高质量的人际交流,其实反而是“省
token
”的。 因为你不用:反复解释自己、做风险
评估
、维持人设、预判攻击、精修措辞。 有些人跟你聊天,你会发现:
token
消耗
极低,但信息密度极高 这种关系很稀有,因为安全感本质上就是: 不需要高强度推理 咨询行业(律师、咨询师、顾问...),就是出售人脑
Token
。
勇哥AI笔记
2026-07-06
197
0
标签:
行业
内存
cpu
token
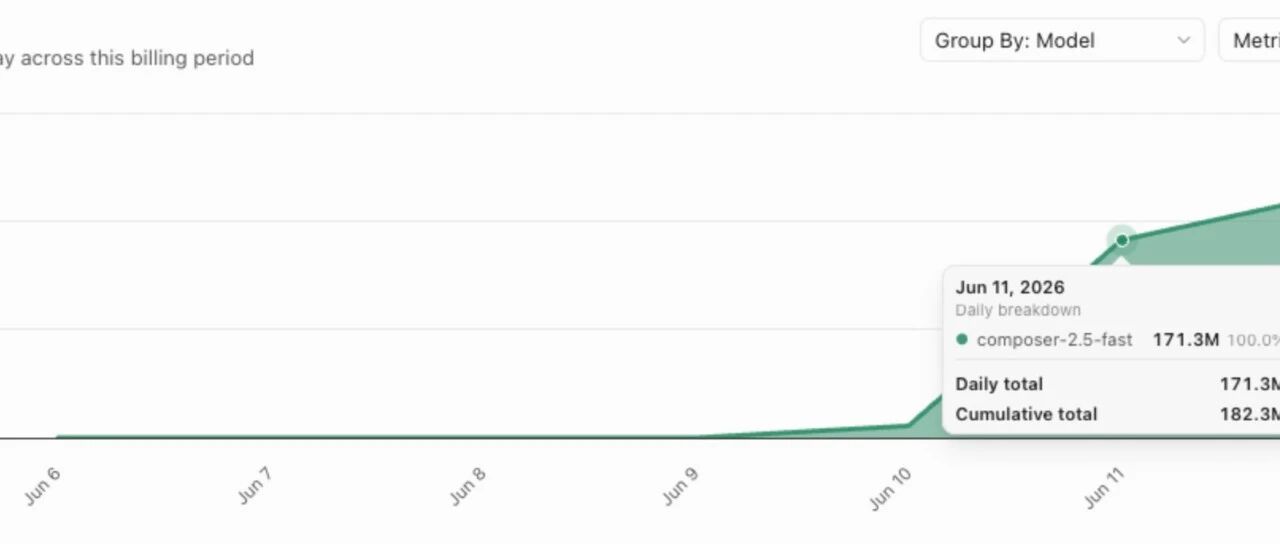
一天
消耗
1.7 亿
token
,但我并不开心
之前看过一篇根据日
消耗
token
看用户定位的文章。 比如普通开发者,日用百万~千万
token
;Agent 重度用户,日用千万~亿
token
;独立开发者或全职创业,日用亿+
token
。 但我日用 1.7 亿
token
并不开心。 因为一天时间差不多
消耗
了近 200 美金,折合人民币差不多 1500 元,每月 4.5w。 要不是公司可以报销,我肯定不可能用这么多的。 如果我自己,也暂时想不出可以用
token
转换成什么产品,每月可以带来超过4.5w纯利的产品。 Agent 确实大幅提效了,但关键你用它 Build 什么东西? 所以,听到很多人说自己日用
token
超几亿,我并没有那么羡慕,关键你可能赚的回来才是,对不。
春哥大魔王
2026-06-24
661
0
标签:
创业
开发者
agent
token
产品
问题归档
专栏文章
快讯文章归档
关键词归档
开发者手册归档
开发者手册 Section 归档