首页
学习
活动
专区
圈层
工具
发布
综合排序丨最热优先丨最新优先
时间不限
多模态数据与模型协同进化的自我推理框架
摘要多模态大语言模型(MLLMs)近期展现出卓越的推理能力,但进一步提升模型性能需要高质量视觉语言数据集,其标注成本高昂且难以扩展。 方法提出C2-Evo自动闭环自改进框架,通过双循环机制协同进化训练数据与模型能力:跨模态数据进化循环:基于初始数据集生成复杂多模态问题,结合结构化文本子问题与迭代生成的几何图表数据-模型进化循环:根据基础模型表现自适应选择生成问题
用户11764306
2025-09-17
3500
标签:
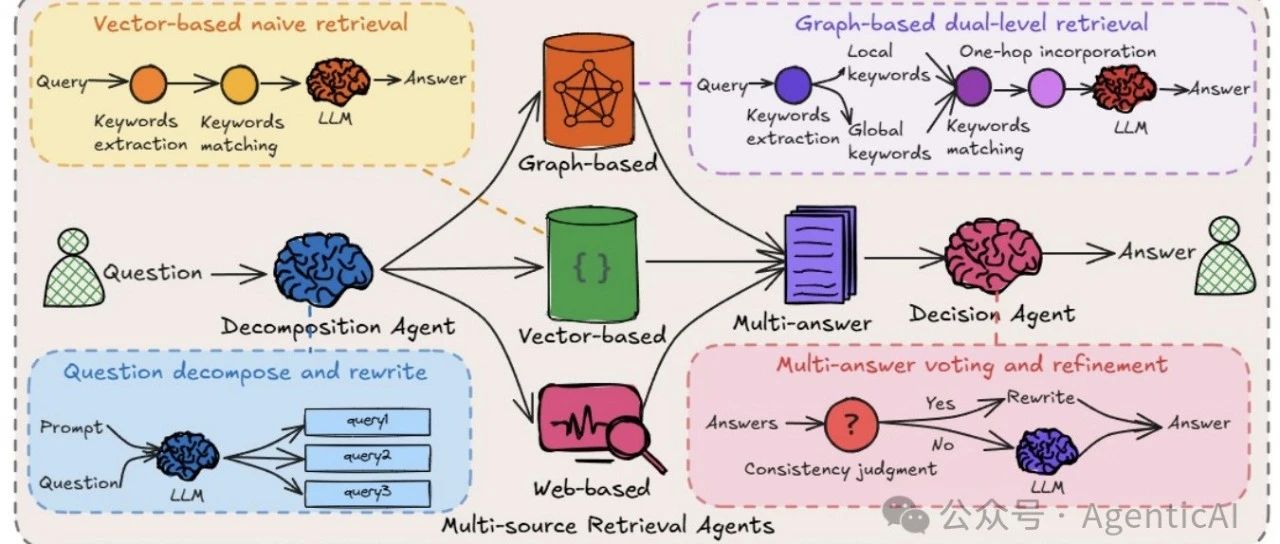
打破模态壁垒!上海 AI Lab & 港科大提出HM-RAG:多模态多智能体协同RAG系统
本文提出 HM-RAG,旨在通过多代理架构,动态整合结构化、非结构化和图形化数据,更有效地支持多模态问答和复杂查询。 2. 实验设计与结果 作者在 ScienceQA[1] 和 CrisisMMD[2] 两个多模态数据集上进行评估。 ScienceQA数据集表现 CrisisMMD 这些结果表明:多代理与多模态的结合,提升了对复杂查询的理解和生成质量。系统在统一框架下高效整合异构知识,是跨模态 RAG 的有效路径。 4. 而 HM-RAG 的图像代理成功识别出图中摄食关系,发现黑鲈是捕食者而非初级消费者;同时,文本代理从教科书中提取了初级消费者的定义,图文融合机制协同工作,最终推理出正确答案为 copepod(桡足类)。 这些结果表明:HM-RAG 通过多智能体协作,有效发挥各代理的模态专长,支持复杂场景下更细致和准确的推理过程,体现出其在多模态任务中的显著优势。 5.
AgenticAI
2025-04-22
9030
标签:
EMNLP 2021-多模态Transformer真的多模态了吗?论多模态Transformer对跨模态的影响
Motivation 视觉语言BERT模型扩展了BERT架构,以生成多模态输入的跨模态上下文表示。当对一系列下游任务进行微调时,这些模型已被证明是非常有效的。 如果测试过程中,去除某个模态的信息,对最终结果影响很大,那这个模态在最终预测的时候就是有用的;否则这个模态就是没用的。 多模态模型在预测时使用由多模态输入触发的跨模态激活。 这是原始的多模态设置,因此,有效使用多模态信息的模型应该表现最好。 Object: 在这里,作者只删除与对齐的文本短语相对应的图像区域,该模型仍然可以使用周围的视觉上下文特征 。 测试的模型显示了vision-for-language,而不是language-for-vision的结果,这一事实可能是多模态任务的积累,因为一些下游多模态任务需要强烈的 vision-for-language ▊ 作者简介 研究领域:FightingCV公众号运营者,研究方向为多模态内容理解,专注于解决视觉模态和语言模态相结合的任务,促进Vision-Language模型的实地应用。
CV君
2021-09-28
2.7K0
标签:
AI编程再突破,文心快码发布行业首个多模态、多智能体协同AI IDE
百度副总裁陈洋现场发布了文心快码独立AI原生开发环境工具——Comate AI IDE,是行业首个多模态、多智能体协同的AI IDE,首创设计稿一键转代码,开箱即用,为国内企业和开发者打造高效、智能、安全可靠的 文心快码推出的Comate AI IDE,在 “智能”、“拓展”、“协同”、“灵感”四大方面实现全方位链接,具备多项核心能力:AI辅助编码全流程、多智能体协同、多模态能力增强、支持MCP等,已成为AI时代工程师的 多模态能力也是这次Comate AI IDE的亮点之一,尤其在前端场景做了场景化增强。 会上,文心快码同时宣布“Comate Next计划”正式启动,向全球开发者与企业开放深度共建通道,加速AI驱动的人机协同研发范式落地。 该计划提供了全新进化的云端工作台,帮助开发者告别本地配置与协作的困境,首创“多智能体协同系统”,支持开发者自定义智能体或直接下达任务。同时面向企业提供专家1v1交流等深度共建权益。
用户10253342
2025-06-24
4070
标签:
PRCV 2023:语言模型与视觉生态如何协同?合合信息瞄准“多模态”技术
本次大会通过聚焦中国模式识别与计算机视觉领域的最新理论和技术成果解读、分享,进一步加强产学研领域的学术交流和技术碰撞,促进模式识别与计算机视觉领域的协同合作与融合创新。 智能文档处理技术是学术界重点关注的领域,而随着信息渠道的多样化发展,异构化、跨模态的数据层出不穷。文档图像是文字与图片领域的交集点,天然具备多模态属性。 在《视言碰撞:语言模型与视觉生态协同论坛》上,合合信息图像算法研发总监郭丰俊博士就文档图像前沿技术热点话题进行了分享。 郭丰俊表示,多模态技术可充分利用文档图像的视觉和语言属性,并借助语言大模型已取得的优异性能和技术积累,正逐渐成为文档图像处理领域的热门研究方向。 “从目前评测的情况来看,已知的多模态预训练系统在文档图像识别准确率上还逊于最先进的OCR识别系统。”
合合技术团队
2023-10-17
7480
标签:
AI编程再突破,文心快码发布行业首个多模态、多智能体协同AI IDE
百度副总裁陈洋现场发布了文心快码独立AI原生开发环境工具——Comate AI IDE,是行业首个多模态、多智能体协同的AI IDE,首创设计稿一键转代码,开箱即用,为国内企业和开发者打造高效、智能、安全可靠的 文心快码推出的Comate AI IDE,在“智能”、“拓展”、“协同”、“灵感”四大方面实现全方位链接,具备多项核心能力:AI辅助编码全流程、多智能体协同、多模态能力增强、支持MCP等,已成为AI时代工程师的 多模态能力也是这次Comate AI IDE的亮点之一,尤其在前端场景做了场景化增强。 会上,文心快码同时宣布“Comate Next计划”正式启动,向全球开发者与企业开放深度共建通道,加速AI驱动的人机协同研发范式落地。 该计划提供了全新进化的云端工作台,帮助开发者告别本地配置与协作的困境,首创“多智能体协同系统”,支持开发者自定义智能体或直接下达任务。同时面向企业提供专家1v1交流等深度共建权益。
默 语
2025-06-24
6392
标签:
agent多模态学习
二、多模态 Agent 的整体架构 一个完整的多模态 Agent 系统通常包含以下层次,其数据流如下: 用户多模态输入 → 多模态感知层 → 意图理解与规划层 → Agent 协作层 → 工具/环境交互层 → 反馈与优化层 → 多模态输出 2.1 多模态感知层 (Multimodal Perception Layer) 作为系统的“感官”,负责将原始的多模态输入转换为结构化的特征向量。 四、多模态意图理解与任务规划 4.1 多模态意图识别 多模态意图识别旨在从用户的文本、图像、语音等多种输入中,准确判断其核心需求。 多模态分类模型:训练一个分类器,输入为多模态特征,输出为意图标签。 LLM 直接判断:利用 GPT-4V 等具备视觉能力的模型,直接分析多模态输入并输出意图。 七、多模态内容生成 7.1 文本生成 基于融合后的多模态上下文,LLM 可以生成更精准、丰富的文本回复。
用户11993241
2026-01-15
1.4K0
标签:
腾讯发表多模态综述,什么是多模态大模型
多模态大语言模型(MLLM)是近年来兴起的一个新的研究热点,它利用强大的大语言模型作为大脑来执行多模态任务。 在本文中,追踪多模态大模型最新热点,讨论多模态关键技术以及现有在情绪识别上的应用。 ,并且提供了现有主流的 26 个多模态大模型的简介,总结了提升多模态大模型性能的关键方法,多模态大模型脱胎于大模型的发展,传统的多模态模型面临着巨大的计算开销,而 LLMs 在大量训练后掌握了关于世界的 多模态大模型的整体架构可以被归类为如下图的五个部分,整个多模态大模型的训练可以被分为多模态理解与多模态生成两个步骤。 多模态理解包含多模态编码器,输入投影与大模型主干三个部分,而多模态生成则包含输出投影与多模态生成器两个部分,通常而言,在训练过程中,多模态的编码器、生成器与大模型的参数一般都固定不变,不用于训练,主要优化的重点将落在输入投影与输出投影之中
存内计算开发者
2024-05-14
6.6K0
标签:
多模态算法综述
在UCF101数据集上达到了87%的准确率图片(2)Beyond Short Snippets: Deep Networks for Video Classification,尝试了多种多帧帧见融合策略如 自注意力至此视频理解算法演进到了Transformer的自监督网络架构,Transformer有两个优势,(1)更强的网络表征能力,(2)更容易设计自监督的训练任务,从而可以更有效的利用无标注数据,同时也更加注重多模态的内容理解 Vision-language Understanding with Contrastive Learning图片ALBEF包含一个图像编码器(ViT-B/16),一个文本编码器(BERT的前6层),以及一个多模态编码器 、多模态预训练方面提供大量的帮助,也给后来的文章提供了崭新的思路BLIP(Bootstrapping Language-Image Pre-training for Unified Vision-Language BLIP采用了判断-生成任务的MED,可以作为单模态编码器,基于图像的文本编码器解码器采用了CapFilt的训练方法,降低噪声图文pair对训练造成的影响图片Mult-streamMult-stream
yuyang
2022-07-12
3.4K0
标签:
【多模态大模型】
多模态大模型的核心能力 多模态大模型通过融合视觉、听觉、文本等多维度数据实现综合理解与生成。典型应用包括: 图像到文本:识别图片内容并生成描述、广告文案或诗歌。 跨模态检索:根据文本搜索相关图像/视频,或反之。 代表模型如GPT-4V(视觉增强版)、通义千问多模态版、文心一言(ERNIE-ViLG)均支持此类任务。 多模态对齐:模型将图像特征与文本语义空间对齐,生成候选描述。 输出优化:通过强化学习调整生成文本的流畅性与吸引力。 模型训练与优化要点 数据准备:需对齐的多模态数据集(如COCO-Captions、AudioSet)。 多模态大模型的应用需结合具体场景调整输入预处理与后处理逻辑,以达到最佳效果。
贺公子之数据科学与艺术
2026-01-20
7650
标签:
问题归档专栏文章快讯文章归档关键词归档开发者手册归档开发者手册 Section 归档
