首页
学习
活动
专区
圈层
工具
发布
综合排序丨最热优先丨最新优先
时间不限
无库无捷径,PyTorch 手写完整 Transformer 大语言模型 LLM
本文的目标很纯粹:不用任何高层封装库,只用 PyTorch 原生算子,从零实现一个完整的 Decoder-only Transformer 语言模型(GPT 架构,也是 GPT-4 / LLaMA / torch.nn.functional as Fimport mathclass Config: vocab_size = 10000 # 词表大小 d_model = 512 # 模型维度 # Sub-layer 2: FFN + 残差 x = x + self.dropout(self.ffn(self.norm2(x))) return x3.6 完整模型 Config 即可缩放模型规模:配置d_modeln_headsn_layers参数量对标教学版51286~38M—GPT-2 Small7681212~85MGPT-2GPT-2 Medium10241624 ~350MGPT-2 Medium工业级训练的真正瓶颈往往不在模型代码,而在数据吞吐——高质量语料的采集和清洗需要完整的数据管线支撑。
小白学大数据
2026-07-07
3450
标签:
为什么选择无服务器模型?
作者 | SparkFabrik Team 译者 | 王强 策划 | 褚杏娟 无服务器计算是一种执行模型,其中云服务提供商将资源动态分配给负责执行的部分代码。 在此模型中,客户只需为实际使用的资源付费。 代码通常运行在无状态容器中,可以由各种事件触发,如 HTTP 请求、数据库事件、队列服务、监控警报、文件上传等。那么为什么选择无服务器模型呢? 无服务器模型也称为“函数即服务(FaaS)”,可以为 IT 团队解决遇到的几个传统问题。 解决这些问题正是无服务器计算诞生的意义所在。 选择无服务器架构的好处 无服务器架构正变得越来越流行。 即付即用 与基础设施即服务(IaaS)模型(无论其实际使用情况如何,都需要租用硬件资源)不同,函数即服务(FaaS)模型基于“即用即付”:当事件调用函数时,只在执行函数所必要的严格时间内支付资源使用费
深度学习与Python
2022-03-23
1.2K0
标签:
【机器学习-无监督学习】概率图模型
  本文讨论无监督学习中的数据分布建模问题。当我们需要在一个数据集上完成某个任务时,数据集中的样本分布显然是最基本的要素。面对不同的数据分布,我们可能针对同一任务采用完全不同的算法。 如果我们只知道两个特征之间相关,但没有明确的单向依赖关系,就可以用无向图来建模,称为马尔可夫网络(Markov networks)。下面,我们就来介绍这两种概率图模型的具体内容。 贝叶斯模型给了我们一种理解正则化约束的更自然的视角。 三、用朴素贝叶斯模型完成文本分类 朴素贝叶斯(naive Bayes)是贝叶斯公式和贝叶斯网络模型的最简单应用。 这时,我们可以把贝叶斯网络的有向图变为无向图,构造出马尔可夫网络。    在图论中,如果一张无向图中的某些节点之间两两互相连接,我们就称这些节点组成了一个团(clique)。
Francek Chen
2025-01-22
6200
标签:
Model-Free Policy Evaluation 无模型策略评估
这里引入新的内容 如果我们不知道动态模型P/或奖励模型R呢? 在没有当前域的模型的情况下依然可用 MC和TD。 MC、TD 都是依靠采样,MC采样整个轮次,TD采样下一个状态,它们都不依赖模型。 对价值的估计是无偏的 MC是无偏估计,因为它采样真实值然后计算,所以当然没有bias。 First-Visit是unbais的,Every-Visit是bais的(不是真实值了)。 DP很奇怪,询问DP是否是无偏的是一个不公平的问题。DP永远会给你当前策略下确切的Vk−1V_{k-1}Vk−1​值。 如何选择这些算法? 使用这个模型计算VπV^\piVπ 在AB例题中,V(A)=0.75 无模型的策略评估算法重要特性 数据高效性 & 计算高效性 在最简单的TD,使用一次(s,a,r,s′)(s,a,r,s')(s,a
Steve Wang
2019-10-22
8640
标签:
无标签数据预测人脸识别模型偏差
方法利用无标签数据预测人脸识别模型中的偏差消除标注需求使偏差测试更加实用。 作者:Tiffany Deng2022年11月8日3分钟阅读会议ECCV 2022相关论文《人脸识别中的无监督和半监督偏差基准测试》近年来,算法偏差已成为跨AI学科研究的核心主题。 这一结果——无需标注面部身份的测试数据即可预测人脸识别模型的相对性能——令人惊讶,它提出了一种评估范式,应能使人脸识别软件的创建者更实际地测试其模型的偏差。 该图绘制了人脸识别模型的假阳性率(错误匹配率,FMR)与假阴性率(错误非匹配率,FNMR)的关系。该模型训练自"野外种族人脸"数据集,故意省略了"非洲人"类别以引入偏差。 实线为真实值,虚线为模型预测值,彩色区域为模型置信区间。即使在置信区间的外缘,性能差异也清晰可见。除了成本效益外,该方法还具有可即时适应新人口统计群体的优势。
用户11764306
2026-04-05
2280
标签:
【生成模型】关于无监督生成模型,你必须知道的基础
作者&编辑 | 小米粥 1 监督学习与无监督学习 监督学习的任务是学习一个模型(也可以理解为一个映射函数),使模型能够对于任意给定的输入,相应地做一个好的预测输出。 对于无监督学习的深入研究对深度学习的复兴上起到了关键的作用。 我们列举三种常见的无监督学习任务:降维、聚类、概率模型估计。 3 无监督生成模型 根据前两节,生成模型意味着对输入特征X和标签信息Y的联合分布进行建模,无监督学习意味着不存在标签信息,则在无监督生成模型中,希望对输入特征X的概率密度函数p(X)建模。 无监督生成模型是近些年深度学习的热门方向,但其已经拥有很长时间的发展。基于极大似然法的参数点估计可认为是最简单的无监督生成模型,上世纪80年代Hinton已经使用玻尔兹曼机学习二值向量的任意概率分布。 统计机器学习 总结 生成模型是一个非常有趣的领域,其中的内容也不只是对抗生成网络,也包括变分自编码器、流模型等,今天详细定义了一下什么是无监督生成模型,使大家有一个初步印象。
用户1508658
2020-11-11
2.4K0
标签:
无监督结果如何评估:安全攻防中的无监督模型评价体系
然而,与监督学习不同,无监督学习没有明确的真实标签用于模型评估,这给无监督模型的性能评价带来了巨大挑战。 无监督模型的在线评估:设计实时监控无监督模型性能的方法,及时发现模型退化。 工业控制系统安全:评估工业控制系统中无监督模型的异常检测能力。 车联网安全:评估车联网数据中无监督模型的威胁检测能力。 云安全:评估云环境中无监督模型的入侵检测和异常行为分析能力。 持续监控无监督模型的性能,及时发现模型退化。 探索新的无监督评估方法,适应不断变化的安全需求。 无监督结果评估是无监督学习在安全领域成功应用的关键。 建立基线模型:使用简单的基线模型作为参考,评估无监督模型的改进效果。 持续评估:建立持续评估机制,定期评估无监督模型的性能,及时发现模型退化。
安全风信子
2026-01-15
4520
标签:
如何理解无领导复制模型与复制延迟问题
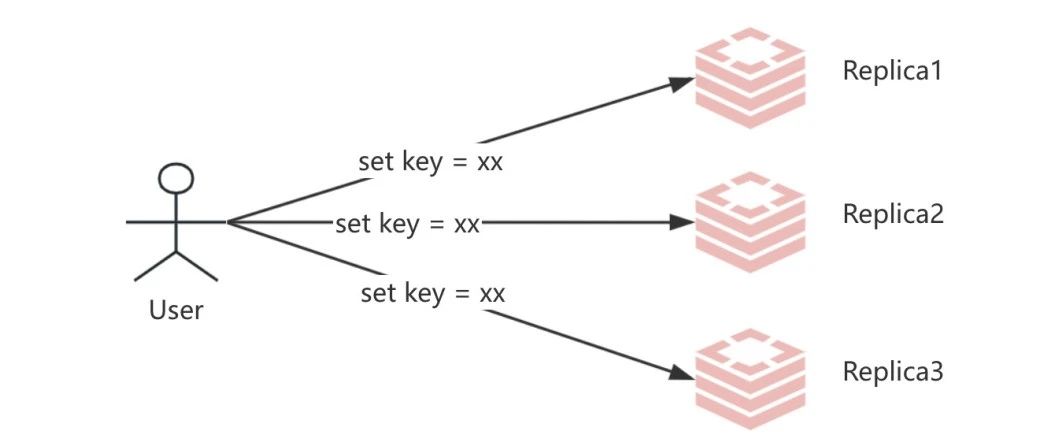
即每个Replica节点都能够接收客户端的读写操作,即使其中一个Replica节点发生故障,集群中的Replica也不需要进行自动故障转移.这就是我们的Leaderless Replication,即无领导复制算法模型 .我们熟悉的Dynamo以及Cassandra数据库均采用无领导复制模型. 假如现在有三个Replica副本中, 如果其中一个Replica不可用,在基于领导者复制模型中我们会做自动故障转移的方式,但是在无领导者复制模型中,其不存在故障转移,而是基于Quorum NWR机制 + 这种方式其实就是推的方式.同样以Replica3为例, 那么它将会收到Replica1以及Replica2节点的更新数据并进行修复: 其实上述就是Gossip协议中的一些反熵实现机制, 同时我们还看到无领导者复制模型是采用 Leaderless Replication 那我使用无领导者复制模型呢?
小坤探游架构笔记
2025-06-30
3770
标签:
真·无监督!延世大学提出图像到图像无监督模型,实验结果超SOTA
而近日韩国延世大学的一篇名为《Rethinking the Truly Unsupervised Image-to-Image Translation》的论文号称实现了真正的“无监督”学习。 后者往往被称为“无监督”,而这种方法还有一个重要的假设:域标签是先验的。 在这一部分中作者使用无监督聚类方法自动产生给定图像的域标签,也就是前面所说的最大化图像的域分配与其增强版本之间相互信息。 作者为了研究所提出的方法能够处理无监督的图像到图像的翻译,在AFHQ、FFHQ和LSUN CAR数据集上对模型进行了评估。 随着比值(γ)的降低,基线模型的性能显著下降,而作者提出的模型无论γ如何,都将FID值维持在60和45左右。 ?
AI科技评论
2020-06-17
1.4K0
标签:
无标注数据预测人脸识别模型偏差方法
无标注数据预测人脸识别模型偏差方法消除标注需求使偏差测试变得更加实用。近年来,算法偏差已成为AI各研究领域的核心议题。 测试人脸识别模型偏差的自然方法是向其输入来自不同群体的大量图像并观察其表现。但这需要标注图像中受试者身份的注释数据,而身份注释成本极高——特别是在需要 conclusive 评估人脸识别模型的规模下。 这一结果——能够在不需面部身份注释测试数据的情况下预测人脸识别模型的相对性能——令人惊讶,它提出了一种评估范式,应该使人脸识别软件的创建者测试模型偏差变得更加实用。 模型原理从带注释的训练数据中,人脸识别模型通常学习生成输入图像的向量表示——嵌入——并测量它们在嵌入空间中的相互距离。任何距离低于某个阈值的嵌入都被分类为表示同一个人。 从得到的分数中,我们的模型学习一对分布,一个用于匹配,一个用于非匹配,基于分布之间的分离,我们可以预测模型的准确性。我们对数据集中的每个人口类别重复此过程并比较结果。
用户11764306
2025-11-02
2530
标签:
问题归档专栏文章快讯文章归档关键词归档开发者手册归档开发者手册 Section 归档