
首页
学习
活动
专区
圈层
工具
发布
综合排序丨最热优先丨最新优先
时间不限
模型训练过程和国产算力面临的挑战
这表明,为了支撑人工智能应用的发展,系统软件的重要性不可忽视,而这也给国产算力系统带来了更多挑战。 国产算力面临的挑战 国产算力面临的挑战主要集中在系统软件方面。 学术界和工业界普遍认为,系统软件是影响国产硬件平台使用的关键因素。对于人工智能应用开发者来说,使用英伟达等GPU提供的软件栈非常方便,这些软件易于快速部署,可靠性高、可用性好,而且有大量用户群体。 相比之下,国产硬件平台的软件系统不够全面,对有些模型的支持不完善,有些模型甚至需要额外的工作才能支持。此外,不同的硬件平台使用不同的系统软件,用户群体分散,学习资料少,这无疑增加了用户的学习使用成本。 此外,为了支撑这些软件,算力系统还需要其他的系统软件。 通信库 为了支持多机多卡训练,机器之间需要时刻传输数据,导致通信成为训练过程中的重要性能瓶颈。 更加完整、易用、高效的系统软件对国产平台至关重要。系统软件的发展和优化也有助于推动人工智能研究和应用领域的进步,为开发人员提供更多灵活性和性能优势。
刘盼
2024-04-02
9020
标签:
17省市入选算力互联互通:算力网络采购,从”建算力“到”连算力“
1、“建算力”与“连算力”是两套逻辑建算力阶段的网络职责是提供管道:带宽够大、时延够低、价格合适,三条标准基本能覆盖。连算力阶段,算力要接入一张全国网络,被调度、被计量,网络要提供确定性。 它意味着,算力网络的采购标准正在从“企业自己定”变成“国家有要求”。2、把概念说清楚算力互联互通,是指通过网络连接多源异构、海量泛在的算力资源,实现算力入网入市、标识汇聚、互联调度。 它的目标是让算力像水电一样,能被找到、被调度、被计量。算力互联互通,指通过网络连接多源异构的算力资源,实现算力入网入市、标识汇聚与互联调度。落到采购上,它带来三个具体变化。 第二,与算力调度联动的编排能力。算力在不同云、不同区域之间调度时,网络需要跟随算力位置动态调整。 2026中国算力大会披露,中国算力平台已实现全国一体化算力统筹监测,算力超市注册企业超万家、上架产品2000多个、接入大模型300多个;国家算力互联互通区域(河北)节点于2026年9月12日启用,河北人工智能计算中心月平均算力使用率超过
多云行者
2026-09-17
1890
标签:
华为Atlas 350正式上市,算力碾压英伟达H20,国产算力要逆袭?
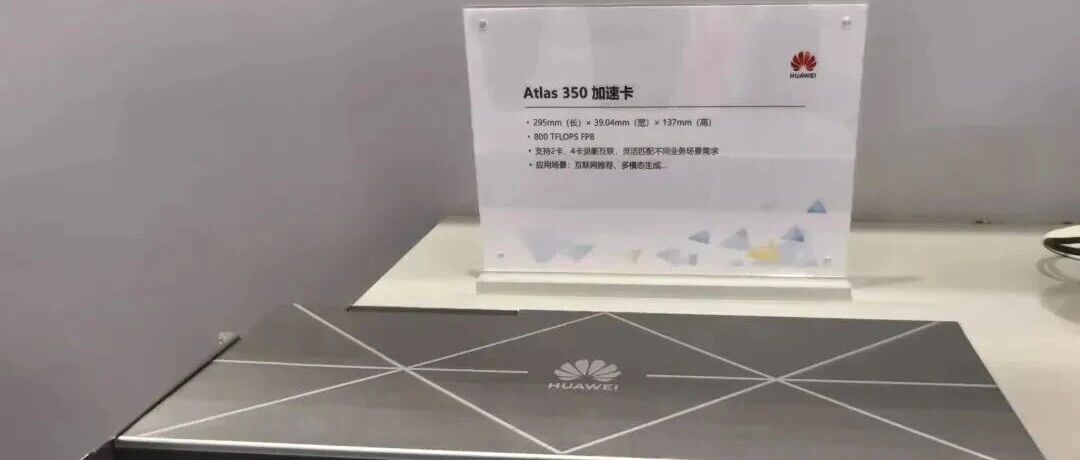
前言:华为亮出算力“王炸”,打破英伟达垄断,国产AI算力终迎突破 作为一个长期关注AI行业的博主,我相信很多同行跟我有一样的感受:国产AI算力就像被英伟达按在地上“卡脖子”,尤其是H20等芯片被限制后, 直到3月21日华为中国合作伙伴大会,华为重磅掏出搭载昇腾950PR处理器的Atlas 350加速卡,直接官宣正式上市,一出手就甩出碾压级的参数,那一刻,我心里只有一个念头:国产算力的翻身仗,终于要打响了 总的来说,这次Atlas 350的上市,绝不是一款普通产品的亮相,而是国产算力从“跟跑”到“领跑”的真正转折点。 不过不可否认,华为已经走出了一条属于国产算力的道路——不靠模仿,靠创新;不靠垄断,靠生态。 未来,随着昇腾960的规划落地,华为大概率会持续领跑国产算力,而这次Atlas 350的上市,只是国产算力逆袭的开始,也让我们真正看到了中国AI摆脱国外依赖的希望,这份底气,来之不易。
TechMiel
2026-03-31
2.5K0
标签:
又打脸了,国产AI算力生态真的全闭环了
这些声音每年都有,但我今天说的可能不太中听——寒武纪的万亿市值,恰恰说明国产算力卡的逻辑终于被资本市场认可了。你回想一下,三年前国产算力卡是什么处境? 而且现在,国产算力卡从技术上已经可以承接这个需求了。资本是在给确定性定价,不是在给概念炒作。02事实上,国产AI算力生态,早就不是单点突破了。 所以你看,从算力卡到基础设施、从大模型到应用,国产AI算力生态,已经真的全面闭环了。这不是某一条线的突破,是整个产业链的集体破圈。 ZStackAIOS出来,兼容几乎所有的国产算力卡并且统一高效调度,把AI基础设施的空白补上了。2025年,说国产算力卡没有突破。2026年,美团用国产卡全量训练模型上线,寒武纪万亿市值。 就是国产模型适配算力卡、国产算力卡跑在国产基础设施上、基础设施支撑应用、应用反哺模型迭代。四个环节一旦打通,飞轮就转起来了。这跟当年中国互联网的发展路径一模一样。
谢强byron
2026-07-01
3320
标签:
算力 – computation
文章目录 人工智能里的算力是什么? 在普通电脑中,CPU就提供了算力帮助电脑快速运行。玩游戏的时候需要显卡提供算力,帮助电脑快速处理图形。 而在 人工智能中,需要有类似CPU和GPU的硬件来提供算力,帮助算法快速运算出结果。 之前在算法里讲过,在制造木桌的过程中,工厂的流水线就是算法。 在那个例子中,工厂中的机器就像算力,机器越好越先进,制造的过程就越快。 ? 算力越大,速度越快 维基百科版本 Techpedia版本 算力是使用计算机技术完成给定目标导向任务的过程。 算力可以包括软件和硬件系统的设计和开发,用于广泛的目的 – 通常构建,处理和管理任何类型的信息 – 以帮助追求科学研究,制作智能系统,以及创建和使用不同的媒体娱乐和交流。 查看详情 维基百科版本 算力是使用计算机的任何活动。它包括开发硬件 和软件,以及使用计算机来管理和处理信息,进行交流和娱乐。算力是现代工业技术的一个至关重要的组成部分。
easyAI
2019-12-18
2.8K0
标签:
WAIC满场超节点,国产算力不再只有一个答案
短短一年,超节点从少数厂商押注的前沿架构,变成了国产算力公司的集体选择。展台上的数字也越来越大:40卡、64卡、128卡、1024卡,甚至4096颗芯片。 路线虽然不同,面对的都是同一个挑战:芯片数量增加以后,通信开销会不会吃掉新增的算力。 内存决定芯片拿数据时要等多久。 算力很强,但数据送不过来,计算芯片仍然会空转。 结语 本届WAIC摆满超节点的展馆,证明国产算力已经有能力提供多种选择。但从“有得选”走向“选了以后不会被困住”,还需要更开放的标准、更成熟的软件,以及更长时间的真实运行。 去年我们关心的是,国产厂商能不能造出超节点。 今年更值得关心的,是这些看起来都很强的超节点,最终会连接成一个生态,还是变成一座座彼此隔离的算力孤岛。
科技旋涡
2026-07-21
6690
标签:
算力之后,“存力”上位
当算力芯片的摩尔定律逐渐逼近物理极限,存力开始从幕后走向台前,成为AI领域下一个关键赛点。 长期以来,伴随企业数字化转型所建设的“烟囱式”AI基础设施各自为战,数据奔流,价值却困于“堰塞湖”。 存力中心作为新型的数据基础设施,正成为AI时代数据流通和融合应用的破题关键。 AI时代的 “数据决定论” AI技术的发展离不开三大要素:数据、算法和算力。 在训练方面,高性能并行文件系统可以提升大模型训练效率,超大带宽和容量支持超万卡集群无瓶颈扩展,EB级扩展能力适应海量数据,加速卡直通技术使数据从存储到算力“一跳直达”。 构建AI时代新型 “数据粮仓” 与算力聚焦在“算”不同,数据存力聚焦在“数”和“存”,是数据生产要素处理的综合能力体现,肩负着为数字经济各种场景提供源源不断的“生产资料”的使命。 将目光投向更长远,新型AI存储很可能是撬动人工智能时代杠杆的另一个支点,“以存强算”“以数助算”亦是弯道超车的重要落点。当AI产业具备扎实的存力底座,才能登高远眺,看见AI时代最美的风景。
科技云报道
2025-06-19
7220
标签:
算力共享:环形结构的算力分配策略
​目录算力共享:环形结构的算力分配策略方法签名方法实现注意事项nodes.sort(key=lambda x: (x[1].memory, x[0]), reverse=True)end = round (start + (node[1].memory / total_memory), 5)算力共享:环形结构的算力分配策略这段代码定义了一个名为RingMemoryWeightedPartitioningStrategy
zhangjiqun
2024-07-26
1.7K0
标签:
金融智算演进:基于异构算力与推理加速的国产GPU全栈落地路径
数据来源: 腾讯全球数字生态大会城市峰会,主讲人罗方华(浪潮集团) 一、 应对算力封锁与推理时代的双重挑战 金融行业正面临从“模型训练”向“大规模推理”转型的战略拐点,同时叠加外部供应链限制,导致算力基础设施建设面临多重瓶颈 算力规模门槛高: LO级预训练及L1级行业大模型训练需千卡级算力规模,中小客户难以独立支撑超节点方案建设。 二、 构建异构算力纳管与全栈推理服务 针对金融行业的复杂需求,通过“算力基建+平台+网关”的三层架构提供解决方案: 异构算力底座: 针对2026年国产GPU发展(预测显存带宽达HBM3E、支持FP8/FP4 四、 某银行国产算力替代与业务落地 客户背景: XX银行 实施规模: 已部署近500张沐曦C500 GPU,扩容建设国产推理算力池。 五、 技术领先性与生态展望 全场景兼容: 实现传统AI算力(英伟达+国产)全场景覆盖,支持从OCR、客服到生物识别的多样化需求,提供从LSTM模型到FP32单精度矢量算力的完整支持。
IT资讯研究所
2026-06-01
1.2K0
标签:
国产GPU新突破,单卡FP8算力突破1000T!
马年农历春节前夕,国产智算卡再度迎来好消息!单卡FP8算力终于冲上1000TFLOPS了。 这不仅是国产GPU首次在单卡吞吐量上摸到国际顶尖门槛,更是为万亿参数大模型提供了真正可用的自主算力底座。 一、 核心参数对标:1000TFLOPS与全精度覆盖 MTT S5000在设计之初便定位于“训推一体”的全功能基座,其硬件参数展现了极强的竞争优势: ●算力峰值: S5000单卡AI算力(FP8)最高可达 PyTorch、vLLM等主流框架的原生适配,S5000不仅能实现CUDA生态代码的“零成本”迁移,更凭借其80GB显存和1.6TB/s带宽的参数底蕴,为GLM-5等万亿参数模型的快速迭代提供了坚实的国产算力支撑 S5000的不俗表现,加上“花港”架构所展现的技术纵深,已为国产算力的持续进化打开更多想象空间。 编辑:芯智讯-浪客剑
芯智讯
2026-03-19
1.3K0
标签:
问题归档专栏文章快讯文章归档关键词归档开发者手册归档开发者手册 Section 归档